AI agent 를 효율적으로 쓰기 (1) - harness, Agent Skills, 그리고 context 관리
요즘 AI 관련 글을 보다 보면 harness, context engineering, progressive disclosure 같은 단어가 자주 보인다. 전부 “모델 자체”가 아니라 “모델을 둘러싼 구조”에 대한 이야기다. 모델 성능이 어느 정도 평준화되면서 결국 차이를 만드는 건 모델에게 무엇을 언제 보여주느냐로 옮겨갔기 때문이다.
이 글에서는 harness 가 무엇인지, context window 가 왜 비용이자 성능인지, Agent Skills 가 그 문제를 어떤 구조로 푸는지, 그리고 실제로 skill 과 ECC 를 설치하고 prompt 와 token 을 관리하는 방법까지 정리한다. skill 을 직접 만드는 과정은 (2) Agent Skills 직접 만들기 에서 따로 다룬다.
harness - model 과 agent 사이에 있는 것
LLM 자체는 상태가 없다. 요청이 들어오면 주어진 텍스트를 보고 다음 텍스트를 생성하고 끝난다. 파일을 읽지도, 이전 대화를 기억하지도, tool 을 실행하지도 않는다.
harness 는 그 모델을 감싸서 실제로 일을 하게 만드는 소프트웨어 전체를 가리킨다. orchestration loop, tool 실행, memory, context 관리, state 유지, error handling, guardrail 이 전부 여기에 들어간다. Anthropic 도 Claude Agent SDK 를 “Claude Code 를 구동하는 agent harness” 라고 설명한다.
정리하면 이렇게 된다.
1
agent = model + harness
이 구분이 중요한 이유는, agent 가 실패했을 때 원인이 모델이 아닌 경우가 훨씬 많기 때문이다. 필요한 파일을 못 읽어서, 이전 단계 결과를 잃어버려서, tool 설명이 애매해서 실패한다. 전부 harness 영역의 engineering 문제다.
context window 는 공짜가 아니다
harness 가 다루는 자원 중 가장 비싼 건 context window 다. 개발자 입장에서는 RAM 으로 생각하면 이해가 빠르다. 빠르지만 용량이 정해져 있고, 아무거나 올려두면 정작 필요한 게 들어갈 자리가 없다.
여기에 두 가지 비용이 동시에 걸린다.
첫째는 금전적 비용이다. system prompt, 메시지, tool 정의, tool 실행 결과가 전부 token 으로 계산된다. 시작할 때 올려둔 tool metadata 는 매 요청마다 다시 청구된다.
둘째는 성능이다. token 이 늘어날수록 모델의 recall 과 정확도가 떨어지는 현상이 관찰되는데, 이걸 context rot 이라고 부른다. 즉 “일단 다 넣어두면 똑똑해지겠지”가 성립하지 않는다. 오히려 반대다.
Anthropic 의 context engineering 가이드가 제시하는 목표는 명확하다. 원하는 결과를 낼 확률을 최대로 만드는, 가능한 한 작은 고신호 token 집합을 찾는 것이다.
Agent Skills - 필요할 때만 꺼내 쓰는 구조
Agent Skills 는 2025년 10월에 Anthropic 이 공개했고, 2025년 12월에 플랫폼 간 이식이 가능한 open standard 로 발표됐다.
실체는 단순하다. SKILL.md 파일이 들어있는 디렉터리 하나다. 거기에 참고 문서와 script 를 같이 묶을 수 있다. 특별한 runtime 도, 등록 API 도 필요 없다. agent 가 파일을 읽을 수 있으면 그게 전부다.
핵심은 이 폴더를 “언제 context 에 올리느냐”를 단계로 쪼갰다는 점이다. 이걸 progressive disclosure 라고 한다. 원래 Jakob Nielsen 이 UI 설계 원칙으로 정리한 개념인데, 지금 당장 필요한 것만 보여주고 나머지는 뒤로 미룬다는 아이디어를 그대로 context window 에 적용한 것이다.
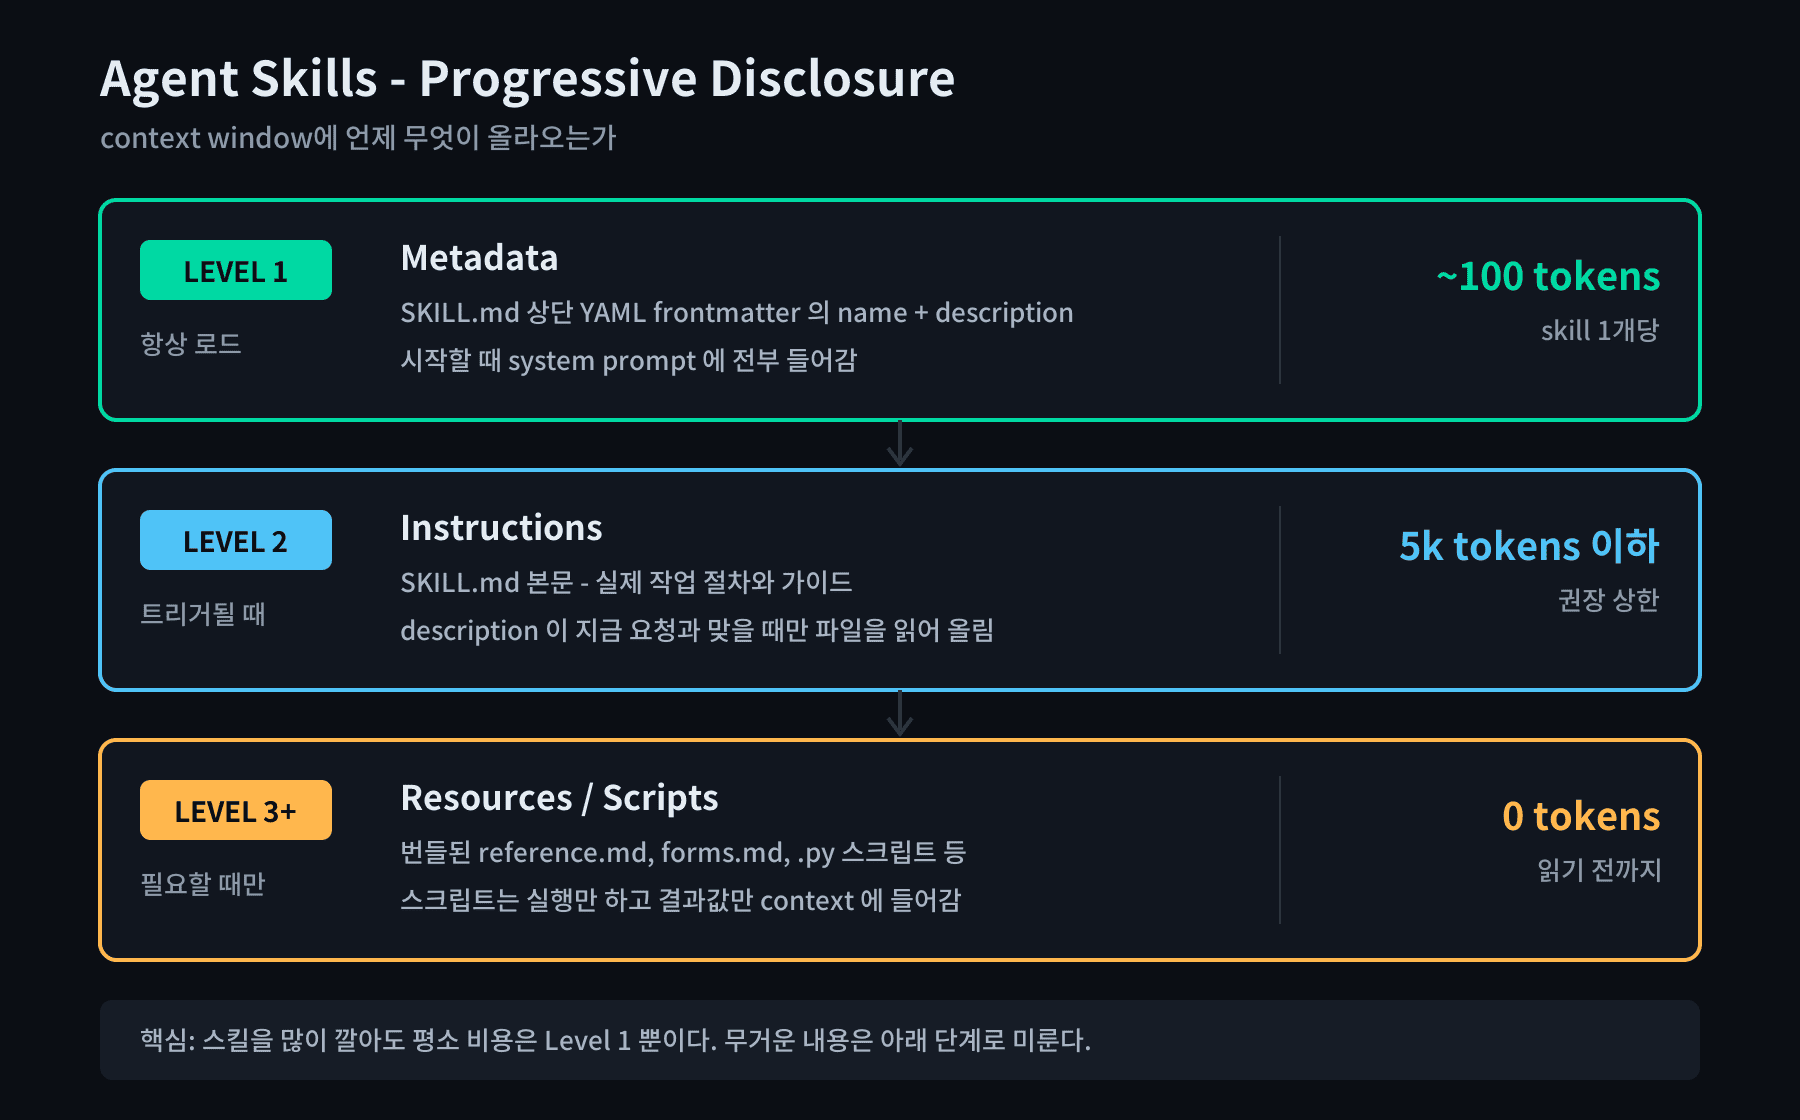
Level 1 - Metadata
SKILL.md 맨 위의 YAML frontmatter 에 있는 name 과 description 이다. 이것만 시작 시점에 system prompt 에 들어간다.
skill 하나당 대략 100 token 수준이다. 그래서 skill 을 수십 개 설치해도 평소에 드는 비용은 거의 없다. 이 단계에서 모델이 하는 일은 하나뿐이다. 지금 요청이 이 description 과 맞는지 판단하는 것.
Level 2 - Instructions
description 이 현재 작업과 맞는다고 판단되면, 그때 모델이 bash 로 SKILL.md 본문을 읽어 올린다. 실제 작업 절차와 가이드가 여기 들어있다.
Anthropic 의 권장 상한은 5k token 이하다. 본문이 그보다 커지면 파일을 쪼개서 아래 단계로 내리라는 뜻이다.
Level 3+ - Resources 와 Scripts
SKILL.md 에서 이름으로 참조하는 번들 파일들이다. reference.md, forms.md 같은 추가 문서, 그리고 .py script 가 여기 해당한다.
이 단계의 비용은 읽기 전까지 0 이다. 그래서 skill 안에 방대한 API 레퍼런스나 예제를 넣어도 안 쓰이면 아무 부담이 없다.
script 는 한 단계 더 유리하다. 모델이 bash 로 실행만 하고 결과값만 context 에 들어온다. 코드 본문은 아예 올라오지 않는다. 정렬 같은 작업을 token 생성으로 흉내내는 것보다 그냥 알고리즘을 실행하는 쪽이 싸고, 무엇보다 결과가 결정적이라 매번 같다.
SKILL.md 의 최소 구조
필수 요소는 frontmatter 의 name 과 description 두 개뿐이다.
1
2
3
4
---
name: pdf-processing
description: PDF 에서 텍스트와 표를 추출하고, 양식을 채우고, 문서를 병합한다. PDF 파일을 다루거나 사용자가 PDF, 양식, 문서 추출을 언급할 때 사용한다.
---
필드 제약은 다음과 같다.
- name: 최대 64자, 소문자와 숫자와 하이픈만, anthropic 과 claude 는 예약어라 쓸 수 없다
- description: 비어있으면 안 되고 최대 1024자
여기서 실무적으로 제일 중요한 건 description 이다. Level 1 에서 모델이 보는 정보가 이것뿐이기 때문에, skill 이 발동할지 말지가 전적으로 이 한 줄에 달려있다.
그래서 description 에는 “무엇을 하는지”와 “언제 써야 하는지”가 둘 다 들어가야 한다. 무엇을 하는지만 적으면 모델이 발동 시점을 판단할 근거가 없다. 반대로 범위를 너무 넓게 잡으면 엉뚱한 상황에서 발동해 오히려 context 를 낭비한다.
같은 skill 의 description 을 세 가지로 써보면 차이가 보인다.
1
2
3
4
5
6
7
8
# 너무 짧다. 무엇을 하는지도, 언제 쓰는지도 알 수 없다
description: 블로그 도우미

# 너무 넓다. 문서 작업이면 전부 걸린다
description: 글을 쓰거나 문서를 다룰 때 사용한다

# 무엇을 하는지와 언제 쓰는지가 둘 다 있다
description: Jekyll 블로그 포스트의 문체와 구조 규칙을 적용하고 lint script 로 검증한다. _posts 아래 markdown 을 쓰거나 고치거나 검토할 때 사용한다.
마지막 예시는 _posts 라는 구체적인 경로와 “쓰거나 고치거나 검토할 때”라는 동작이 들어있어서, 모델이 지금 요청과 맞는지 판단하기 쉽다.
Claude Code 는 표준보다 조금 느슨하다. name 을 생략하면 디렉터리 이름을 쓰고, 표준에 없는 필드도 몇 가지 더 받는다. 자주 쓰는 것만 추리면 이렇다.
disable-model-invocation: true: 모델이 알아서 발동하지 못하게 막는다. 배포처럼 사람이 직접 부를 때만 실행돼야 하는 skill 에 쓴다allowed-tools: skill 이 실행되는 동안 권한 확인 없이 쓸 수 있는 tool 을 지정한다paths: 특정 파일 패턴을 다룰 때만 자동 발동되게 범위를 좁힌다
본문은 그냥 markdown 이다. 신입에게 주는 온보딩 문서를 쓴다고 생각하면 된다.
Skill 설치하기
설치 방법은 어디서 쓰느냐에 따라 다르다. 공통점은 없고, 쓰려는 환경마다 따로 올려야 한다.
Claude Code
파일시스템 기반이라 디렉터리에 폴더를 넣으면 끝이다. 업로드도 등록도 없다.
1
2
~/.claude/skills/<skill-name>/SKILL.md    # 개인용, 모든 프로젝트에서 사용
.claude/skills/<skill-name>/SKILL.md      # 프로젝트용, 저장소에 커밋해 팀과 공유
직접 만든다면 폴더를 만들고 SKILL.md 를 쓰면 된다. 실제로 만드는 과정은 (2) 에서 다룬다.
1
2
mkdir -p ~/.claude/skills/blog-post
# SKILL.md 작성 후 저장
설치한 skill 은 /skills 로 목록을 확인할 수 있다. description 이 맞으면 모델이 알아서 꺼내 쓰지만, /blog-post 처럼 이름을 직접 입력해서 부를 수도 있다. 예전의 custom slash command (.claude/commands/*.md) 도 지금은 skill 로 합쳐져서, 같은 이름이면 둘 다 /이름 으로 실행된다.
claude.ai
Settings 의 기능 메뉴에서 zip 파일로 업로드한다. code execution 이 켜져 있어야 하고, Pro 이상 플랜에서 쓸 수 있다.
주의할 점은 claude.ai 의 custom skill 은 개인 단위라는 것이다. 조직 전체에 배포하거나 관리자가 중앙에서 관리하는 기능은 없다. 팀원마다 각자 올려야 한다.
API
Skills API 로 업로드하고, code execution tool 과 함께 호출한다. 업로드한 skill 은 workspace 단위로 공유된다.
API 환경은 제약이 있다. 샌드박스 컨테이너에서 돌기 때문에 네트워크 접근이 없고, runtime 에 패키지를 설치할 수도 없다. 미리 설치된 패키지만 쓸 수 있으니 skill 을 설계할 때 이 범위 안에서 동작하도록 맞춰야 한다.
surface 간 동기화는 없다
claude.ai 에 올린 skill 은 API 에서 쓸 수 없고, Claude Code 의 skill 은 양쪽 모두와 별개다. 같은 skill 을 세 군데서 쓰려면 세 번 올려야 한다.
ECC - 남이 만들어둔 harness 설정을 통째로 가져오기
ECC 는 Everything Claude Code 의 약자로, Affaan Mustafa 가 만든 MIT 라이선스 오픈소스다. 원래 Claude Code 위에 얹는 설정 레이어로 시작했고, 지금은 Codex, Cursor, OpenCode, Gemini CLI 같은 다른 harness 에도 adapter 를 제공한다. skill 과 agent 와 hook 을 미리 만들어 묶어둔 꾸러미라고 보면 된다. Anthropic 과는 무관한 서드파티 프로젝트다.
무엇이 들어있나
이 글을 쓰는 시점의 최신 릴리스는 v2.2.3 (2026년 10월) 이고, 구성은 다음과 같다. 릴리스마다 숫자가 꽤 바뀌니 설치 전에 README 를 한 번 확인하는 게 좋다.
- Skills: 311개의 markdown 워크플로. TDD, 리서치, 보안 리뷰, 프레임워크별 패턴 등
- Agents: 71개의 전문 sub-agent. planner, architect, code-reviewer, security-reviewer 같은 역할별로 나뉘고 각자 tool 허용 목록과 별도 context 를 가진다
- Commands: 97개의 slash command. skill 중심 구조로 옮겨가는 중이라 legacy shim 으로 남아있다
- Hooks: tool 이벤트와 세션 경계에서 실행된다. Stop hook 이 세션 요약을 쓰고, SessionStart hook 이 이전 맥락을 불러온다
- Instincts: 반복된 패턴을 confidence score 와 함께 저장하고, 쌓이면 skill 로 묶는 학습 시스템
- AgentShield: prompt, hook, MCP 설정, 권한, secret 을 검사하는 보안 스캐너
설치
설치 전에 저장소 최상단의 the-shortform-guide.md 를 먼저 읽어보길 권한다. 만든 사람이 skill, hook, sub-agent, rules, MCP 를 실제로 어떻게 쓰는지 정리한 문서라서, 무엇을 가져올지 고르는 기준이 생긴다. context 와 token 관리를 더 깊게 다룬 the-longform-guide.md, agent 보안을 다룬 the-security-guide.md 도 같이 있다.
설치는 공식 채널에서만 한다. README 에 GitHub 저장소, npm 의 ecc-universal 과 ecc-agentshield, plugin 이름 ecc@ecc 외의 재업로드나 미러에는 malware 가 있을 수 있다는 경고가 적혀 있다. star 가 많은 프로젝트일수록 이름을 흉내낸 가짜가 생긴다.
Claude Code 2.1 이상, Node.js 18 이상, Git 이 필요하다. v2.2 부터는 대화형 setup 마법사가 권장 경로다.
1
npx ecc-universal@2.2.3 setup
마법사가 설치 scope (user, project, local) 와 hook profile 을 물어보고 ecc@ecc plugin 을 설치해준다. 업데이트나 설정 변경도 같은 명령을 다시 실행하면 된다. 버전을 고정해서 실행하는 것도 권장 사항인데, README 에서도 버전 고정이 보안 검증은 아니라고 분명히 적어두고 있다.
Claude Code 안에서 plugin 명령으로 직접 설치해도 결과는 같다.
1
2
/plugin marketplace add https://github.com/affaan-m/ECC
/plugin install ecc@ecc
여기서 함정이 하나 있다. rules 는 plugin 으로 배포되지 않아서 수동으로 복사해야 한다. rules 는 매 세션 상시 로드되는 context 라서, common 과 실제로 쓰는 언어 하나만 가져오라고 README 도 권한다. Swift 프로젝트라면 이렇게 된다.
1
2
3
4
5
git clone https://github.com/affaan-m/ECC.git
cd ECC
mkdir -p ~/.claude/rules/ecc
cp -R rules/common ~/.claude/rules/ecc/
cp -R rules/swift ~/.claude/rules/ecc/
plugin 을 쓰지 않고 installer 로 설치할 수도 있다. 이때는 hook 을 켤지 끌지를 반드시 명시해야 한다. --enable-hooks 나 --no-hooks 가 없으면 installer 가 hook 이 하는 일을 출력하고 아무것도 쓰지 않은 채 멈춘다.
1
2
3
4
git clone https://github.com/affaan-m/ECC.git
cd ECC
./install.sh --profile core --enable-hooks --target claude --dry-run
./install.sh --profile core --enable-hooks --target claude
첫 줄의 --dry-run 은 실제로 쓰지 않고 어떤 파일이 어디에 설치될지만 보여준다. 남의 설정을 내 ~/.claude 에 쏟아붓기 전에 한 번 보는 게 좋다.
install profile 은 minimal, core, developer, security, research, full 이 있다 (OpenCode 전용 opencode profile 은 별도). minimal 은 hook runtime 없이 rules, agents, commands 만, core 는 hook 포함 기본 구성, developer 는 일반 앱 개발용, full 은 전부다. hook 의 강도는 이것과 별개로 minimal, standard, strict 중에서 고르고 기본값은 standard 다.
필요한 skill 만 골라서 넣는 것도 된다. 무엇이 있는지 모르겠으면 consult 로 먼저 물어본다. 하려는 일을 적으면 맞는 구성요소와 설치 명령을 알려준다.
1
2
node scripts/ecc.js consult "security reviews" --target claude
./install.sh --target claude --skills tdd-workflow,security-review
plugin 설치와 installer 설치를 겹쳐서 하면 skill 과 hook 이 중복되니 한쪽만 써야 한다. 설치 후 확인은 이렇게 한다.
1
2
3
/plugin list ecc@ecc
node scripts/ecc.js doctor
node scripts/ecc.js repair
솔직한 평가
ECC 는 지금 커뮤니티 의견이 꽤 갈리는 프로젝트다. 양쪽 주장을 다 적어둔다.
비판 쪽의 요지는 과잉 설계다. agent 70여 개에 skill 300여 개, 여러 갈래의 설치 경로, install profile 과 hook profile, 환경변수 다수를 익히는 비용이 얻는 것보다 크다는 지적이다. 릴리스마다 숫자가 계속 불어나는 것 자체가 이 비판을 강화한다. 가장 자주 보이는 반응이 “대부분은 잘 쓴 CLAUDE.md 하나면 되지 생태계 전체가 필요하진 않다”는 것이다. v2.2 에서 setup 마법사가 생기면서 설치는 한결 나아졌지만, 여전히 rules 는 수동 복사가 필요하고 설치 방법을 겹치면 hook 이 중복 실행되는 문제가 있다. star 수가 많다는 점도 바이럴 효과라는 회의론이 있다.
옹호 쪽은 시간 절약과 학습 자료로서의 가치를 든다. ECC 를 쓰지 않는 사람도 거기 담긴 agent 와 skill 패턴을 참고한다는 평가가 있고, code-reviewer agent 처럼 잘 만들어진 모듈은 따로 떼어 쓸 만하다는 데에는 비판하는 쪽도 대체로 동의한다.
그리고 중요한 점 하나. 효율 관련 주장에 정량적 벤치마크가 없다. token 을 얼마나 아껴준다는 수치는 어디에도 제시돼 있지 않다.
개인적인 결론은 이렇다. 처음부터 full 로 통째로 깔 이유는 없다. 저장소를 열어서 code-reviewer agent 나 TDD skill 처럼 당장 필요한 모듈 한두 개만 읽고 가져오는 쪽이 낫다. 그 과정에서 skill 과 agent 를 어떻게 쓰는지 배우는 게 실제 수확이다.
무엇을 언제 쓰는가
같은 목적을 CLAUDE.md, skill, MCP, sub-agent 네 가지로 달성할 수 있는데 context 비용이 전부 다르다. 여기를 헷갈리면 아무리 prompt 를 다듬어도 소용이 없다.
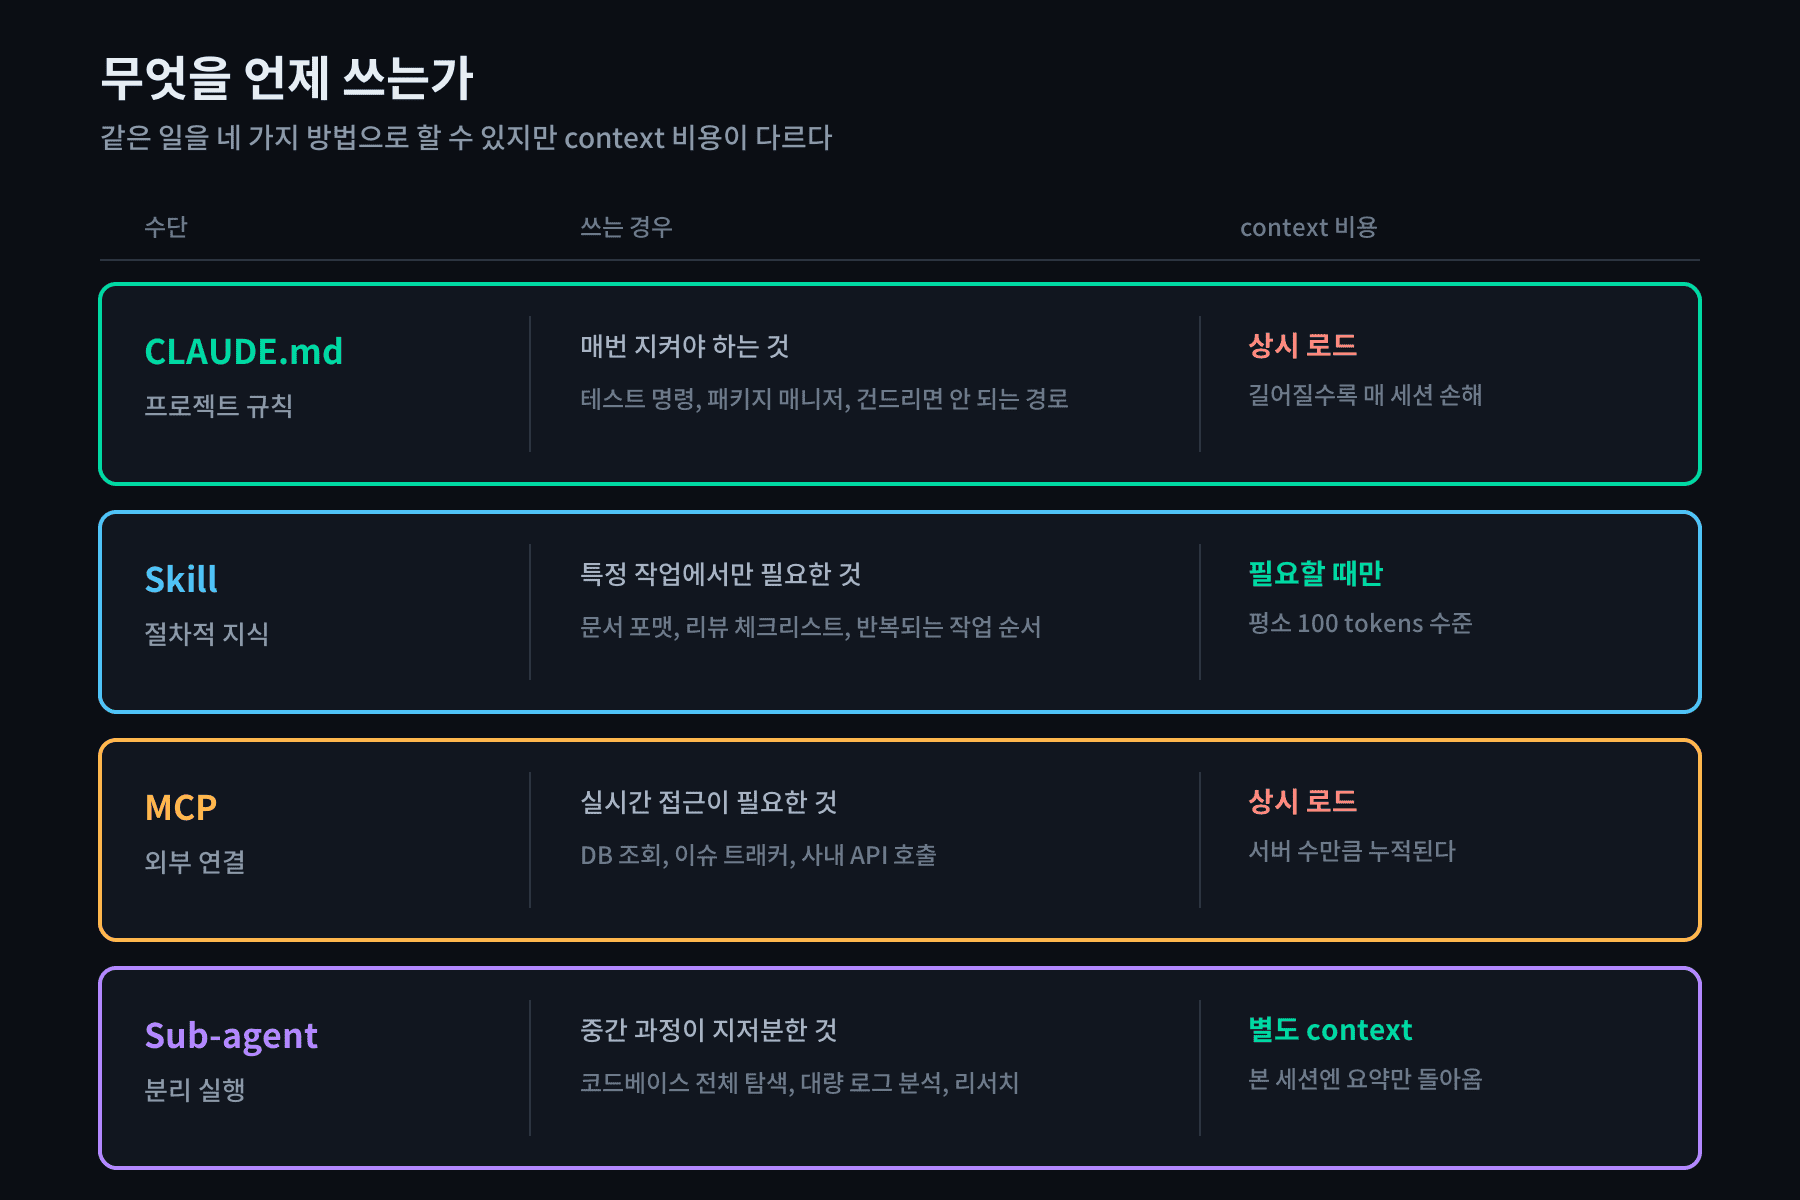
CLAUDE.md 와 MCP 는 상시 로드다. 매 세션마다 비용이 나간다. 그래서 CLAUDE.md 는 짧게 유지해야 하고, 안 쓰는 MCP 서버는 꺼두는 게 맞다.
skill 과 sub-agent 는 필요할 때만 비용이 생긴다. 그래서 특정 상황에서만 필요한 지식은 CLAUDE.md 가 아니라 skill 로 내리는 게 맞고, 중간 과정이 지저분한 탐색 작업은 sub-agent 에게 맡기는 게 맞다.
MCP 와 skill 을 경쟁 관계로 보는 글이 많은데 해결하는 문제가 다르다. MCP 는 외부 시스템과의 연결 규약이고, skill 은 절차적 지식을 담는 폴더다. 그래서 “우리 팀 코드 리뷰 체크리스트”는 skill 이 맞고 “Jira 에서 이번 스프린트 이슈 가져오기”는 MCP 가 맞다. 둘을 같이 쓰는 것도 자연스럽다. skill 이 MCP tool 을 어떤 순서로 호출할지 가르치는 식이다.
효율적인 prompt
Anthropic 은 prompt engineering 과 context engineering 을 구분한다. prompt engineering 이 지시문을 어떻게 쓸지의 문제라면, context engineering 은 추론 시점에 모델이 보는 것 전체를 큐레이션하는 문제다. tool, 데이터, 메시지 히스토리가 전부 포함된다. 즉 전자가 후자의 부분집합이다.
고도를 맞춘다
가장 자주 언급되는 개념이 “right altitude” 다. 너무 낮으면 if-else 를 하드코딩한 것처럼 깨지기 쉽고, 너무 높으면 공유되지 않은 맥락을 가정한 모호한 지시가 된다. 그 사이를 맞추라는 뜻이다.
예를 들어 SwiftUI 화면의 로딩 처리를 고치게 한다고 해보자. 너무 높은 고도는 이렇다.
1
로딩 화면 좀 개선해줘.
무엇이 문제인지, 어느 화면인지, 어떻게 되면 끝인지가 전부 빠져 있다. 모델은 저장소를 훑으며 추측할 수밖에 없다.
반대로 너무 낮은 고도는 이렇다.
1
2
3
ProfileView.swift 42번째 줄에 if isLoading 을 추가하고,
그 안에 ProgressView() 를 넣고, else 에는 기존 코드를 넣고,
isLoading 은 @State 로 선언하고 기본값은 false 로 하고...
이러면 모델은 타이핑만 대신 해주는 도구가 된다. 이미 ViewModel 에 loading 상태가 있다는 사실 같은, 더 나은 판단을 할 여지가 없어진다.
적당한 고도는 목표와 제약을 주고 방법은 맡기는 쪽이다.
1
2
3
4
5
6
ProfileView 에서 API 응답을 기다리는 동안 빈 화면이 1-2초 보인다.
그 사이에 로딩 상태가 보이게 해줘.

- 상태는 ProfileViewModel 에 이미 있는 것을 우선 활용한다
- 다른 화면의 로딩 처리 방식이 있으면 그것과 맞춘다
- ProfileView.swift 와 ProfileViewModel.swift 외에는 수정하지 않는다
실무적으로는 작게 시작하는 쪽이 유리하다. 강한 모델에 최소한의 지시만 주고 돌려본 다음, 실제로 관찰된 실패를 고치는 지시만 추가한다. 일어나지 않은 실패를 미리 막으려고 쓴 규칙이 prompt 를 망치는 주범이다.
구조를 준다
섹션을 XML 태그나 markdown 헤더로 명확히 나눈다. 모델이 “이 부분은 제약이고 이 부분은 예시”라는 걸 구분할 수 있게 하는 것만으로 결과가 달라진다.
특히 배경 설명, 붙여넣은 로그, 실제 지시가 한 덩어리로 섞이면 모델이 로그 안의 문장을 지시로 착각하기도 한다. 태그로 경계를 그어주면 이런 혼동이 줄어든다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
<context>
iOS 17 이상, SwiftUI + Observation 을 쓰는 앱이다.
네트워크 계층은 Networking/APIClient.swift 에 있다.
</context>

<task>
아래 crash log 의 원인을 찾고 수정 방법을 제안해줘.
코드는 아직 수정하지 말고 원인 분석과 수정안만 달라.
</task>

<log>
Fatal error: Unexpectedly found nil while unwrapping an Optional value
APIClient.swift:87
...
</log>
“코드는 아직 수정하지 말고” 같은 한 줄도 중요하다. 분석과 수정을 한 번에 시키면 원인이 틀렸을 때 엉뚱한 수정까지 되돌려야 한다.
예시는 적고 다양하게
few-shot 예시는 여전히 강력하다. 다만 엣지 케이스 규칙을 길게 나열하는 것보다, 전형적이면서 서로 다른 예시 몇 개를 주는 쪽이 낫다.
커밋 메시지 형식을 맞추게 하는 경우를 보자. 규칙을 열 줄 쓰는 것보다 서로 다른 유형의 예시 세 개가 더 잘 통한다.
1
2
3
4
5
커밋 메시지를 아래 예시와 같은 형식으로 작성해줘.

feat(profile): 프로필 화면에 로딩 상태 표시
fix(api): 토큰 만료 시 재시도 무한 루프 수정
refactor(network): APIClient 의 에러 매핑을 enum 으로 분리
세 예시가 feat, fix, refactor 로 서로 다르다는 점이 핵심이다. 셋 다 feat 였다면 모델은 모든 커밋을 feat 로 쓰는 쪽으로 기울 수 있다.
검증 기준을 먼저 말한다
작업을 시키기 전에 무엇이 성공인지를 명시하면 왕복이 줄어든다. 통과해야 할 테스트 이름, 기대 출력, 건드리면 안 되는 파일을 미리 적어두는 식이다. 모호한 요청은 모델이 저장소 전체를 훑게 만들고, 그게 가장 비싼 실패 패턴이다.
1
2
3
4
5
6
7
8
9
10
LoginViewModel 의 이메일 검증 로직을 정규식에서 별도 Validator 타입으로 분리해줘.

시작 파일: Features/Login/LoginViewModel.swift

완료 조건:
- LoginViewModelTests 가 전부 통과한다
- EmailValidatorTests 를 새로 만들고, 빈 문자열과 공백 포함 케이스를 넣는다
- 기존 public API (validate(email:)) 의 시그니처는 바꾸지 않는다

건드리지 말 것: Features/Signup 디렉터리
시작 파일을 지정하는 한 줄만으로도 탐색 비용이 크게 준다. 모델이 “이메일 검증이 어디 있지” 하고 grep 을 반복하는 단계를 건너뛸 수 있기 때문이다.
긴 작업에서의 context 관리
작업이 길어지면 어떤 prompt 를 쓰든 context 가 찬다. 그때 쓰는 방법은 크게 세 가지다.
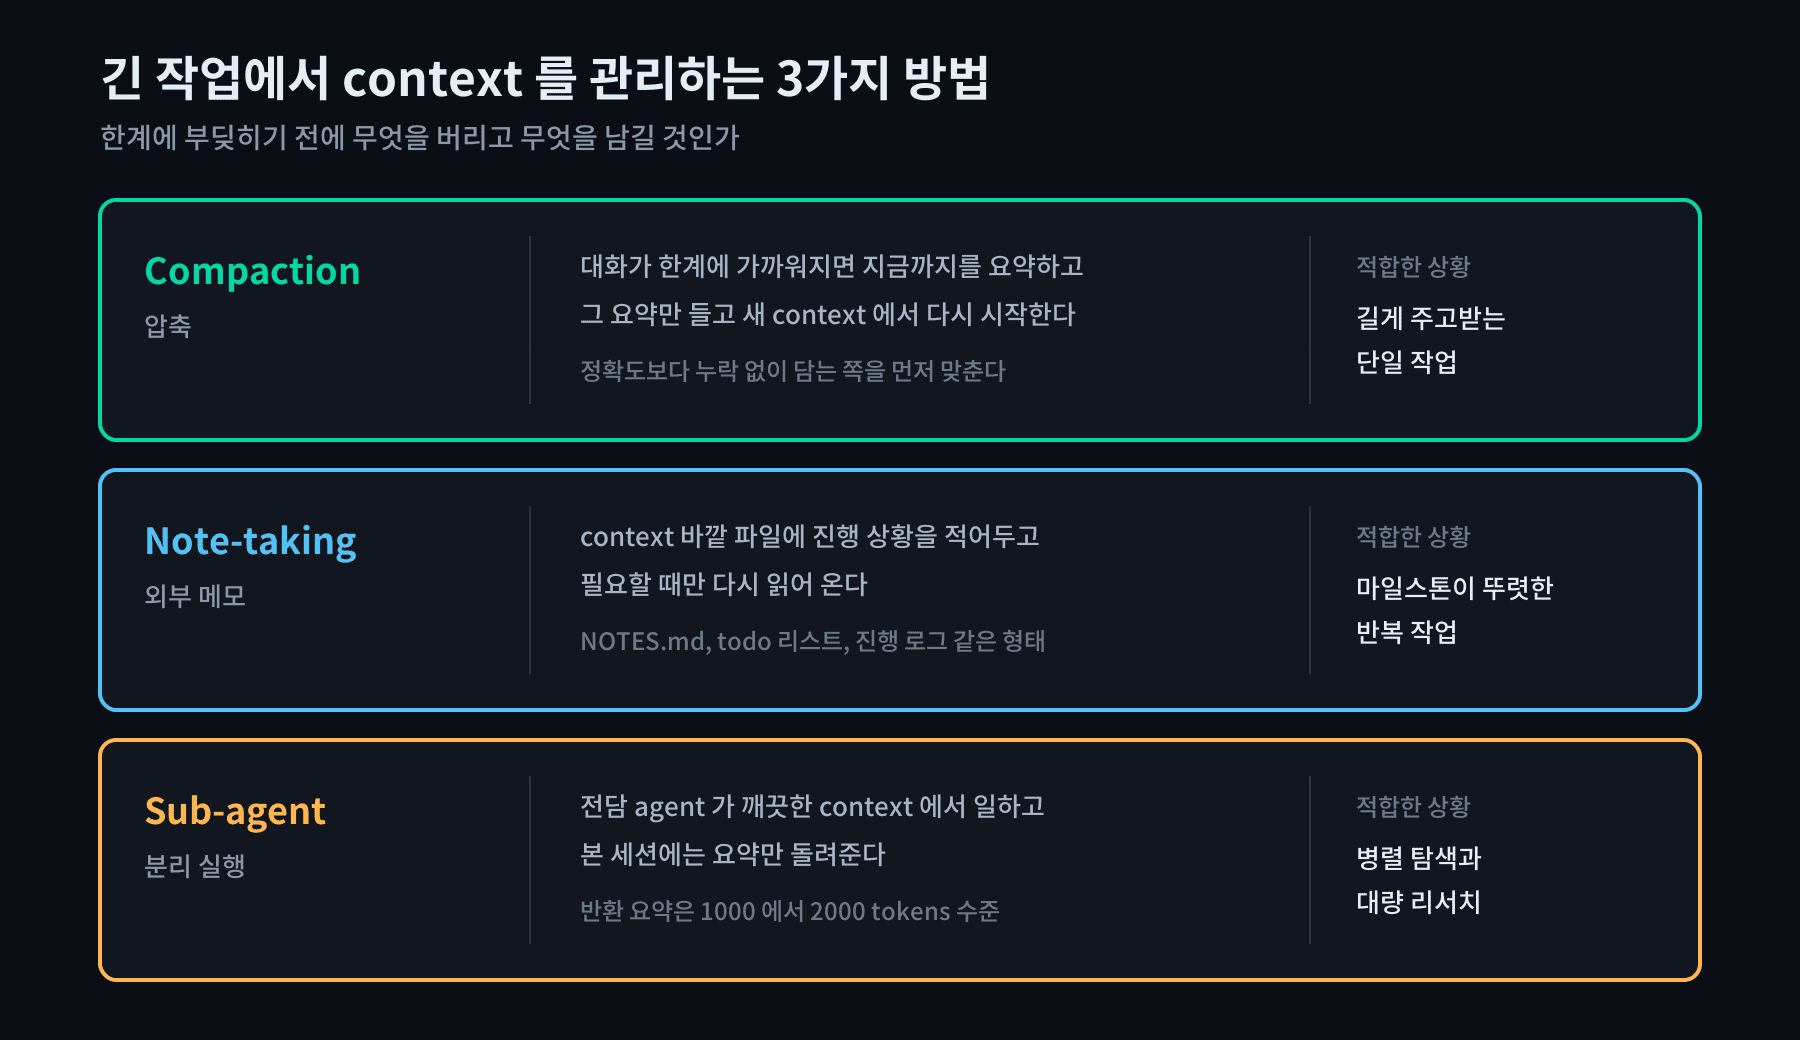
compaction 은 요약하고 다시 시작하는 것이다. 요약 규칙을 직접 정해둘 수 있는데, 남길 것과 버릴 것을 명시해두면 품질이 꽤 올라간다. 지금 목표, 변경된 파일, 실행한 명령, 실패한 테스트와 정확한 에러, 내린 결정, 다음 단계를 남기고 오래된 탐색 경로와 반복 로그는 버리는 식이다. Claude Code 에서는 /compact 뒤에 그 지시를 바로 붙이면 된다.
1
2
/compact 현재 목표, 수정한 파일 목록, 아직 실패 중인 테스트와 에러 메시지 원문,
지금까지 내린 설계 결정과 그 이유만 남겨줘. 탐색하다 버린 경로와 빌드 로그는 버려도 된다.
note-taking 은 context 바깥에 상태를 두는 것이다. 진행 상황을 파일로 적어두면 context 가 날아가도 복구된다. 마일스톤이 뚜렷한 작업에 잘 맞는다.
1
2
3
작업하면서 PROGRESS.md 를 계속 갱신해줘.
완료한 단계, 남은 단계, 막힌 부분과 시도해본 방법을 적고,
새 세션에서 이 파일만 읽어도 이어서 작업할 수 있게 써줘.
sub-agent 는 지저분한 과정을 통째로 격리한다. 전담 agent 가 자기 context 에서 탐색을 끝내고 본 세션에는 요약만 돌려준다. 반환 요약이 1000에서 2000 token 수준이면 적절하다고 본다. 위임할 때는 무엇을 돌려받을지를 같이 정해주는 게 핵심이다.
1
2
3
sub-agent 를 써서 이 프로젝트에서 UserDefaults 를 직접 쓰는 곳을 전부 찾아줘.
돌려줄 결과는 파일 경로, 사용하는 key, 읽기인지 쓰기인지만 표로 정리해줘.
코드 원문은 붙이지 않아도 된다.
반환 형식을 정하지 않으면 sub-agent 가 찾은 코드를 전부 붙여서 돌려주고, 격리한 의미가 사라진다.
셋 중 고르는 기준은 작업 형태다. 길게 주고받는 단일 작업이면 compaction, 반복되고 마일스톤이 있으면 note-taking, 병렬 리서치면 sub-agent 다.
token 관리 체크리스트
위 내용을 Claude Code 기준 실행 가능한 항목으로 정리하면 이렇다.
세션 관리부터 보면, 작업을 바꿀 때 /clear 로 끊는 게 기본이다. 이전 디버깅 로그가 다음 작업까지 따라다닐 이유가 없다. 긴 작업 중간에는 /compact 를 쓰고, 큰 작업 시작 전에는 /context 로 현재 점유율을 확인한다.
설정 파일 쪽은 이렇게 본다.
- CLAUDE.md 는 짧게 유지한다. 패키지 매니저, 테스트와 타입체크 명령, 주요 디렉터리, 건드리면 안 되는 경로 정도면 충분하다
- 특정 경로에서만 필요한 규칙은
.claude/rules/로 내려 해당 파일을 편집할 때만 로드되게 한다 - 특정 작업에서만 필요한 워크플로는 skill 로 내린다
tool 과 출력 쪽에서 새는 token 이 의외로 크다.
- 안 쓰는 MCP 서버는 끈다. tool 정의는 매 요청마다 청구된다
- 같은 일을 CLI 로 할 수 있으면 MCP 보다 CLI 가 싸다
- 명령 출력은 필터링해서 넘긴다. 전체 테스트 로그 대신 실패 라인만 보내는 식이다
.env,node_modules,dist, 로그 디렉터리처럼 읽을 일 없는 경로는 권한 설정에서 막아둔다
모델과 작업 배분도 비용 차이가 크다.
- 일상 작업은 가벼운 모델로, 복잡한 아키텍처 판단에만 무거운 모델을 쓴다
- 장황한 탐색은 sub-agent 에게 넘기고 요약만 받는다
- 단순 편집에 과한 추론을 돌리지 않는다. thinking token 도 출력 token 으로 계산된다
마지막으로 가장 효과가 큰 습관 하나. 저장소 전체를 훑게 하지 말고 시작 파일을 직접 지정한다. 그리고 모델이 엉뚱한 파일을 읽기 시작하면 바로 끊고 되돌린다. 잘못된 탐색을 끝까지 지켜본 뒤 고치는 것이 가장 비싸다.
보안
skill 은 모델에게 지시문과 실행 코드를 동시에 건네는 물건이다. 소프트웨어를 설치하는 것과 같은 수준으로 봐야 한다. ECC 처럼 수백 개의 skill 과 agent 를 한 번에 가져오는 경우라면 더더욱 그렇다.
Anthropic 의 권고는 신뢰할 수 있는 출처의 skill 만 설치하라는 것이고, 출처가 불확실하면 쓰기 전에 전부 들여다보라는 것이다. 확인할 지점은 대략 이렇다.
- SKILL.md 뿐 아니라 번들된 script 와 리소스 파일까지 전부 읽는다
- skill 이 표방한 목적과 맞지 않는 네트워크 호출이나 파일 접근이 있는지 본다
- 외부 URL 에서 내용을 가져오는 skill 은 특히 위험하다. 가져온 내용 자체가 악의적 지시문일 수 있고, 처음엔 멀쩡했던 의존성이 나중에 바뀔 수도 있다
민감한 데이터나 중요한 작업에 접근 권한이 있는 환경이라면 더 보수적으로 접근하는 게 맞다. 받은 skill 을 실제로 어떻게 검토하는지, 눈에 보이지 않는 문자나 외부 통신 명령을 찾는 방법은 (2) 에서 명령과 함께 정리했다.
정리
harness, context engineering, progressive disclosure 는 결국 같은 문제의식에서 나온 말이다. 모델에게 무한한 맥락을 줄 수 없고, 무엇이 필요할지 미리 알 수도 없다는 것.
Agent Skills 는 이 문제를 아주 평범한 방법으로 푼다. 폴더와 markdown 파일, 그리고 “언제 읽을지”를 단계로 나누는 규칙. 특별한 기술이 들어있지 않다는 점이 오히려 이 설계의 장점이다. agent 가 파일을 읽을 수 있기만 하면 어디서든 동작하기 때문에, 특정 벤더에 묶이지 않는다.
ECC 같은 프레임워크를 쓰든 직접 만들든, 판단 기준은 하나로 수렴한다. 지금 이 맥락이 매 세션 상시로 필요한가, 아니면 특정 작업에서만 필요한가. 후자를 전자 자리에 올려두는 것이 token 과 성능을 동시에 깎아먹는 가장 흔한 실수다.
다음 글 (2) Agent Skills 직접 만들기 에서는 이 블로그의 작성 규칙을 실제 skill 로 만들면서, spec 이 정한 구조와 테스트 방법, 남이 만든 skill 을 검토하는 방법을 다룬다.
참고: Agent Skills Docs, Context Engineering Docs, Agent Skills 엔지니어링 블로그 Docs, ECC 저장소 Docs