Swift Algorithms (1) Generics
Generic Function: swap 함수로 시작하기
두 값을 swap하는 함수부터 만들어보면서 generics가 왜 필요한지 살펴본다.
두 값을 swap하는 함수 만들기
정수 두 개를 swap하는 함수부터 만든다.
1
2
3
4
5
func swap(_ a: Int, _ b: Int) {
    let temp = a
    a = b
    b = temp
}
이 코드는 컴파일이 안 된다. a, b가 함수 파라미터라 기본적으로 let 상수 취급되기 때문에 값을 재할당할 수 없다. 그래서 inout 키워드를 붙여줘야 한다.
1
2
3
4
5
func swap(_ a: inout Int, _ b: inout Int) {
    let temp = a
    a = b
    b = temp
}
inout은 파라미터를 “값 복사본”이 아니라 원본 변수에 대한 참조처럼 다루게 해주는 키워드다(Docs).
일반적으로 Swift 함수는 인자로 넘긴 값을 복사해서 쓰기 때문에 함수 안에서 값을 바꿔도 호출한 쪽의 원본은 그대로인데, inout을 붙이면 함수 안에서의 변경이 실제로 호출부의 변수에도 반영된다. 그래서 함수 내부에서 a, b에 값을 재할당하는 게 가능해지는 것이다. 일반적으로 Swift 함수는 인자로 넘긴 값을 복사해서 쓰기 때문에 함수 안에서 값을 바꿔도 호출한 쪽의 원본은 그대로인데, inout을 붙이면 함수 안에서의 변경이 실제로 호출부의 변수에도 반영된다. 그래서 함수 내부에서 a, b에 값을 재할당하는 게 가능해지는 것이다.
이렇게 inout 파라미터를 받는 함수를 호출할 때는, 넘기는 변수 앞에 &를 붙여야 한다.
1
2
3
4
5
6
var v1 = 5
var v2 = -7

print(v1, v2)
swap(&v1, &v2)
print(v1, v2)
&는 “이 변수를 참조로 넘긴다”는 걸 호출부에서도 명시적으로 드러내는 표시다. 함수 내부에서 이 값이 바뀔 수 있다는 걸 호출하는 쪽에서도 코드만 보고 바로 알 수 있게 해주는 일종의 경고 표시인 셈이다. 그리고 v1, v2도 let이 아니라 var로 선언해야 애초에 참조로 넘겨서 변경할 수 있는 대상이 된다. 실행하면 5 -7이 -7 5로 정확히 swap된다.
1
2
v1: 5, v2: -7
v1: -7, v2: 5
타입이 늘어날 때마다 함수도 늘어나는 문제
이제 문자열을 swap하는 함수가 필요하다고 해보자. 같은 코드를 복사해서 타입만 String으로 바꾼 버전을 하나 더 만든다.
1
2
3
4
5
func swap(_ a: inout String, _ b: inout String) {
    let temp = a
    a = b
    b = temp
}
두 함수는 시그니처가 다르니 오버로딩으로 문제없이 공존하고, 컴파일도 잘 된다. "Hello", "world"를 넣고 실행해봐도 정상적으로 swap된다.
그런데 이번엔 [Int](정수 배열) 두 개를 swap하고 싶다면? 또 같은 코드를 복사해서 타입만 [Int]로 바꿔야 한다.
1
2
3
4
5
func swap(_ a: inout [Int], _ b: inout [Int]) {
    let temp = a
    a = b
    b = temp
}
이쯤 되면 문제가 명확해진다. 함수 본문은 세 개 다 완전히 똑같은데, 타입만 다르다는 이유로 코드를 계속 복붙하고 있다. 이게 바로 generics가 필요한 지점이다.
T로 일반화하기
기존 함수들을 전부 지우고, 구체적인 타입 대신 타입 파라미터 T를 쓴다.
1
2
3
4
5
func swap<T>(_ a: inout T, _ b: inout T) {
    let temp = a
    a = b
    b = temp
}
함수 이름 뒤에 꺾쇠괄호(<T>)를 붙이는 것만으로 끝이다. 이 함수 하나로 Int, String, [Int] 전부 문제없이 동작한다. 실제로 배열로 테스트해도, 문자열로 테스트해도 전부 정상적으로 swap된다.
다만 모든 상황에서 이 방식이 통하는 건 아니다. 값들 사이에 순서가 있어야 하거나, 숫자 연산이 필요한 경우처럼 T에 아무 제약이 없으면 안 되는 상황도 있다. 이런 경우는 타입 파라미터에 제약(constraint)을 거는 방법이 따로 필요하다.
Comparable 제약 걸기: max 함수와 Pair 구조체
이번엔 두 정수 중 더 큰 값을 반환하는 max 함수로 시작해서, generic 타입에 제약(constraint)을 거는 법을 살펴본다.
왜 Comparable 제약이 필요한가
정수 버전 max 함수는 간단하다.
1
2
3
func max(_ x: Int, _ y: Int) -> Int {
    x > y ? x : y
}
이걸 그대로 제네릭으로 바꾸면 문제가 생긴다.
1
2
3
func max<T>(_ x: T, _ y: T) -> T {
    x > y ? x : y
}
T는 아무 타입이나 될 수 있는데, > 연산자는 모든 타입에 정의되어 있는 게 아니다. 그래서 T가 Comparable 프로토콜을 따르도록 제약을 걸어야 한다.
1
2
3
func max<T: Comparable>(_ x: T, _ y: T) -> T {
    x > y ? x : y
}
어떤 타입이 Comparable을 만족하는가
이 상태에서 여러 타입으로 테스트해본다.
1
2
let a = max(5, -7)          // Int, Comparable 만족 - 동작
let b = max("Hello", "World") // String, 사전순 비교로 Comparable 만족 - 동작
String도 별도 구현 없이 바로 max에 쓸 수 있다. 사전순(lexicographic) 비교가 이미 Swift 표준 라이브러리에서 Comparable로 구현되어 있기 때문이다.
반면 튜플이나 CGPoint는 그대로 쓸 수 없다.
1
2
let c = max((1, 5), (-2, 3)) // (Int, Int)는 Comparable을 만족하지 않음 - 컴파일 에러
let d = max(CGPoint(x: 3, y: -1), CGPoint(x: 0, y: 0)) // CGPoint도 Comparable 아님 - 컴파일 에러
(Int, Int)도, CGPoint도 기본적으로 대소 비교가 정의되어 있지 않다. 이런 값들을 비교하려면 직접 Comparable을 구현한 타입을 만들어야 한다.
Pair 구조체로 직접 Comparable 구현하기
x, y 두 개의 정수를 가진 Pair 구조체를 만들고, Comparable을 채택한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
struct Pair: Comparable {
    let x: Int
    let y: Int

    static func < (lhs: Pair, rhs: Pair) -> Bool {
        if lhs.x < rhs.x {
            return true
        } else if lhs.x > rhs.x {
            return false
        } else {
            return lhs.y < rhs.y
        }
    }
}
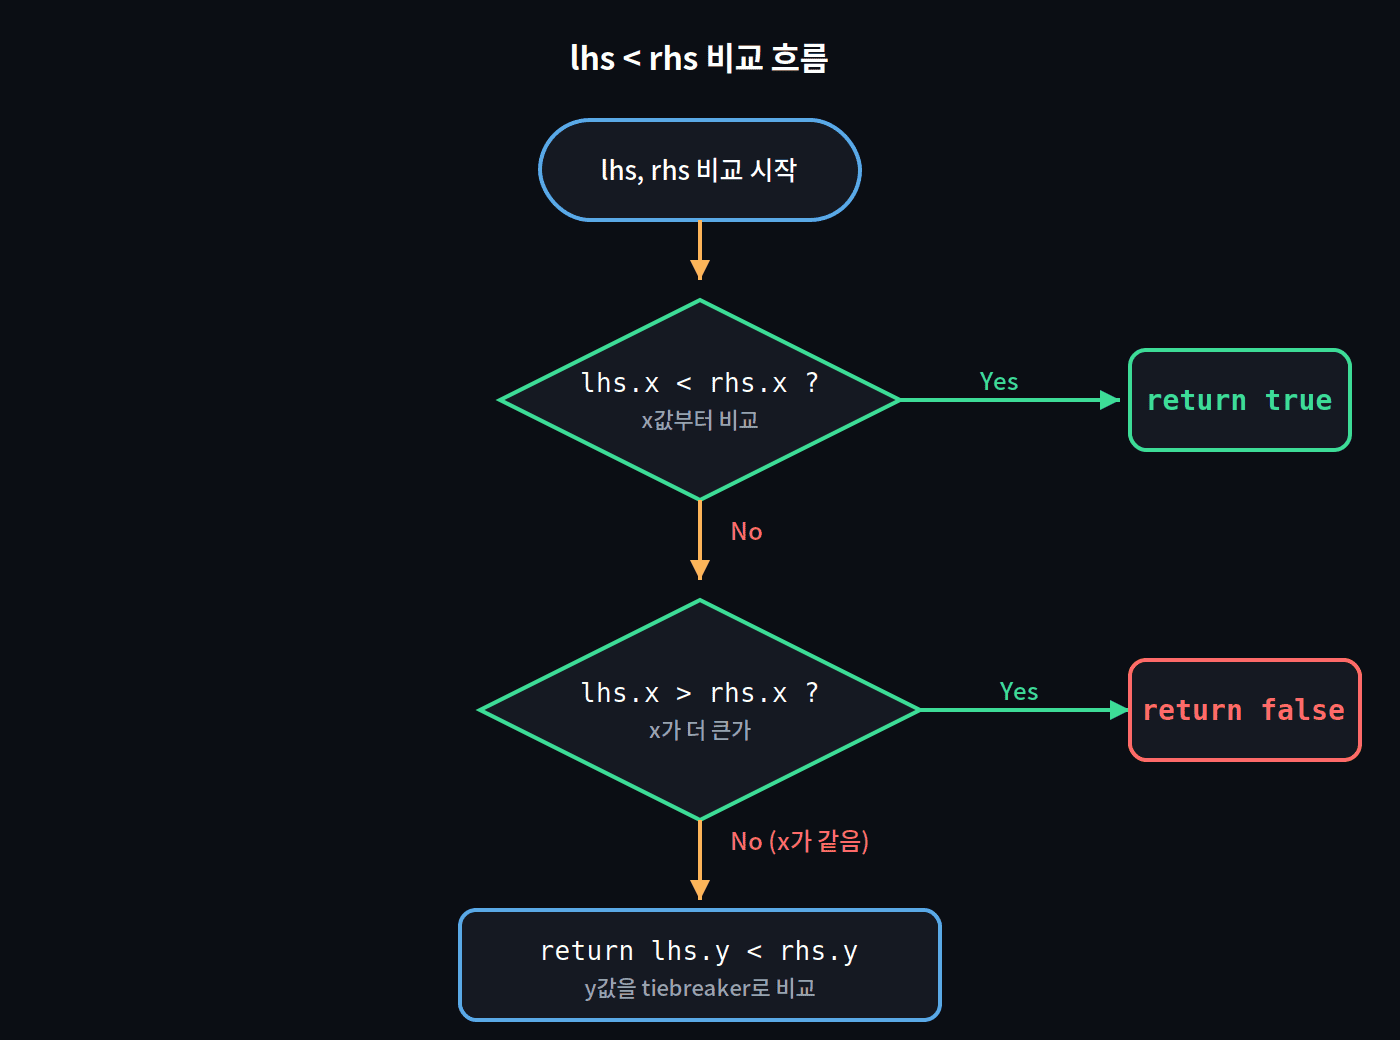
Comparable을 만족하려면 < 연산자를 직접 정의해야 한다. 여기서는 사전순 비교를 구현한다. x 값이 다르면 x만으로 대소를 결정하고, x가 같으면 y 값으로 비교한다(tiebreaker).
이제 Pair 값들을 max에 넘길 수 있다.
1
2
let c = max(Pair(x: 1, y: 5), Pair(x: -2, y: 3))
print(c) // Pair(x: 1, y: 5) - x값이 더 크므로
Pair도 제네릭으로 만들기
지금 Pair는 x, y가 둘 다 Int로 고정되어 있다. 이것도 제네릭으로 일반화할 수 있다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
struct Pair<T: Comparable>: Comparable {
    static func < (lhs: Pair, rhs: Pair) -> Bool {
        if lhs.x < rhs.x {
            return true
        } else if lhs.x > rhs.x {
            return false
        } else {
            return lhs.y < rhs.y
        }
    }

    let x: T
    let y: T
}
T가 Comparable이어야 lhs.x < rhs.x, lhs.y < rhs.y 비교가 가능하므로, Pair의 타입 파라미터에도 T: Comparable 제약을 걸어야 한다.
이제 Pair<String>도 만들 수 있다.
1
2
let d = max(Pair(x: "hello", y: "hummus"), Pair(x: "hello", y: "water"))
print(d) // Pair(x: "hello", y: "water") - x가 같아서 y로 비교, "water"가 "hummus"보다 크다
x가 둘 다 "hello"로 같으니 y가 tiebreaker로 작동해서, "water"가 "hummus"보다 사전순으로 뒤에 오는 걸 기준으로 더 큰 Pair가 선택된다.
제네릭 Stack 만들기: struct와 class의 차이
Stack이라는 제네릭 자료구조를 만들면서, push/pop 동작과 함께 struct와 class가 대입(assignment) 시 어떻게 다르게 동작하는지 살펴본다.
Stack 구조체 정의하기
1
2
3
struct Stack<Element> {
    var elements: [Element] = []
}
타입 파라미터 이름을 T 대신 Element로 써서 가독성을 높였다. 내부적으로는 그냥 배열 하나를 들고 있는 구조다.
push와 pop: mutating 키워드
1
2
3
4
5
6
7
8
9
10
11
struct Stack<Element>: CustomStringConvertible {
    var elements: [Element] = []

    mutating func push(_ element: Element) {
        elements.append(element)
    }

    mutating func pop() -> Element? {
        elements.popLast()
    }
}
push, pop 둘 다 elements 배열을 바꾸는 함수라 mutating을 붙여야 한다. struct는 값 타입이라, struct의 프로퍼티를 바꾸는 메서드는 컴파일러가 기본적으로 허용하지 않기 때문에 이렇게 명시적으로 표시해줘야 한다. pop()은 스택이 비어있을 수도 있으니 Element?(optional)를 반환하고, 실제 구현은 Array가 이미 제공하는 popLast()를 그대로 활용한다.
CustomStringConvertible로 출력 형태 다듬기
기본 상태로는 print(stack)을 해봐도 원하는 형태로 안 나온다. CustomStringConvertible을 채택하고 description을 직접 구현한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
struct Stack<Element>: CustomStringConvertible {
    var description: String {
        var result = ""
        for element in elements.reversed() {
            result += "\(element)\n"
        }

        return result
    }

    private var elements: [Element] = []

    // push
    mutating func push(element: Element) {
        elements.append(element)
    }

    // pop
    mutating func pop() -> Element? {
        elements.popLast()
    }

}
elements를 그대로 순회하면 맨 아래에 넣은 요소부터 출력되는데, 스택은 보통 맨 위(top)가 먼저 보이는 게 직관적이므로 reversed()로 순서를 뒤집어서 출력한다.
push/pop 동작 확인하기
1
2
3
4
5
6
7
8
9
10
var stack = Stack<Int>()
stack.push(element: 1)
stack.push(element: 2)
stack.push(element: 3)
stack.push(element: 4)

print(stack)

let popped = stack.pop()
print("Popping top element: \(String(describing: popped))")
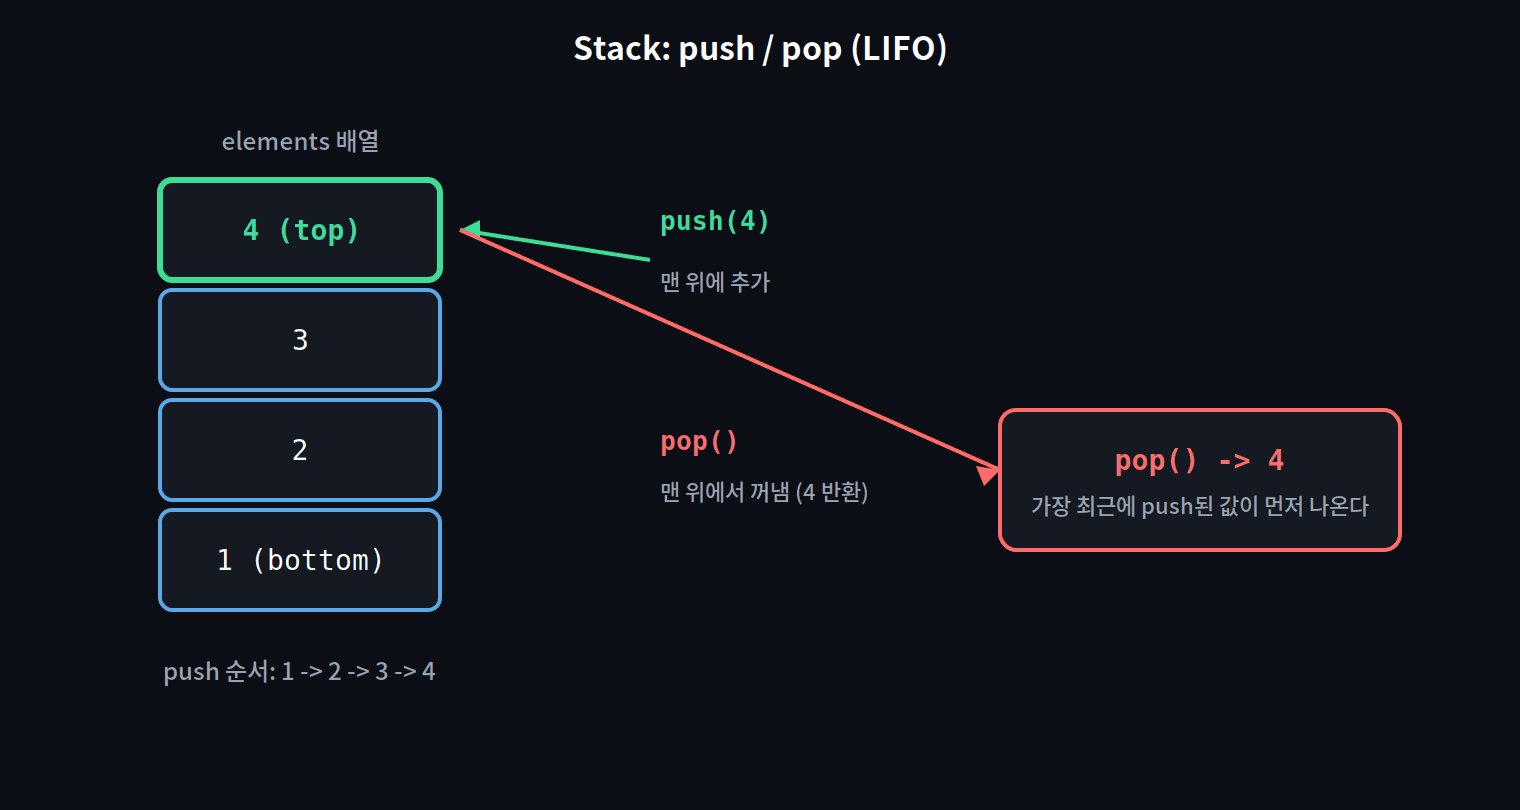
1을 가장 먼저 넣었으니 스택 맨 아래에 위치하고, 가장 나중에 넣은 4가 맨 위에 온다. pop()을 호출하면 가장 최근에 넣은 값(4)이 먼저 나온다. 이런 후입선출(LIFO, Last In First Out) 동작이 스택의 핵심이다.
struct를 class로 바꿔보기
이번엔 같은 Stack을 class로 바꿔서 동작 차이를 확인한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class StackClass<Element>: CustomStringConvertible {
    var description: String {
        var result = ""
        for element in elements.reversed() {
            result += "\(element)\n"
        }

        return result
    }

    private var elements: [Element] = []

    // push
    func push( element: Element) {
        elements.append( element)
    }

    // pop
    func pop() -> Element? {
        elements.popLast()
    }

}
class에서는 mutating 키워드가 필요 없다. class는 참조 타입(reference type)이라, 인스턴스의 프로퍼티를 바꾸는 것 자체가 애초에 값 타입에서와 같은 제약을 받지 않기 때문이다.
대입 시 동작 차이: 값 타입 vs 참조 타입
이 차이가 실제로 어떤 결과를 만드는지 확인해본다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
var s2 = Stack<Int>()
s2.push(1)
s2.push(2)
s2.push(3)
s2.push(4)

print(s2)
print("Popping top element: \(String(describing: s2.pop()))")
print( s2)

// 4
// 3
// 2
// 1

// Popping top element: Optional(4)
// 3
// 2
// 1

let s3 = s2
s3.pop()
s3.pop()

print(s3)
print(s2)

// Popping from s3
// 1

// Displaying s2
// 3
// 2
// 1
struct(값 타입)일 때: let s3 = s2는 s2의 내용을 완전히 복사한 새로운 독립적인 Stack 인스턴스를 만든다. 그래서 s3에서 pop()을 세 번 호출해도 s2는 전혀 영향을 받지 않는다. s3는 [1]만 남지만 s2는 여전히 [1, 2, 3, 4] 그대로다.
class(참조 타입)일 때: let s3 = s2는 값을 복사하는 게 아니라, 같은 인스턴스를 가리키는 참조(포인터)를 하나 더 만드는 것이다. s2와 s3는 사실상 같은 메모리 상의 객체를 가리키고 있으므로, s3에서 pop()을 호출하면 그 변화가 s2에도 그대로 반영된다. s3, s2 둘 다 [1]로 바뀐다.
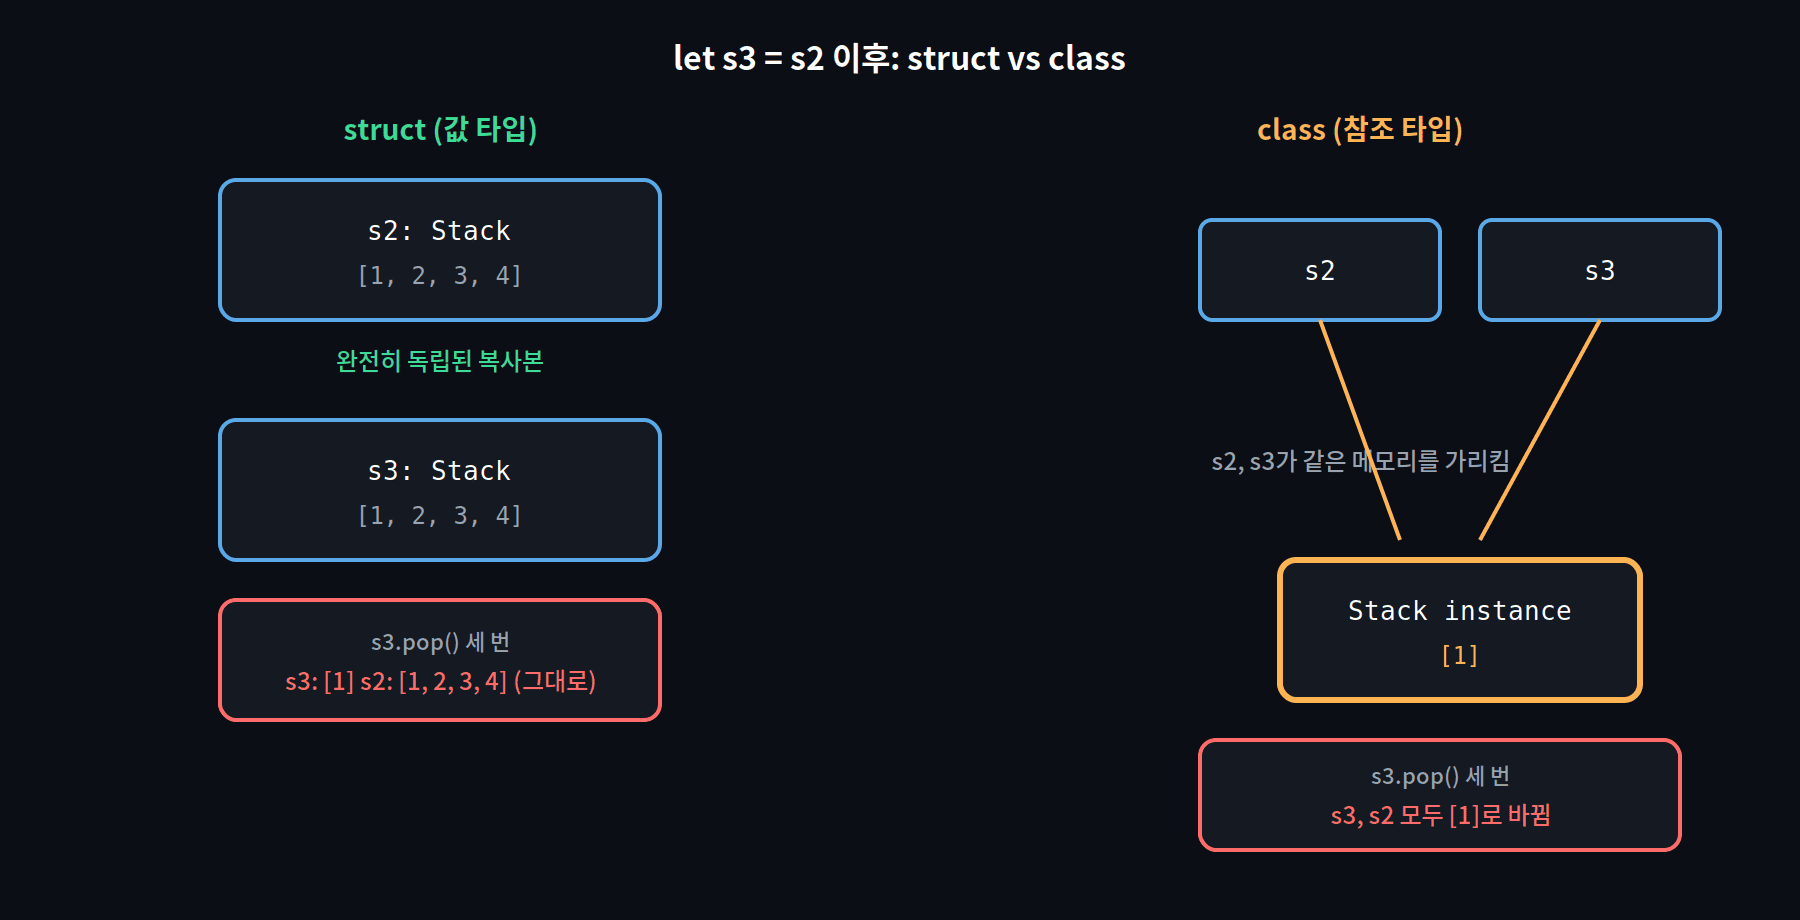
이건 많은 경우 의도치 않은 부작용(side effect)이 될 수 있다. 물론 상황에 따라 참조 타입의 이 공유 특성이 오히려 필요한 경우도 있지만, 값 타입과 참조 타입 중 뭘 쓰느냐에 따라 이렇게 대입 하나로 완전히 다른 결과가 나올 수 있다는 걸 명확히 인지하고 있어야 한다.
두 개의 제약 조합하기: AdditiveDictionary
이번엔 타입 파라미터 두 개에 각각 다른 제약을 걸어야 하는 예제를 살펴본다. key와 value를 갖는 AdditiveDictionary를 만들고, 같은 key를 가진 두 인스턴스의 value를 더하는 add 메서드를 구현한다.
기본 구조 정의하기
1
2
3
4
struct AdditiveDictionary<Key, Value> {
    let key: Key
    let value: Value
}
add 메서드와 필요한 제약들
같은 key를 가진 두 AdditiveDictionary의 value를 더하는 메서드를 만든다.
1
2
3
4
5
6
7
8
9
func add( other: AdditiveDictionary<Key,Value>) -> AdditiveDictionary<Key,Value>? {
    if self.key != other.key {
        return nil
    } else {
        return AdditiveDictionary(
            key: self.key,
            value: self.value + other.value)
    }
}
이 상태로는 두 가지 컴파일 에러가 난다.
self.key != other.key에서Key끼리!=비교를 하려면Key가Equatable(또는Comparable)을 만족해야 한다self.value + other.value에서Value끼리+연산을 하려면Value가 덧셈을 지원해야 한다
각각의 제약을 타입 파라미터 선언부에 추가한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
struct AdditiveDictionary<Key: Comparable,Value: AdditiveArithmetic> {
    let key: Key
    let value: Value

    func add( other: AdditiveDictionary<Key,Value>) -> AdditiveDictionary<Key,Value>? {
        if self.key != other.key {
            return nil
        } else {
            return AdditiveDictionary(
                key: self.key,
                value: self.value + other.value)
        }
    }
}
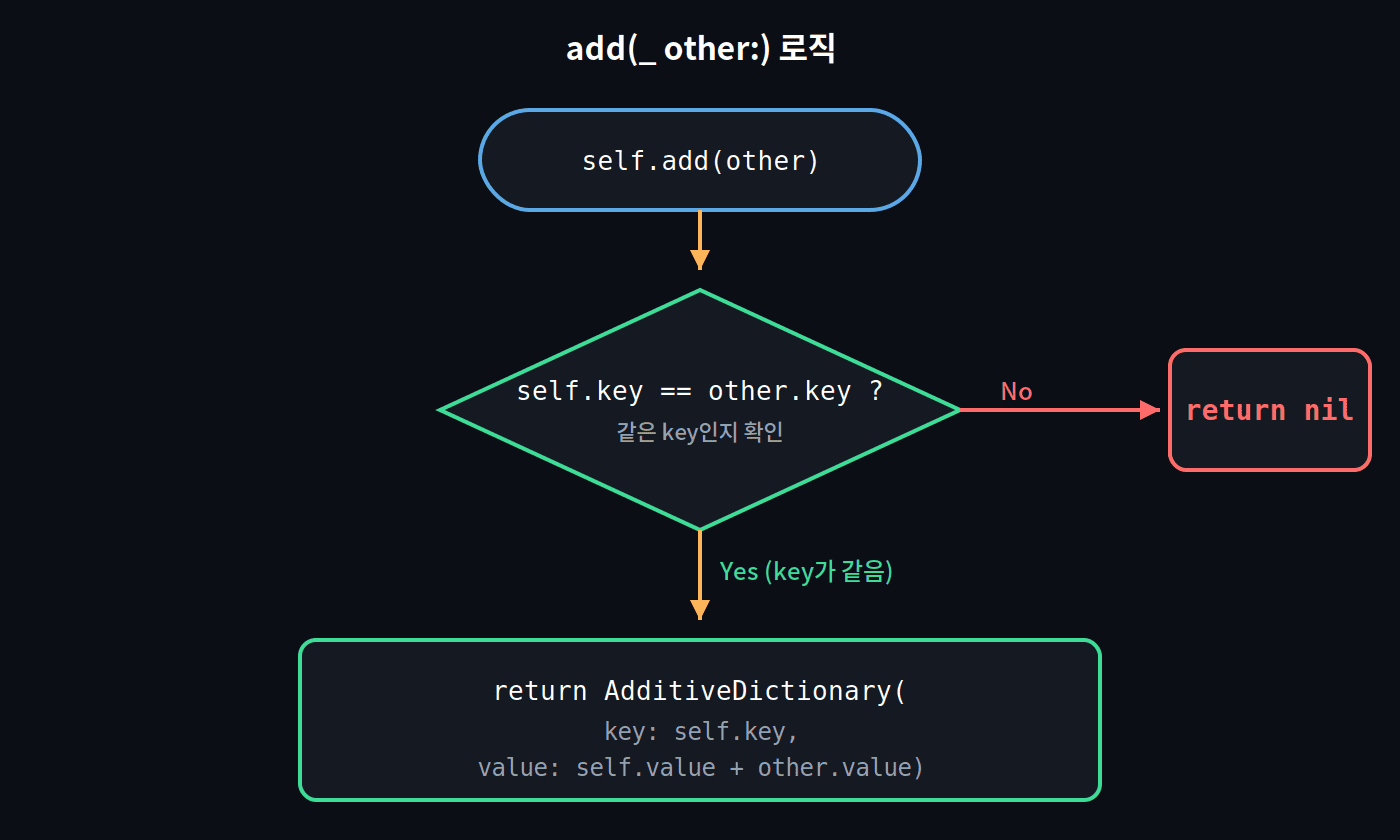
Key에는 Comparable을, Value에는 AdditiveArithmetic을 건다. AdditiveArithmetic은 Swift 표준 라이브러리 프로토콜로, +와 - 연산을 지원하는 타입(대부분의 숫자 타입)이 채택하고 있다. 이걸 걸어두면 Value가 Int, Double 등 숫자 타입일 때는 자유롭게 쓸 수 있지만, String처럼 AdditiveArithmetic을 만족하지 않는 타입은 value로 쓸 수 없게 된다.
반환 타입이 AdditiveDictionary?인 이유는, key가 서로 다르면 애초에 더할 수 없는 값들이라 nil을 반환해야 하기 때문이다.
테스트해보기
1
2
3
4
5
6
7
8
9
10
11
12
func testAdditiveDictionary() {
    let example1 = AdditiveDictionary<Double,Int>(key: 3.5, value: 7)
    let example2 = AdditiveDictionary<Double,Int>(key: 3.5, value: 24)
    let example3 = example1.add(other: example2)

    if let example3 {
        print(example3)
    }

}

// AdditiveDictionary<Double, Int>(key: 3.5, value: 31)
Key는 Double, Value는 Int로 자동 추론된다(명시적으로 타입을 적어줄 필요는 없다). 두 인스턴스의 key가 둘 다 3.5로 같으니 add가 nil이 아닌 값을 반환하고, value는 7 + 24 = 31로 합산된다. add가 optional을 반환하므로 if let으로 꺼내서 출력해야 한다.