Swift Algorithms (5) - The Functional Approach
Part 3: 함수형(Swifty) 스타일로 다시 풀기
Part 2에서 명령형(imperative) 스타일로 풀었던 문제들을, filter/map/reduce/forEach 같은 함수형 도구를 써서 다시 풀어본다.
firstDivisibleSwifty: filter + first
먼저 firstDivisible부터(이름에 있던 오타 first_the_visible도 이 김에 firstDivisible로 바로잡았다).
a로 나누어떨어지는 원소의 인덱스만 걸러낸 다음, 그중 첫 번째를 가져오면 된다는 아이디어다.
1
2
3
static func firstDivisibleSwifty(lst: [Int], a: Int) -> Int? {
    lst.indices.filter { lst[$0] % a == 0 }.first
}
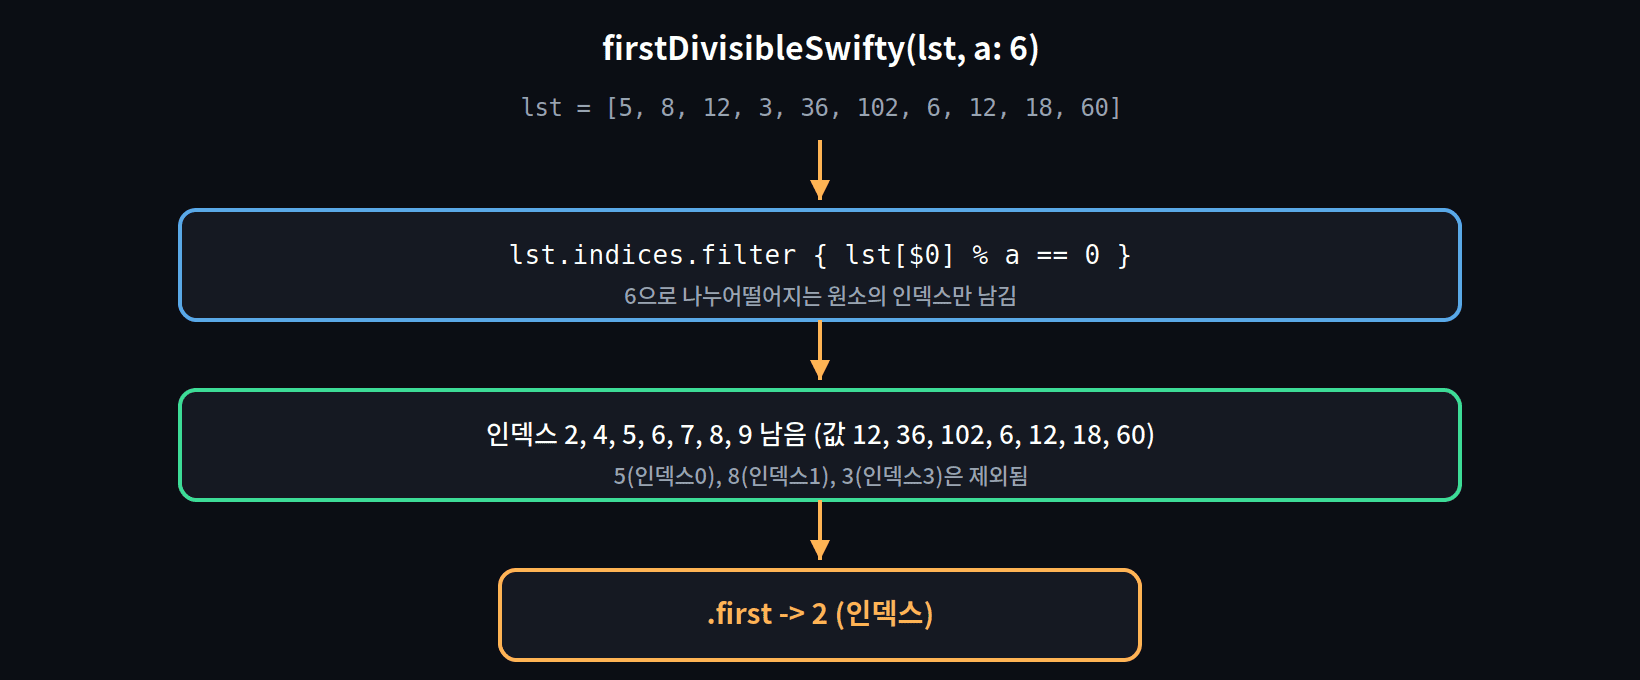
lst.indices로 인덱스 목록을 만들고, filter로 조건(lst[$0] % a == 0)을 만족하는 인덱스만 남긴다. 조건을 만족하는 게 하나도 없으면 filter의 결과가 빈 배열이 되고, 빈 배열의 .first는 자연스럽게 nil이 된다. 별도로 “찾지 못한 경우”를 처리하는 코드가 필요 없다는 게 포인트다.
a == 0인 경우(0으로 나누기)를 처리하는 방어 코드까지 넣으면 삼항 연산자로 한 줄에 담을 수 있다.
1
2
3
static func firstDivisibleSwifty(lst: [Int], a: Int) -> Int? {
    a == 0 ? nil : lst.indices.filter { lst[$0] % a == 0 }.first
}
명령형 버전으로 여러 줄에 걸쳐 짰던 로직이 한 줄로 압축된다. 다만 이게 “더 좋은 코드”라고 단정할 수는 없다고 짚었다. 짧다고 항상 더 읽기 쉬운 건 아니고, 실제로 더 효율적인지도 컴파일러 최적화에 달려있어 확신할 수 없기 때문이다. 이 함수의 Part 2 unit test(testFirstDivisible)를 그대로 이 함수에 돌려봐도 전부 통과하는 걸 확인해서, 최소한 기능적으로는 동일하다는 걸 검증했다.
numberOfStringsAboveAverageSwifty: map + reduce + filter
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
static func numberOfStringsAboveAverageSwifty(lst: [String]) -> (num: Int, average: Double?) {
    if lst.isEmpty {
        return (0, nil)
    }

    let sum: Int = lst
        .map { $0.count }
        .reduce(0, +)
    let average = Double(sum) / Double(lst.count)

    let numberOfStringsAboveAverage: Int = lst
        .filter { Double($0.count) > average }
        .count

    return (numberOfStringsAboveAverage, average)
}
lst.map { $0.count }로 각 문자열을 길이(Int)로 변환한 배열을 만들고, .reduce(0, +)로 전부 더해서 합계를 구한다. reduce(0, +)는 초기값 0에서 시작해서 + 연산자를 계속 적용해 누적하라는 뜻으로, reduce(0) { $0 + $1 }을 더 짧게 쓴 표현이다. 그다음 filter로 평균보다 긴 문자열만 골라내고 .count로 개수를 센다. 이전 Part 2 테스트(for, while 버전과 함께 같은 테스트 함수 안에서)를 그대로 돌려서 세 버전 모두 같은 결과를 내는지 확인했다.
sumOfProductsSwifty: map + reduce + joined
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
static func sumOfProductsSwifty(lst: [Int]) -> (result: Int, stringRepresentation: String) {
    if lst.count == 1 {
        return (lst[0], "\(lst[0])")
    }

    let plusSign = " + "
    let times = "⋅"

    let result: Int = lst
        .indices
        .dropLast()
        .map { lst[$0] * lst[$0+1] }
        .reduce(0, +)

    let pr: (Int) -> String = { value in
        value < 0 ? "(\(value))" : "\(value)"
    }

    let stringRep: String = lst
        .indices
        .dropLast()
        .map { "\(pr(lst[$0]))\(times)\(pr(lst[$0+1]))" }
        .joined(separator: plusSign)

    return (result, stringRep)
}
result는 lst.indices.dropLast()(마지막 인덱스는 i+1이 범위를 벗어나므로 제외)로 각 인접 쌍을 map으로 곱한 뒤 reduce(0, +)로 합산한다. 문자열 표현을 만들 때는 음수를 괄호로 감싸는 로직을 pr이라는 별도 클로저(함수 타입 (Int) -> String)로 뽑아내서 재사용한다. 각 쌍을 "항1⋅항2" 형태의 문자열로 map한 다음, .joined(separator: plusSign)로 이어붙이면 끝이다.
Part 2 명령형 버전에서는 dropLast(plusSign.count)로 trailing plus sign을 수동으로 잘라내야 했는데, joined(separator:)를 쓰면 애초에 구분자가 원소 사이에만 들어가고 끝에는 안 붙기 때문에 그 작업 자체가 필요 없어진다. 함수형 도구를 쓰면서 자연스럽게 버그의 여지 하나가 통째로 사라진 사례다.
growingDifferencesSwifty: forEach로 순회 스타일만 바꾸기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
static func growingDifferencesSwifty(lst: [Int]) -> [Int] {
    if lst.count < 2 {
        return []
    }
    var newList: [Int] = Array(lst[0..<2])

    lst.forEach {
        let last: Int = newList.last ?? 0
        let nextToLast: Int = newList.dropLast().last ?? 0

        if abs(last - $0) > abs(last - nextToLast) {
            newList.append($0)
        }
    }

    return newList
}
이 함수는 사실상 for listItem in lst를 lst.forEach { ... }로 바꾼 것 외에는 Part 2 버전과 로직이 거의 동일하다. map/filter/reduce처럼 새로운 배열이나 값을 만들어내는 변환이 아니라, newList라는 외부 상태를 그때그때 변경(mutate)해야 하는 로직이라 순수 함수형 체이닝으로 표현하기가 자연스럽지 않았기 때문이다.
repeatedSubstringSwifty: 함수형이 항상 답은 아니다
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
static func repeatedSubstringSwifty(myString: String, k: Int) -> (repeatString: String, index: Int)? {
    if k <= 0 {
        return nil
    }

    let startIndex: String.Index? = Set(myString)
        .map { String(repeating: $0, count: k) }
        .filter { myString.contains($0) }
        .compactMap { myString.range(of: $0)?.lowerBound }
        .min()

    let index: Int? = startIndex
        .map { myString.distance(from: myString.startIndex, to: $0) }

    if let index, let startIndex {
        let endIndex = myString.index(startIndex, offsetBy: k)
        let repeatedString = String(myString[startIndex..<endIndex])
        return (repeatedString, index)
    } else {
        return nil
    }
}
이 구현은 접근 자체가 다르다. myString에 등장하는 고유 문자 집합(Set(myString))을 만들고, 각 문자를 k번 반복한 문자열("aaa", "bbb" 등)을 만든 다음, 그게 실제로 myString 안에 존재하는지 확인하고, 존재하는 것들 중 가장 앞쪽에서 발견된 위치(.min())를 찾는 방식이다.
이 버전에 대해 “정말 마음에 들지 않는다”, “에러가 나기 매우 쉬운 구조”라는 평가가 직접 나왔다. Set으로 문자 집합을 뽑는 순간 원래 문자열의 등장 순서 정보가 사라지기 때문에, 그 뒤에 range(of:)로 다시 위치를 찾아 .min()으로 짜맞추는 우회가 필요해졌고, 이 과정 자체가 원래 문제가 요구하는 “첫 번째로 발견되는 위치”라는 조건과 논리적으로 잘 맞아떨어지는지 확신하기 어려운 구조였다는 것.
실제로 View에 연결해서 여러 문자열로 테스트해본 결과는 명령형 버전과 동일하게 나왔지만, 이 사례를 통해 얻은 교훈은 명확하다. 함수형 스타일이 항상 더 명확하거나 안전한 건 아니다. 어떤 문제(순서를 유지해야 하는 탐색)는 오히려 명령형 순회가 훨씬 직관적으로 맞아떨어지고, 억지로 함수형 체이닝으로 표현하려 하면 코드가 더 복잡해지고 버그 여지도 늘어날 수 있다.