Swift Algorithms (8) - Memoization
Part 6: Memoization — 재귀의 비효율을 실측으로 확인하기
Recursion은 종종 값비싼 연산이다. Memoization은 이전에 계산한 결과를 일종의 메모장(캐시)에 저장해뒀다가, 같은 계산이 다시 필요할 때 재사용해서 성능을 크게 끌어올리는 기법이다. 전형적인 예시가 Fibonacci 수열이고, 여기서는 그 확장판인 four-bonacci 수열(직전 4개 항의 합)을 다룬다.
1
2
3
4
5
Q0 = 0, Q1 = 1, Q2 = 2, Q3 = 3
Q(n) = Q(n-1) + Q(n-2) + Q(n-3) + Q(n-4), n >= 4

첫 항들: 0, 1, 2, 3, 6, 12, 23, 44, 85, ...
(6 = 0+1+2+3, 12 = 1+2+3+6, ...)
재귀 버전 먼저 구현하기
1
2
3
4
5
6
7
8
9
10
static func fourBonacciRec(n: Int) -> Int {
    if n <= 3 {
        return n
    } else {
        return fourBonacciRec(n: n-1) +
        fourBonacciRec(n: n-2) +
        fourBonacciRec(n: n-3) +
        fourBonacciRec(n: n-4)
    }
}
n <= 3이면 Q(n) = n이니 그대로 반환하고(base case), 아니면 정의 그대로 직전 4개 항을 재귀 호출해서 더한다. 문제 지문의 Q(n+4) 형태보다 Q(n)이 직전 4개 항(n-1, n-2, n-3, n-4)을 참조하는 형태로 살짝 바꿔서 구현했는데, 이렇게 하는 게 앞서 다룬 Fibonacci 정의 방식과 더 일관되게 느껴졌기 때문이다.
n이 큰 값으로 가면 컴퓨터가 멈춘 것처럼 오래 걸린다는 걸 미리 경고했는데, 실제로 그 이유는 호출 트리를 그려보면 바로 드러난다.
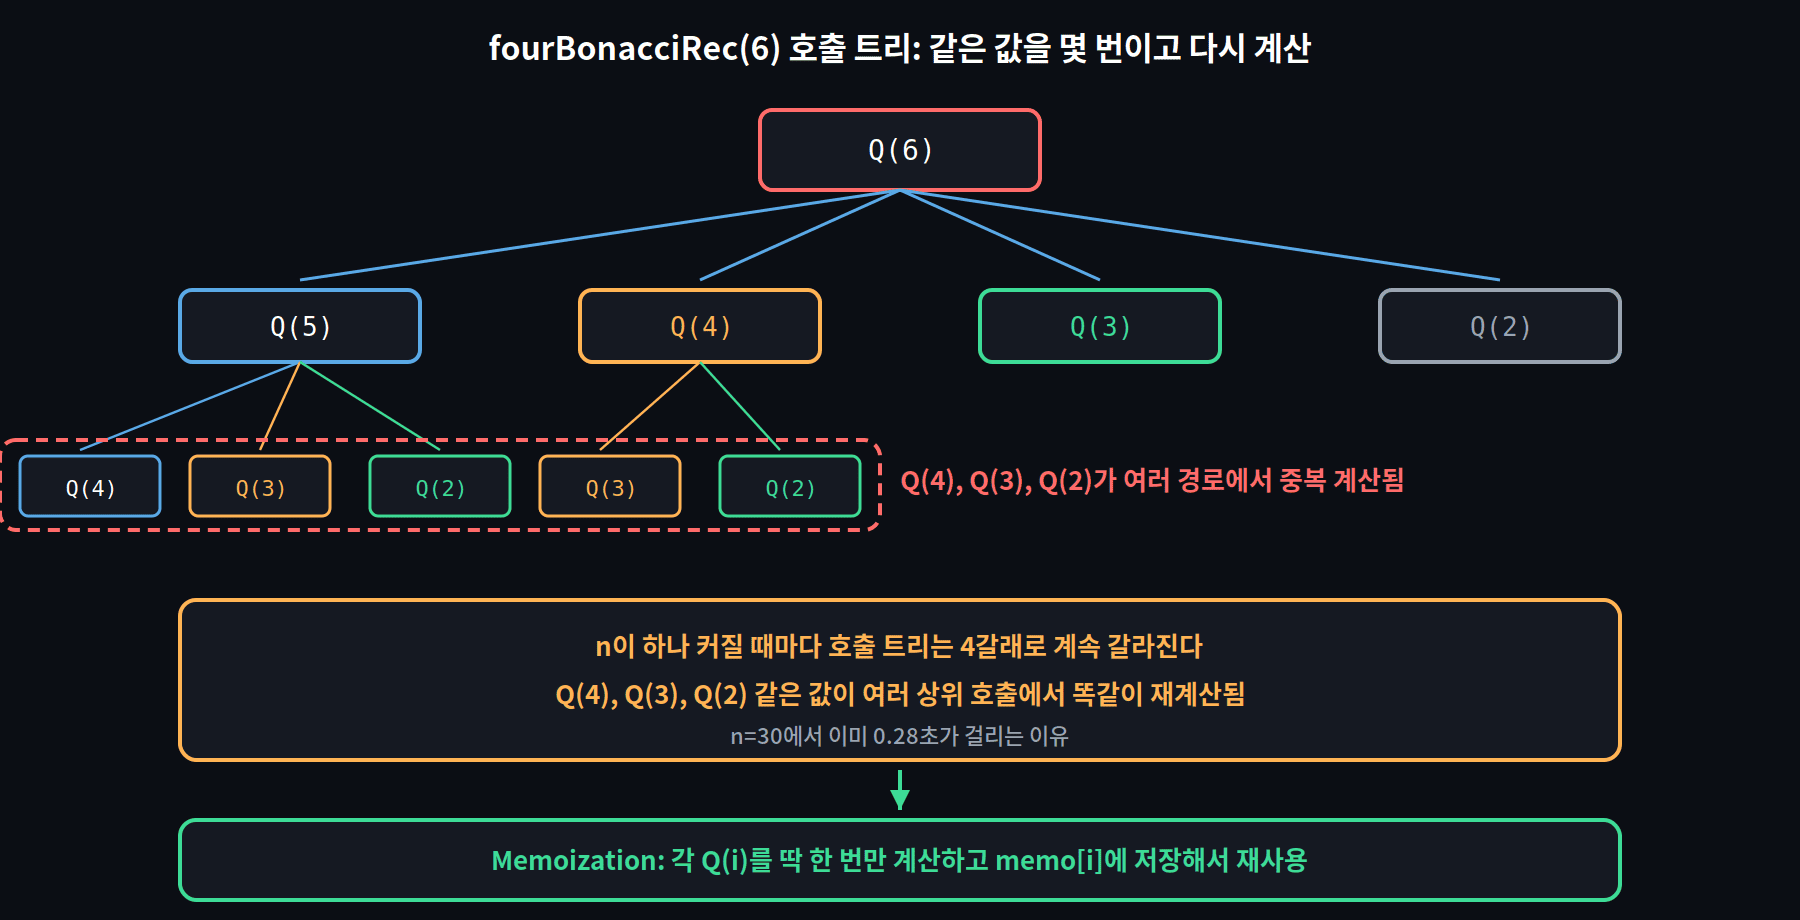
Q(6)을 계산하려면 Q(5), Q(4), Q(3), Q(2)를 각각 재귀 호출해야 하는데, 그중 Q(5)를 계산하는 과정에서 다시 Q(4), Q(3), Q(2)를 처음부터 계산하게 된다. Q(6)의 직접 자식으로 이미 계산했던 값들과 완전히 똑같은 계산을, Q(5)의 하위 호출에서 또 반복하는 것이다. n이 하나씩 커질 때마다 호출 트리가 4갈래로 계속 갈라지기 때문에, 이런 중복이 기하급수적으로 쌓인다.
Dictionary 기반 Memoization 구현하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
static func fourBonacciMemo(n: Int) -> Int {
    var memo = initMemo()
    return fourBonacciMemoHelper(n: n, memo: &memo)

    func fourBonacciMemoHelper(n: Int, memo: inout [Int: Int]) -> Int {
        if n <= 3 {
            return n
        } else {
            var result: Int = 0
            for i in (n-4)..<n {
                if let value = memo[i] {
                    // 이미 계산된 값을 재사용
                    result += value
                } else {
                    let value: Int = fourBonacciMemoHelper(n: i, memo: &memo)
                    memo[i] = value
                    result += value
                }
            }
            return result
        }
    }

    func initMemo() -> [Int: Int] {
        var memo = [Int: Int]()
        memo[0] = 0
        memo[1] = 1
        memo[2] = 2
        memo[3] = 3
        return memo
    }
}
핵심 아이디어는 단순하다. 어떤 n에 대한 값을 처음 계산하면 memo Dictionary에 저장해두고, 나중에 같은 n이 다시 필요할 때는 재계산하지 않고 저장된 값을 바로 꺼내 쓴다.
initMemo()는 기본값(Q0=0, Q1=1, Q2=2, Q3=3)이 채워진 Dictionary를 만든다. 이 값들은 문제에서 이미 주어진 값이라 계산할 필요가 없다fourBonacciMemoHelper가 실제 로직을 담당하는 지역 함수다.memo를inout으로 받아서, 재귀 호출 사이에 같은 Dictionary를 계속 공유하며 업데이트한다(n-4)..<n범위로 직전 4개 항을 순회하면서, 각i가 이미memo에 있으면(if let value = memo[i]) 그 값을 바로 쓰고, 없으면 재귀 호출로 계산한 뒤memo[i] = value로 저장해둔다
fourBonacciMemo 자체는 initMemo()로 초기 memo를 만들고 helper를 호출하는 두 줄이지만, 실질적인 작업은 helper 안에서 다 이뤄진다.
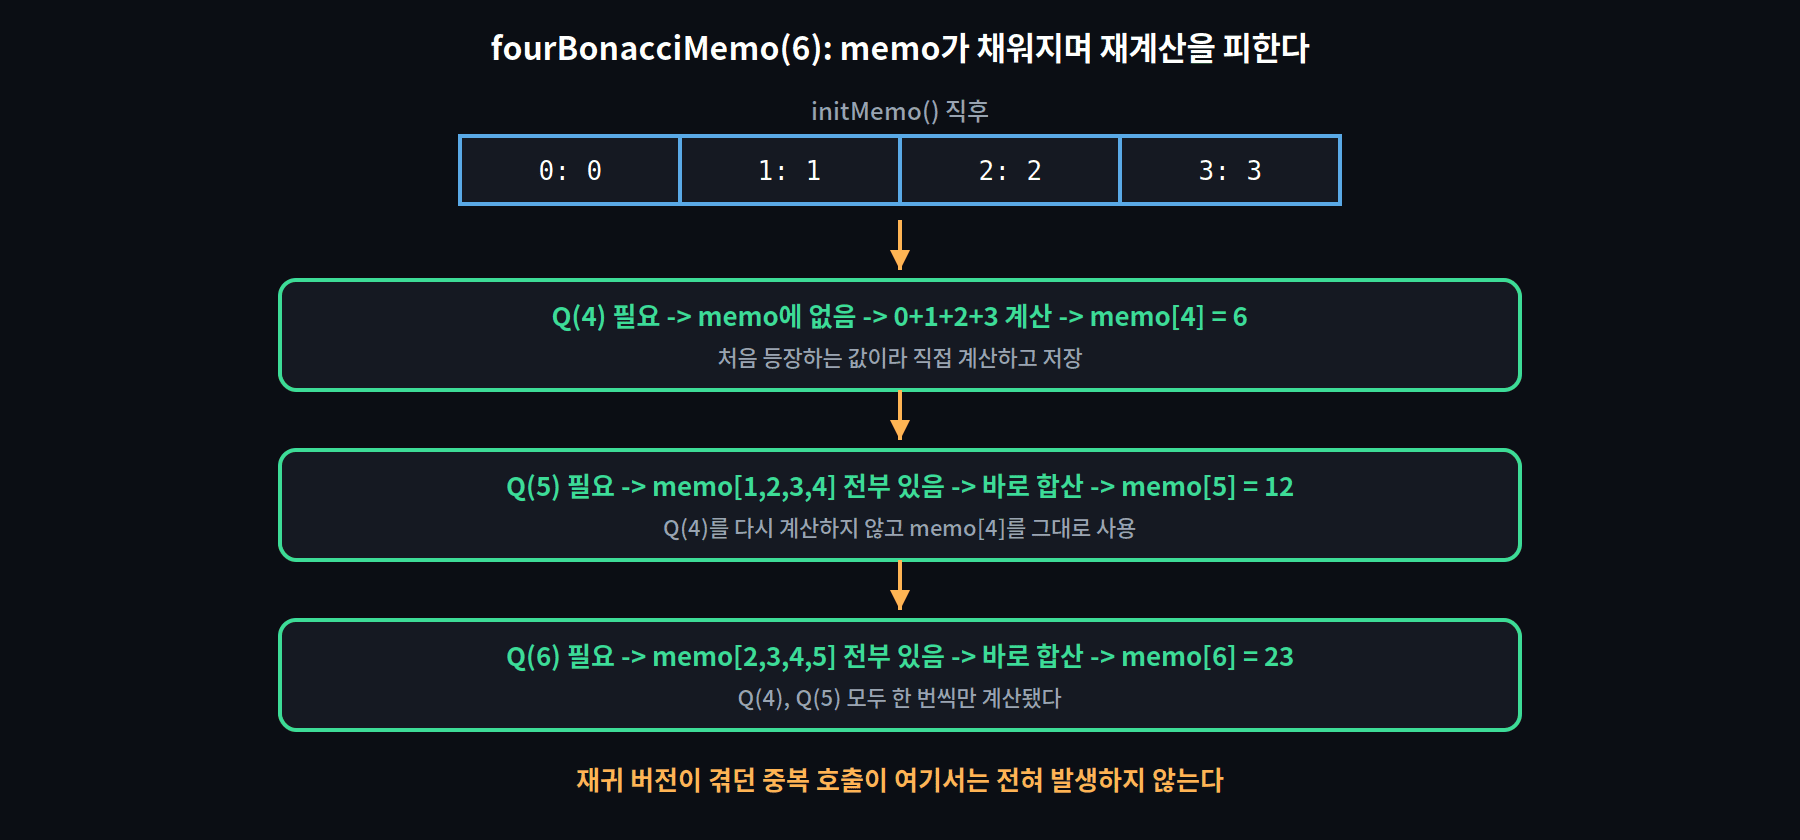
Q(4)를 처음 계산할 때만 실제로 0+1+2+3을 더하고, 그 결과를 memo[4]에 저장해둔다. 이후 Q(5), Q(6)을 계산할 때는 이미 memo에 있는 값(memo[1], memo[2], memo[3], memo[4], memo[5])을 그대로 꺼내 쓰기만 하면 된다. 앞서 재귀 버전이 겪었던 중복 계산이 여기서는 전혀 일어나지 않고, Q(4)와 Q(5) 모두 정확히 한 번씩만 계산된다.
Version 2: 배열 기반 구현, 그리고 “더 헷갈린다”는 솔직한 평가
같은 로직을 배열 기반으로 다시 구현해봤는데, 인덱스를 다루는 과정이 훨씬 헷갈렸다고 직접 언급했다. “이 게임은 정말 에러가 나기 쉽다”, “실제로 이걸 제대로 동작하게 만들기까지 디버깅을 꽤 해야 했다”고 평가했고, 최종적으로는 “Dictionary 기반의 첫 번째 버전을 쓰겠다”고 결론지었다. 두 버전 모두 효율성 면에서는 차이가 없지만, Version 2 쪽이 읽기에는 확실히 더 안 좋다는 것. 성능이 같다면 읽기 쉬운 쪽을 택하는 게 맞다는 원칙이 여기서도 재확인된다.
겪었던 문제: 정수 오버플로우와 BigInteger 도입
n = 100 같은 큰 입력을 테스트해보니 “arithmetic overflow”가 발생했다. four-bonacci 수열 값이 기본 Int의 표현 범위를 순식간에 넘어서기 때문이다. 이 문제를 해결하기 위해 Swift 패키지 생태계에서 큰 정수를 다루는 BigInt 라이브러리를 찾아서 프로젝트에 추가했다.
1
typealias BigInteger = BInt
라이브러리가 제공하는 실제 타입(BInt) 이름을 코드 전체에 직접 쓰는 대신, BigInteger라는 이름으로 typealias를 걸어뒀다. 이렇게 해두면 나중에 다른 BigInt 라이브러리로 바꾸고 싶을 때, 코드 전체에서 타입 이름을 일일이 바꾸는 대신 이 typealias 한 줄만 수정하면 된다.
흥미로운 실험: BigInteger를 Int로 바꿔봤더니 예상대로 오버플로우가 재현됐고, Double로 바꿔봤더니 신기하게도 컴파일은 되고 실행도 됐지만 값이 미묘하게 틀렸다. Double은 부동소수점이라 큰 수를 표현할 수는 있어도 정밀도가 떨어지기 때문에, 아주 큰 four-bonacci 값(예: 10^28 규모)을 계산하면 정확한 값과 아주 근소하게 어긋나는 결과가 나왔다. 이 실험을 통해 “왜 BigInt 같은 전용 타입이 필요한가”를 코드로 직접 확인한 셈이다.
진짜 페이백: measure{}로 재귀와 Memoization의 속도 차이를 실측하기
XCTest의 self.measure { }와 baseline 기능을 이용해서, 지금까지 만든 버전들의 실제 실행 시간을 측정해봤다.
1
2
3
4
5
6
7
8
9
10
11
func testPerformanceFourBonacciRec() throws {
    self.measure {
        print(part6Problems.fourBonacciRec(n: 30))
    }
}

func testPerformanceFourBonacciMemoBigInt() throws {
    self.measure {
        print(part6Problems.fourBonacciMemoBigInt(n: 3000))
    }
}
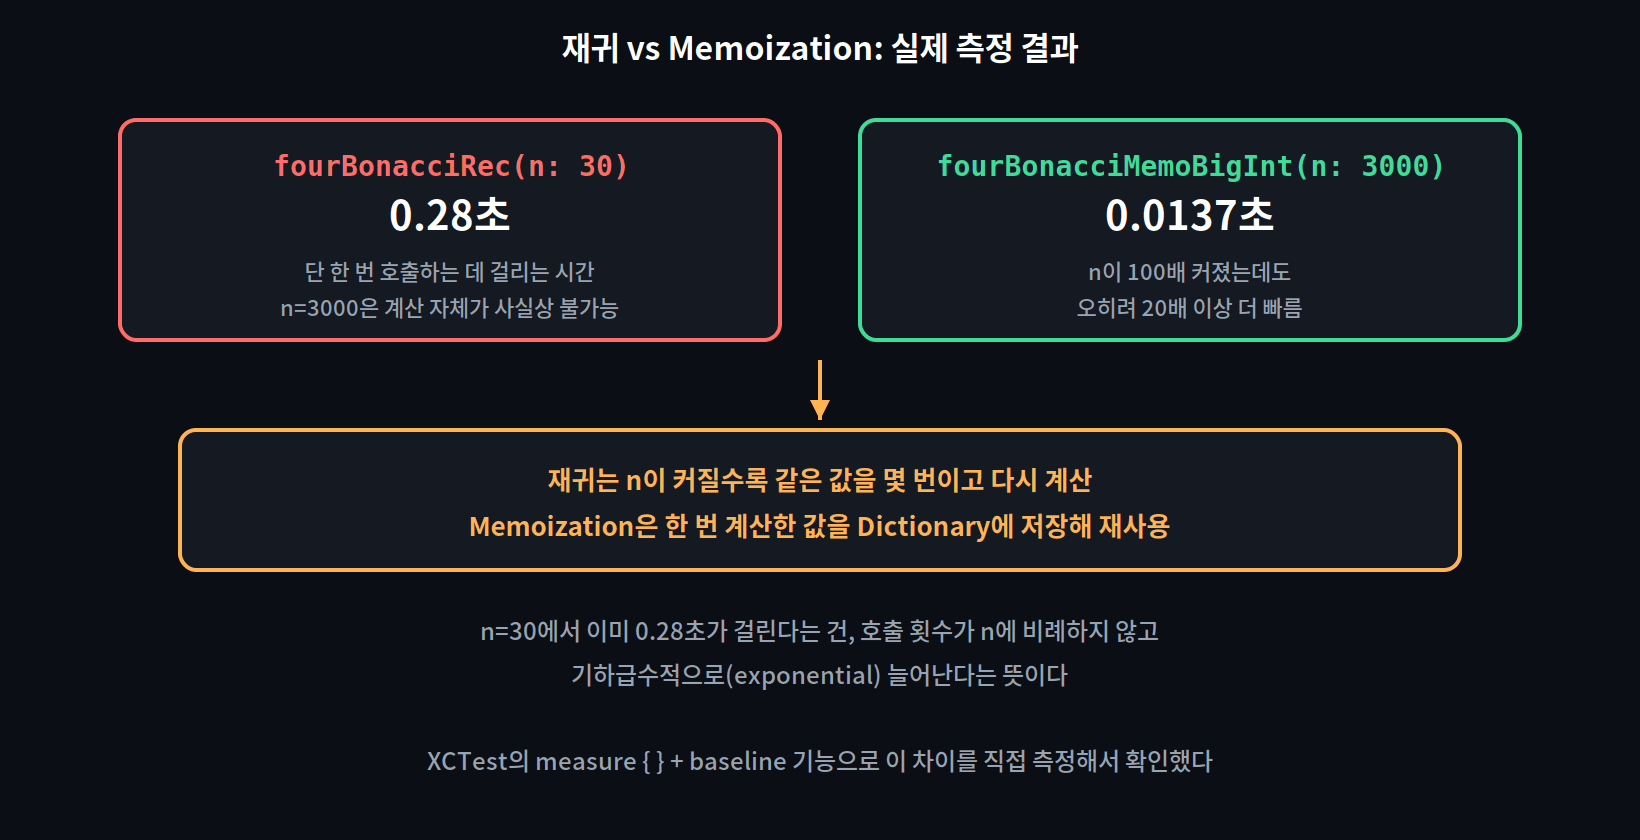
결과가 이 섹션 전체의 핵심이다.
fourBonacciRec(n: 30): 단 한 번 호출하는 데 평균 0.28초가 걸렸다.n = 30은 그렇게 큰 값도 아닌데, 이미 이 정도 시간이 걸린다는 건 호출 횟수가n에 비례하는 게 아니라 기하급수적으로(exponential) 늘어난다는 뜻이다. 실제로n = 3000같은 값을 재귀 버전에 넣으면 사실상 계산이 끝나지 않는다fourBonacciMemoBigInt(n: 3000):n이 100배나 큰데도 평균 0.0137초만에 끝났다. 재귀 버전이n=30에서 걸린 시간의 20분의 1 수준이다
Memoization이 없었다면 접근조차 못 했을 n=3000 같은 입력을, memoization을 적용하니 오히려 훨씬 작은 n=30의 재귀 버전보다 더 빠르게 처리해낸다. 이게 바로 Memoization이 존재하는 이유이자, 지금까지 이 강의에서 순수하게 “시간복잡도 개선”을 체감할 수 있었던 첫 번째 지점이다.
XCTest의 baseline 기능(측정값을 기준선으로 저장해두고, 이후 실행마다 그 기준선 대비 몇 % 빠른지/느린지 비교해주는 기능)도 함께 활용했는데, baseline을 한 번 설정해두면 코드를 리팩토링하거나 다른 구현으로 바꿀 때마다 “이전보다 나아졌는지”를 정량적으로 즉시 확인할 수 있다는 것도 확인했다.
번외: Rolling Array로 메모리까지 줄이기
이 섹션은 강의에서 다루지 않은 내용이다. Memoization의 메모리 트레이드오프를 이야기하다가, 그걸 한 단계 더 줄이는 기법이 있다는 걸 AI에게 물어보고 알게 됐다.
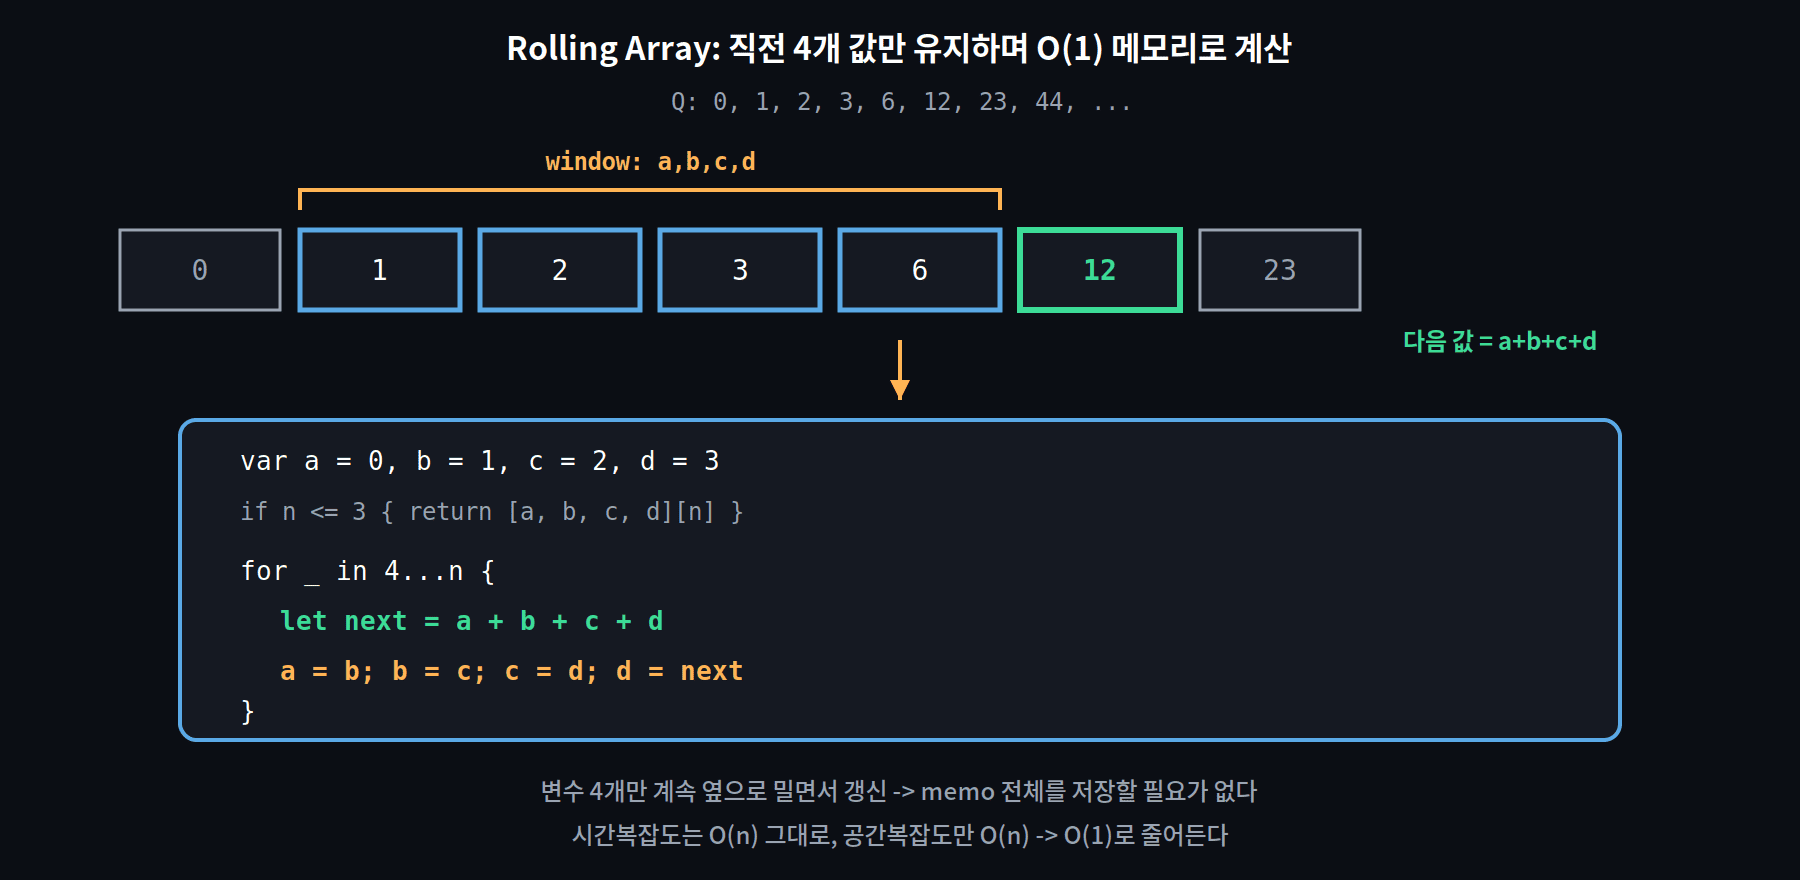
Dictionary 기반 memoization은 Q(0)부터 Q(n)까지 전부 저장해두기 때문에, n이 커질수록 메모리 사용량도 그만큼 늘어난다(공간복잡도 O(n)). 그런데 Q(n)을 계산하는 데 실제로 필요한 건 직전 4개 값뿐이다. 그보다 더 오래된 값들은 한 번 쓰이고 나면 다시는 참조되지 않는다. 이 점을 이용하면, 전체 이력을 Dictionary에 쌓아두는 대신 변수 4개만 계속 갱신하며 밀어내는 방식으로 메모리를 O(1)까지 줄일 수 있다. 이걸 rolling array(또는 rolling variable) 기법이라고 부른다(참고).
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
static func fourBonacciRolling(n: Int) -> Int {
    var a = 0, b = 1, c = 2, d = 3

    if n <= 3 {
        return [a, b, c, d][n]
    }

    for _ in 4...n {
        let next = a + b + c + d
        a = b
        b = c
        c = d
        d = next
    }

    return d
}
동작 방식은 이렇다.
a,b,c,d가 항상 “가장 최근 4개 값”만 들고 있는 슬라이딩 윈도우 역할을 한다- 매 반복마다
next = a + b + c + d로 다음 항을 구하고, 그 다음a = b; b = c; c = d; d = next로 윈도우를 한 칸씩 밀어낸다 - 반복이 끝나면
d가 곧Q(n)이다
시간복잡도는 memoization 버전과 마찬가지로 O(n)으로 동일하다. 달라지는 건 오직 공간복잡도뿐이다. memo Dictionary에 n개를 전부 저장하던 것(O(n))이, 변수 4개(O(1))로 줄어든다.
다만 이 최적화는 Q(n)이 오직 “바로 직전 몇 개의 값”에만 의존하는 문제에서만 적용된다. 만약 Q(50)처럼 중간의 특정 항 값을 나중에 다시 조회해야 하는 요구사항이 있다면, rolling array는 그 값을 이미 버렸기 때문에 쓸 수 없고 Dictionary 기반 memoization이 필요하다. 즉 “메모리를 얼마나 아낄 수 있는가”는 “과거 값을 나중에 다시 참조할 필요가 있는가”에 달려있다.
왜 정확히 4개인가
Q(n) = Q(n-1) + Q(n-2) + Q(n-3) + Q(n-4)라는 정의 자체가, 딱 이 네 항을 직접 더해야만 Q(n)을 구할 수 있다고 못박고 있다. 그중 하나라도 없으면 계산 자체가 불가능하다는 뜻에서 “4개가 필요”하다.
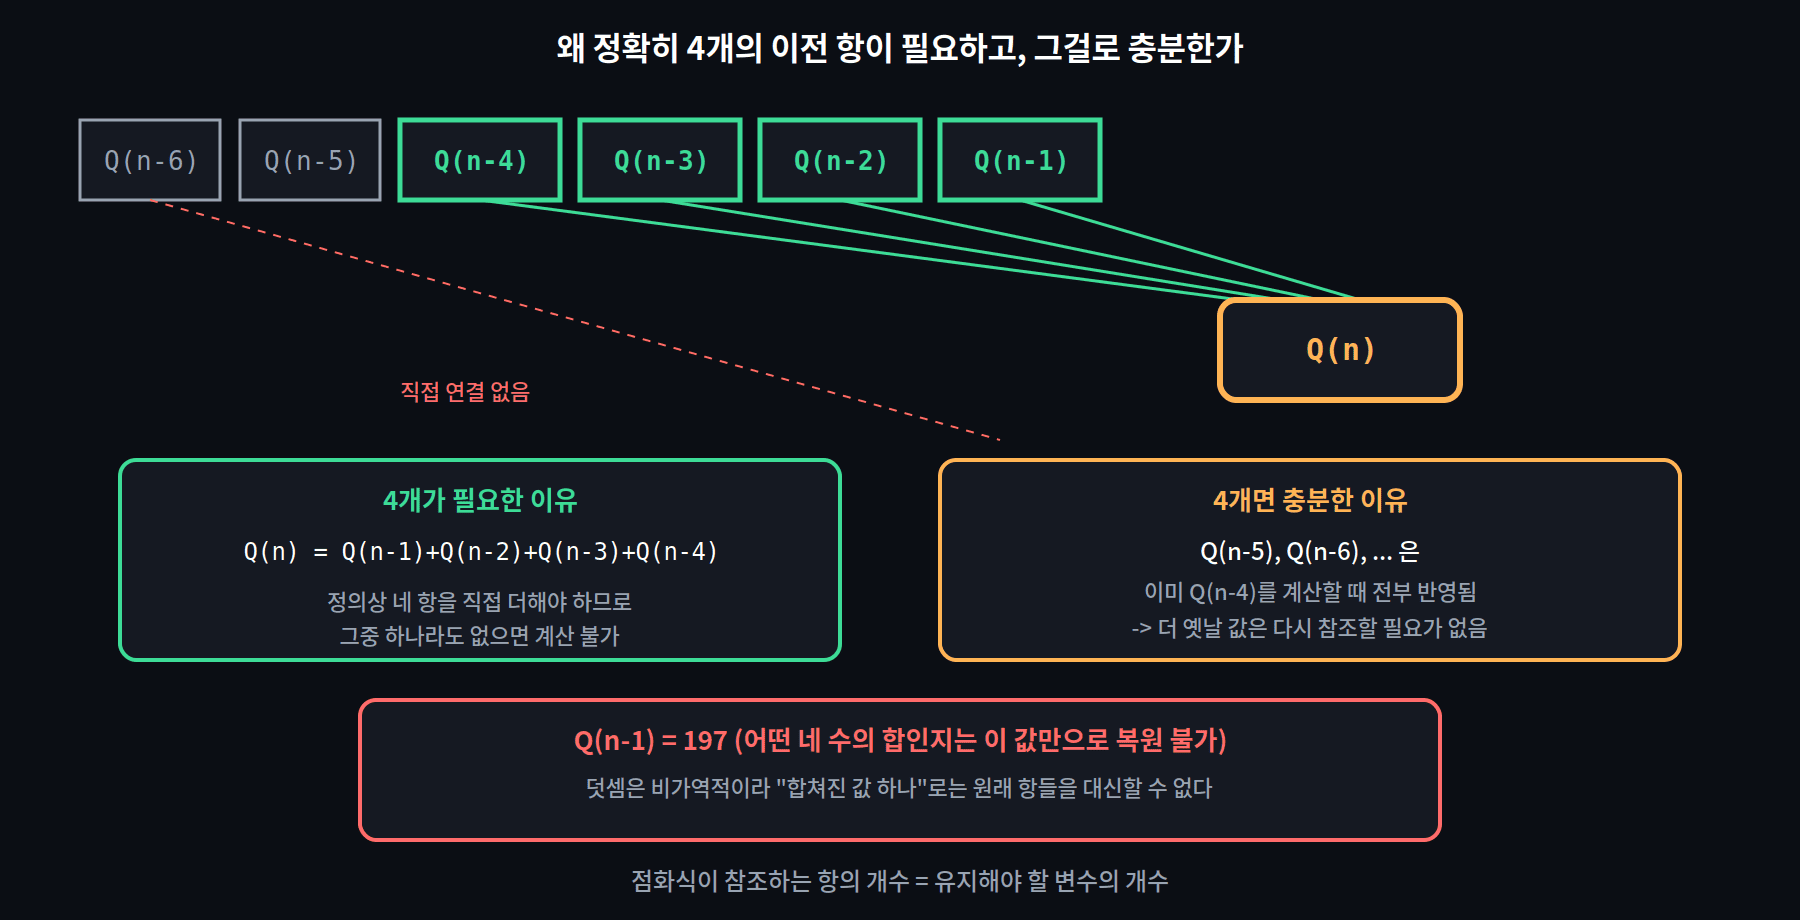
반대로 “4개보다 더 옛날 값(Q(n-5), Q(n-6), …)까지 들고 있어야 하지 않을까?”는 의문이 들 수 있는데, 그럴 필요는 없다. Q(n-5)나 그보다 옛날 값들은 이미 Q(n-4)를 계산하는 시점에 전부 그 계산 안에 녹아들어갔기 때문이다. Q(n-4)라는 숫자 하나가 사실상 “그 이전의 모든 히스토리를 압축해서 담고 있는 값”인 셈이라, Q(n)을 구하는 입장에서는 Q(n-4)만 있으면 그 이전 값들을 따로 들고 있을 이유가 없다.
Q(n-1) = 197처럼 이미 여러 항을 더해서 나온 값 하나만 봐서는, 그게 원래 어떤 네 개의 숫자를 더한 결과인지 되짚을 방법이 없다(덧셈은 비가역적이다). 그래서 “예전 값을 나중에 다시 쓸 일이 없다”는 전제가 성립하는 한, 점화식이 참조하는 항의 개수만큼만 변수를 들고 있으면 충분하다. Fibonacci가 변수 2개(Q(n-1), Q(n-2))로 충분한 것도, four-bonacci가 4개가 필요한 것도 전부 같은 원리다 — 점화식이 몇 개의 이전 항을 직접 참조하느냐가, 그대로 유지해야 할 변수의 개수를 결정한다.
factorial, power, binomial — Memoization이 항상 만능은 아니다
Memoization을 몇 가지 문제에 더 적용해보면서, 재귀 구조에 따라 Memoization의 효과가 크게 달라진다는 걸 확인한다.
factorial: 재귀와 Memoization을 나란히 구현하기
1
2
3
4
0! = 1
1! = 1
2! = 1*2
n! = n * (n-1)!, n >= 1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
static func factorialRec(n: Int) -> BigInteger {
    n == 0 ? 1 : n * factorialRec(n: n-1)
}

static func factorialMemo(n: Int) -> BigInteger {
    var memo: [Int: BigInteger] = [:]

    return factorialMemoHelper(n: n, memo: &memo)

    func factorialMemoHelper(n: Int, memo: inout [Int: BigInteger]) -> BigInteger {
        if let result = memo[n] {
            return result
        } else if n == 0 {
            return 1
        } else {
            let result = n * factorialMemoHelper(n: n-1, memo: &memo)
            memo[n] = result
            return result
        }
    }
}
factorialRec은 정의 그대로 한 줄로 짧게 구현했다. factorialMemo는 지금까지와 같은 패턴으로 memo Dictionary와 헬퍼 함수를 쓴다.
두 구현 모두 BigInteger(앞서 만든 typealias)를 반환하는데, n을 큰 값으로 넣으면 factorial 값도 순식간에 Int 범위를 넘어서기 때문이다.
겪었던 발견: Memoization이 factorial에는 전혀 도움이 안 됐다
self.measure { }로 factorialRec과 factorialMemo의 성능을 비교해봤는데, 결과가 거의 똑같이 나왔다. “이건 좀 실망스럽다”고 직접 언급할 정도였다. 이유를 breakpoint로 직접 추적해봤다.
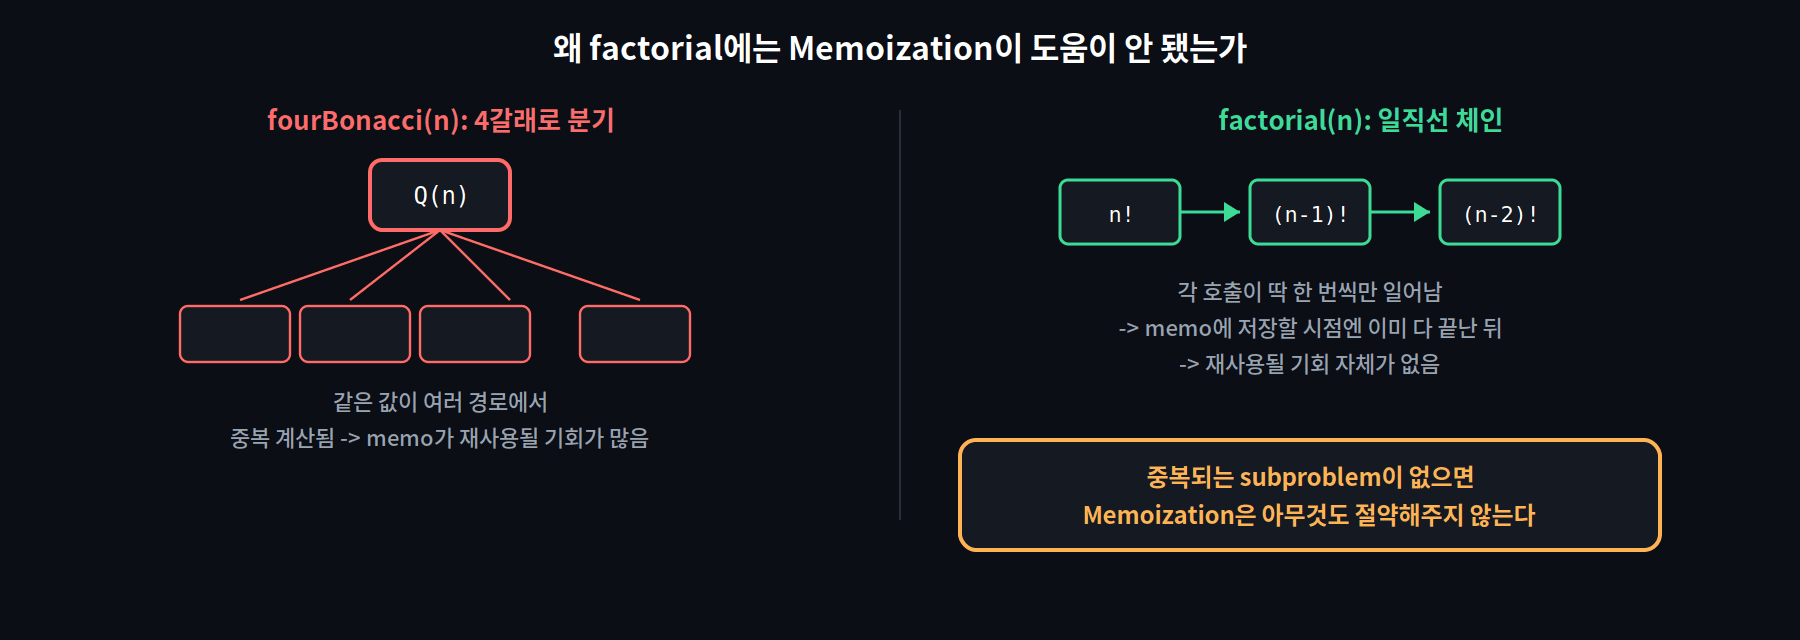
factorialMemoHelper에서 memo[n] = result로 저장하는 시점을 breakpoint로 찍어보니, 그 줄에 도달하기도 전에 이미 재귀 호출이 한 번씩만 일어나고 끝나버린다는 게 확인됐다. factorial(n)은 factorial(n-1)을 딱 한 번만 호출하고, 그 factorial(n-1)도 factorial(n-2)를 딱 한 번만 호출하는 식으로, 호출 경로가 가지 하나 없이 일직선으로 쭉 이어진다. 즉 애초에 같은 부분 문제(subproblem)가 중복해서 요청될 일이 없다.
fourBonacciRec이 4갈래로 갈라지면서 같은 값(Q(4), Q(3) 등)을 여러 경로에서 반복 계산했던 것과 정반대다. Memoization은 “같은 계산을 여러 번 하게 될 때” 그 중복을 없애주는 기법인데, factorial처럼 애초에 중복이 없는 구조에서는 memo에 값을 저장해봤자 그 값을 다시 꺼내 쓸 일 자체가 없다. 저장 공간만 쓰고 아무 이득도 없는 것.
이 발견은 Memoization을 적용하기 전에 “이 재귀 구조에 정말 중복되는 부분 문제가 있는가”를 먼저 따져봐야 한다는 걸 보여준다. 무작정 memo를 갖다 붙인다고 항상 빨라지는 게 아니다.
power: 커스텀 키 타입으로 Dictionary 활용하기
base의 exponent 제곱을 재귀와 Memoization으로 구현한다.
1
2
3
power(base: 2, exponent: 0) -> 1
power(base: 3, exponent: 5) -> 243
power(base: 9, exponent: 10) -> 3_486_784_401
(Int, Int) 튜플은 Hashable을 만족하지 않아서 Dictionary key로 바로 쓸 수 없다. 문자열로 키를 만드는 방법("\(base) \(exponent)")도 고려했지만 마음에 들지 않아서, 대신 Hashable을 채택한 전용 struct를 만들었다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
struct PowerExp: Hashable {
    let base: Int
    let exponent: Int
}

static func power(base: Int, exponent: Int) -> BigInteger {
    var memo: [PowerExp: BigInteger] = [:]

    return powerHelper(base: base, exponent: exponent, memo: &memo)

    func powerHelper(base: Int, exponent: Int, memo: inout [PowerExp: BigInteger]) -> BigInteger {
        if exponent == 0 {
            return 1
        }

        let key = PowerExp(base: base, exponent: exponent - 1)
        if let result = memo[key] {
            return BigInteger(base * result)
        } else {
            let result = base * powerHelper(base: base, exponent: exponent - 1, memo: &memo)
            memo[key] = result
            return result
        }
    }
}
PowerExp(base:exponent:)를 key로 써서, “이 base의 이 exponent제곱을 이미 계산했는지”를 Dictionary로 조회한다. exponent == 0이면 base case로 1을 반환하고, 아니면 exponent - 1에 대한 결과가 memo에 있는지 먼저 확인한 뒤, 없으면 재귀 호출로 계산해서 저장한다.
binomial: Pascal의 항등식으로 재귀 관계 세우기
이항계수(binomial coefficient) C(n, k)는 n개의 원소 중 순서 상관없이 k개를 고르는 경우의 수다. n=4, k=2라면 {A,B,C,D}에서 두 개를 고르는 방법은 AB, AC, AD, BC, BD, CD 6가지다.
이 문제는 Pascal의 항등식이라는 유명한 재귀 관계를 쓴다.
1
C(n, k) = C(n-1, k-1) + C(n-1, k)
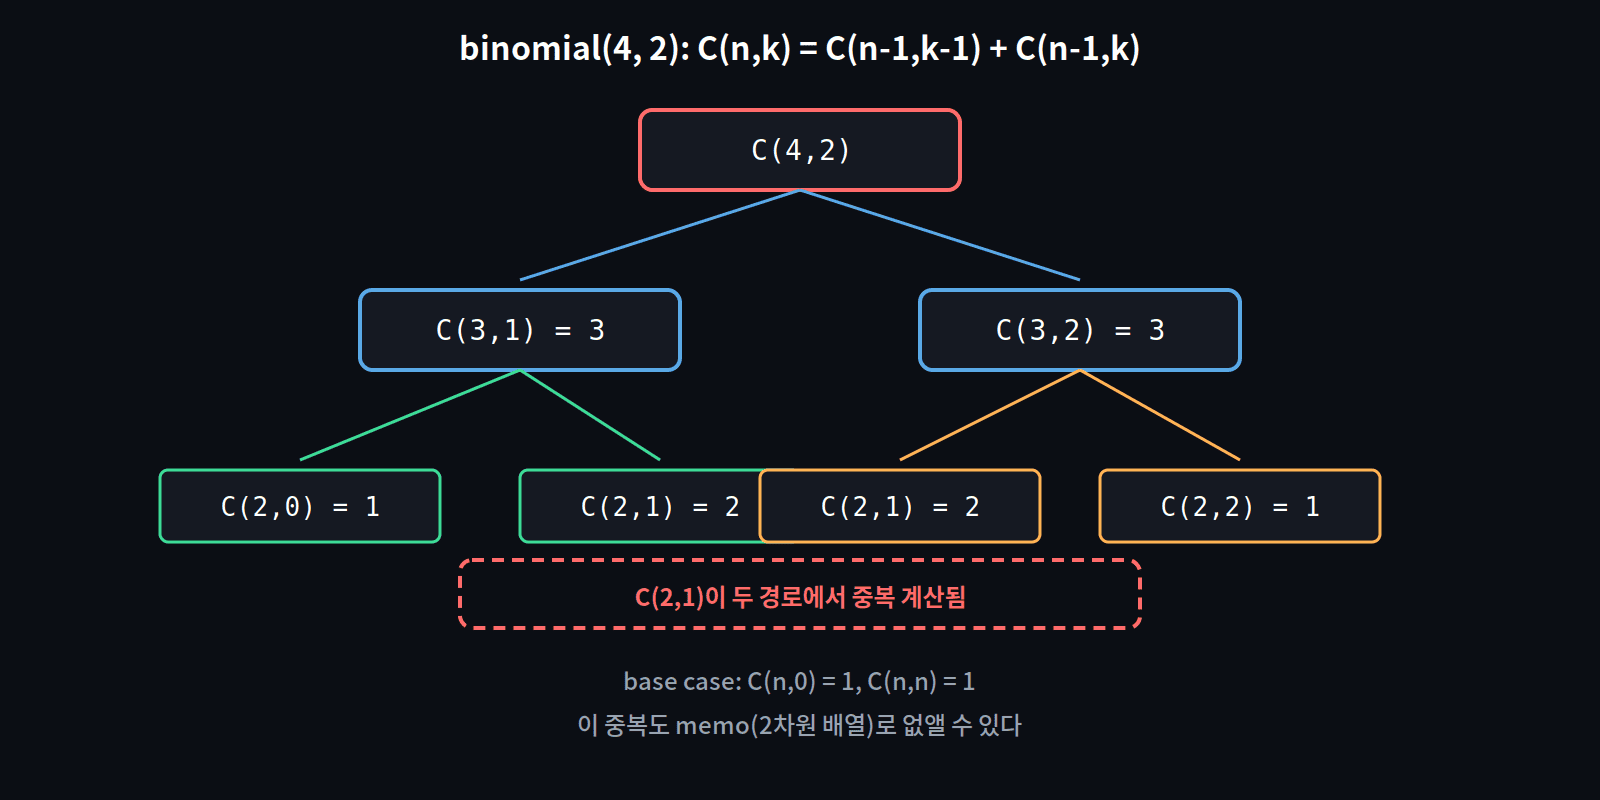
C(4,2)를 이 관계로 손으로 풀어보면, C(3,1) + C(3,2)로 나뉘고, 그 각각이 다시 C(2,0)+C(2,1)과 C(2,1)+C(2,2)로 나뉜다. 여기서 C(2,1)이 두 경로에서 똑같이 다시 계산된다는 걸 알 수 있다. fourBonacciRec에서 봤던 것과 같은 종류의 중복이라, 이번엔 Memoization이 확실히 도움이 되는 구조다.
k <= n이라는 전제를 좀 더 일반화해서, n이나 k가 음수이거나 k > n인 경우엔 0을 반환하도록 확장했다(정의를 좀 더 관대하게 넓힌 것).
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
static func binomial(n: Int, k: Int) -> BigInteger {
    if k > n || n < 0 || k < 0 {
        return 0
    }
    if k == 0 || k == n {
        return 1
    }

    let kk: Int = (k > n / 2 ? n - k : k)

    var memo: [[BigInteger]] = Array(
        repeating: Array(repeating: 0, count: kk + 1),
        count: n + 1)

    for i in 0...n {
        memo[i][0] = 1
    }

    for i in 1...n {
        for j in 1...min(i, kk) {
            memo[i][j] = memo[i-1][j-1] + memo[i-1][j]
        }
    }

    return memo[n][kk]
}
여기서는 Dictionary 대신 2차원 배열([[BigInteger]])을 memo로 쓴다. Array(repeating:count:)를 중첩해서 (n+1) × (kk+1) 크기의 표를 만들고, 전부 0으로 초기화한다. kk는 k와 n-k 중 더 작은 쪽을 택한 값인데, 이항계수는 C(n,k) = C(n,n-k)라는 대칭성이 있어서, 굳이 k가 크더라도 n-k가 더 작으면 그쪽 기준으로 표의 열 개수를 줄여서 불필요한 계산과 메모리를 아낄 수 있다.
memo[i][0] = 1로 각 행의 첫 번째 base case(C(i, 0) = 1)를 먼저 채우고, 그다음 이중 for 루프로 Pascal의 항등식(memo[i][j] = memo[i-1][j-1] + memo[i-1][j])을 적용해서 표를 아래에서 위로(bottom-up) 채워나간다. 안쪽 루프에서 j의 범위를 1...min(i, kk)로 제한한 것도 눈여겨볼 만하다. 어차피 i보다 크거나 kk보다 큰 j는 계산할 필요가 없는 값들이라, 딱 필요한 범위까지만 계산해서 낭비를 줄인다.
세 함수를 한 번에 검증하는 테스트
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
func testFactorial() {
    let data = [0, 1, 2, 3, 4, 5, 6, 10, 11, 12]
    let expectedValues: [BigInteger] = [1, 1, 2, 6, 24, 120, 720, 3628800, 39916800, 479001600]

    for i in 0..<data.count {
        let n = data[i]
        let expected = expectedValues[i]
        XCTAssertEqual(part6Problems.factorialRec(n: n), expected)
        XCTAssertEqual(part6Problems.factorialMemo(n: n), expected)
    }
}

func testPower() {
    let data = [(2,0), (3,5), (6,4), (9,10), (10,9)]
    let expectedValues: [BigInteger] = [1, 243, 1296, 3_486_784_401, 1_000_000_000]

    for i in 0..<data.count {
        let expected = expectedValues[i]
        let value = part6Problems.power(base: data[i].0, exponent: data[i].1)
        XCTAssertEqual(value, expected)
    }
}

func testBinomial() {
    let values = [(4, 2), (10, 0), (7, 3)]
    let expected: [BigInteger] = [6, 1, 35]

    for i in 0..<values.count {
        XCTAssertEqual(expected[i], part6Problems.binomial(n: values[i].0, k: values[i].1))
    }
}
세 테스트 모두 통과했다. testFactorial()에서는 재귀 버전과 memo 버전을 같은 기대값으로 나란히 검증해서, 두 구현이 최소한 정확성 면에서는 동일하다는 걸 재확인했다(성능이 같았던 건 이미 확인했으니).
Part 6 UI: 기록할 만한 패턴만
Fourbonacci_View, Factorial_View, Power_View, Binomial 네 화면을 만드는 과정은 대부분 이전에 본 패턴(슬라이더 + 결과 표시)의 반복이라 대부분 생략하고, 새롭게 기록해둘 만한 패턴 몇 가지만 남긴다.
긴 스크롤 목록에 주기적으로 빈 줄 끼워넣기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
struct Fourbonacci_View: View {
    let max = 1000
    let skipLine = 5

    var body: some View {
        ScrollView(showsIndicators: false) {
            ForEach(0..<max, id: \.self) { n in
                Text(part6Problems.fourBonacciMemoBigInt(n: n).description)
                    .multilineTextAlignment(.center)
                if (n + 1) % skipLine == 0 {
                    Text("")
                }
            }
        }.padding()
    }
}
숫자 1000개를 그냥 쭉 나열하면 눈으로 구간을 구분하기 어렵다. (n + 1) % skipLine == 0으로 5의 배수 지점마다 빈 Text("")를 하나 끼워넣어서, 시각적으로 5줄씩 끊어 보이게 만든다. Factorial_View도 max, skipLine 값만 다르고 동일한 구조를 그대로 재사용한다. 큰 정수(fourBonacciMemoBigInt, factorialMemo) 자체를 실제로 계산해서 화면에 1000개씩 뿌려도 버벅이지 않고 스크롤된다는 게, 앞서 만든 memoization + BigInteger 조합이 실전에서도 제대로 동작한다는 걸 눈으로 보여주는 지점이기도 하다.
지수를 위첨자(superscript) 유니코드로 표시하기
1
2
3
4
5
6
7
8
var superscriptDigits: [String: String] = [
    "0": "⁰", "1": "¹", "2": "²", "3": "³", "4": "⁴",
    "5": "⁵", "6": "⁶", "7": "⁷", "8": "⁸", "9": "⁹",
]

var arrayExponent: [Character] {
    Array(String(iExponent))
}
1
2
3
4
5
6
7
8
9
HStack(spacing: 0) {
    Text("\(iBase)")
    ForEach(arrayExponent, id: \.self) { ch in
        Text("\(superscriptDigits[String(ch)] ?? "")")
    }
    Text(" = ")
}
.font(.largeTitle)
.bold()
base^exponent를 진짜 수학 표기처럼 보여주려고, 지수의 각 자릿수를 위첨자 유니코드 문자(⁰¹²³...)로 매핑하는 Dictionary를 만들었다. iExponent(정수)를 문자열로 바꾸고 다시 Character 배열(arrayExponent)로 쪼갠 다음, ForEach로 한 글자씩 순회하며 superscriptDigits에서 대응하는 위첨자 문자를 찾아 렌더링한다. 예를 들어 지수가 300이면 "3", "0", "0" 세 글자를 각각 ³, ⁰, ⁰로 변환해서 이어붙이는 식이다. 폰트 크기를 키우거나 별도 글꼴을 쓰지 않고도, 표준 유니코드 문자만으로 “진짜 위첨자처럼 보이는” 수식 표기를 만들어내는 방법이다.
이항계수 표기를 세로로 쌓인 괄호로 표현하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
HStack {
    Text("(")
        .font(.largeTitle)
        .scaleEffect(y: 2)
        .offset(CGSize(width: 0, height: -5))

    VStack {
        Text("\(iN)")
        Text("\(iK)")
    }.font(.title)

    Text(")")
        .font(.largeTitle)
        .scaleEffect(y: 2)
        .offset(CGSize(width: 0, height: -5))

    Text(" = ")
        .font(.largeTitle)
}.bold()
이항계수 표기(n이 위, k가 아래에 오고 그 전체를 큰 괄호가 감싸는 형태)를 SwiftUI 기본 컴포넌트만으로 흉내냈다. 괄호 문자 하나를 .scaleEffect(y: 2)로 세로로만 2배 늘려서 위아래로 길쭉한 괄호처럼 보이게 만들고, .offset으로 위치를 살짝 조정해서 가운데의 VStack(위에 n, 아래에 k)과 높이가 맞도록 맞춘다. 특수 폰트나 이미지 없이 순수 텍스트 변형만으로 수식에 가까운 표기를 구현한 사례다.
대칭성 최적화의 체감 효과를 실제로 확인하기
Binomial 화면에서 n = 1000, k를 슬라이더로 조절해보면, k가 0이나 1000에 가까울 땐 즉각 반응하지만 k가 500 근처(가운데)로 갈수록 계산이 눈에 띄게 느려지는 게 체감된다. 이건 앞서 binomial 함수에서 kk = min(k, n-k)로 표(memo)의 열 크기를 줄였던 최적화가 실제로 어떤 효과를 내는지 보여주는 지점이다. k = 932일 때 kk는 1000 - 932 = 68로 훨씬 작아지므로, memo 배열의 크기 자체가 933칸이 아니라 69칸으로 줄어들어 계산이 눈에 띄게 빨라진다. 코드 한 줄의 최적화(k 대신 kk 사용)가 실제 사용자 체감 성능에 얼마나 큰 차이를 만드는지, 슬라이더를 움직여보는 것만으로 확인할 수 있다.