Swift Algorithms (6) - Dictionaries
Part 4 시작: Dictionary로 문자 빈도 세기
새 주제인 Dictionary를 다룬다. 첫 문제는 문자열 text가 주어졌을 때 가장 자주 등장하는 문자를 반환하는 mostPopularCharacter다. 빈도가 같으면(tie) ASCII 값이 더 작은 문자를 반환한다. 대문자와 소문자는 다른 문자로 취급한다('A' < 'a').
예시:
1
2
3
4
5
mostPopularCharacter("")               -> nil
mostPopularCharacter("Hello World")    -> ("l", 3)
mostPopularCharacter("gggcccbb")       -> ("c", 3)
mostPopularCharacter("bggbgcccbbb")    -> ("b", 5)
mostPopularCharacter("aaabbbdddtttccc") -> ("a", 3)
"gggcccbb"가 흥미로운 케이스다. 'g'도 3번, 'c'도 3번 나와서 개수로는 동점인데, 'c'의 ASCII 값(99)이 'g'의 ASCII 값(103)보다 작으므로 'c'가 정답이 된다.
Dictionary로 빈도 세기
1
2
3
4
5
var countChars: [Character: Int] = [:]

for ch in text {
    countChars[ch, default: 0] += 1
}
text를 순회하면서 각 문자를 key로, 등장 횟수를 value로 세는 Dictionary를 만든다. countChars[ch, default: 0] += 1이 핵심인데, default: 파라미터 덕분에 ch가 아직 Dictionary에 없어도 “값이 없으면 0으로 취급하고 +1하라”는 걸 한 줄로 처리할 수 있다. 별도로 “이 키가 존재하는지 먼저 확인하고, 없으면 초기화하고, 있으면 증가시키는” 분기를 직접 짤 필요가 없다.
최댓값과 동점 처리: max(by:)
1
2
3
4
5
let result = countChars
    .max(by: {
        $0.value < $1.value ||
        ($0.value == $1.value && $0.key > $1.key)
    })
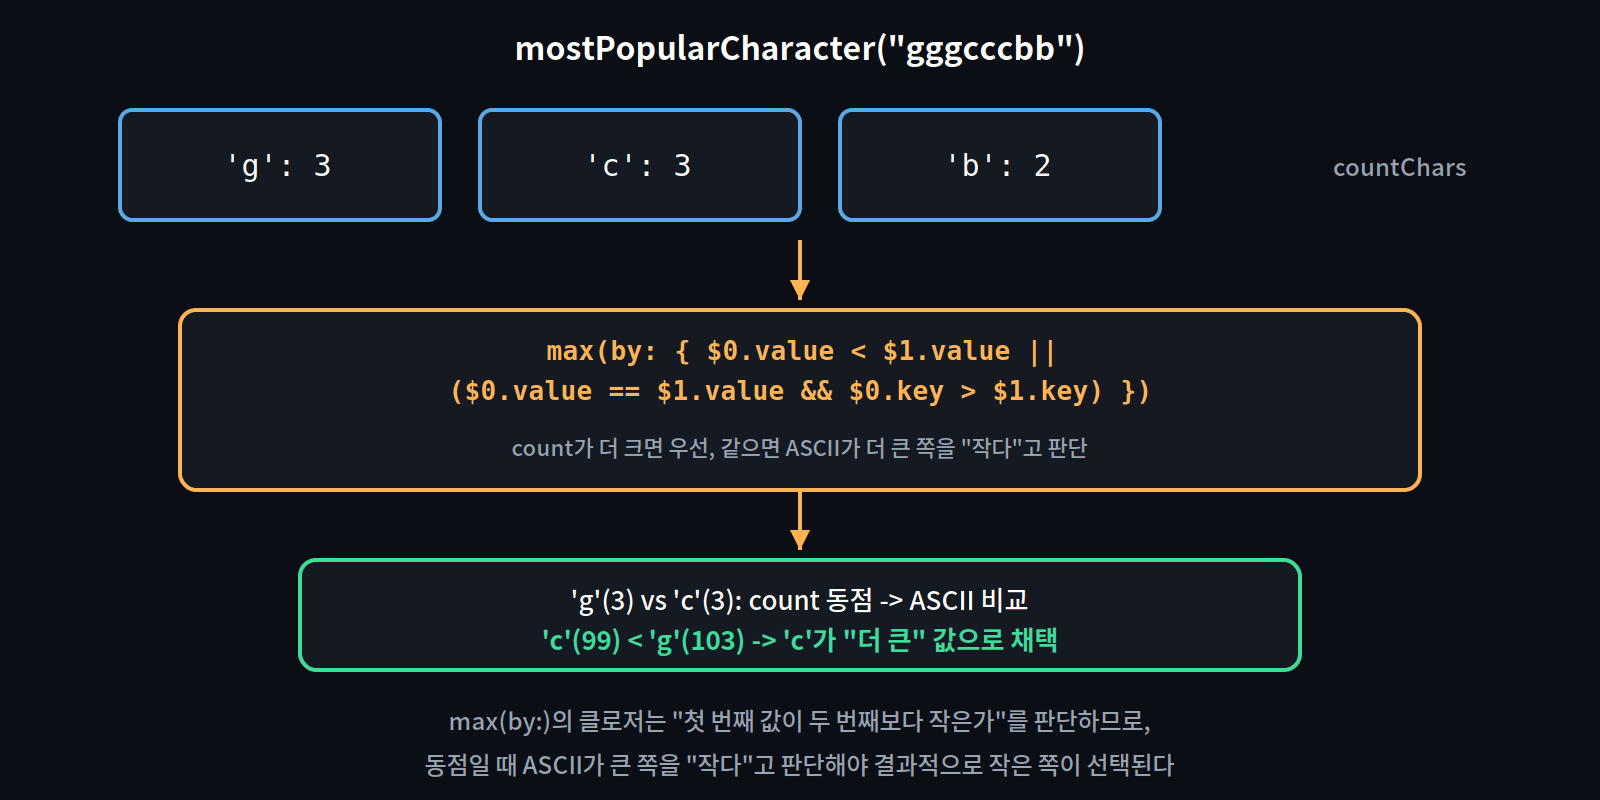
Dictionary를 순회하면 (key, value) 쌍이 나오는데, max(by:)에 넘기는 클로저는 “첫 번째 인자가 두 번째보다 작은가”를 판단하는 규칙이다. 이 규칙을 만족하는 원소가 상대적으로 “작은” 쪽으로 취급되고, 최종적으로 그 규칙에서 한 번도 “작다”고 판정되지 않은 원소가 max로 뽑힌다.
$0.value < $1.value: 등장 횟수가 더 적으면 당연히 “작다”$0.value == $1.value && $0.key > $1.key: 등장 횟수가 같다면(동점), key(문자)의 ASCII 값이 더 큰 쪽을 “작다”고 판단한다. 그래야max가 결과적으로 ASCII 값이 더 작은 쪽을 선택하게 되기 때문이다
'g'(3)와 'c'(3)를 비교하면, value는 같으니 두 번째 조건으로 넘어가서 'c' > 'g'인지 확인한다. ASCII 기준으로 'c'(99)는 'g'(103)보다 작으므로 $0.key > $1.key는 'g'가 $0일 때만 참이 되고, 결국 'c'가 “더 크다(=max)”고 판정되어 'c'가 선택된다.
결과 타입 정리하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
static func mostPopularCharacter(text: String) -> (str: Character, maxCount: Int)? {
    var countChars: [Character: Int] = [:]

    for ch in text {
        countChars[ch, default: 0] += 1
    }

    let result = countChars
        .max(by: {
            $0.value < $1.value ||
            ($0.value == $1.value && $0.key > $1.key)
        })

    if let result {
        return (result.key, result.value)
    } else {
        return nil
    }
}
countChars.max(by:)는 (key: Character, value: Int)? 타입을 반환하는데, 함수 시그니처에서 선언한 반환 타입 (str: Character, maxCount: Int)?와는 필드 이름이 다른 별개의 튜플 타입이라 그대로 반환할 수 없다. if let result로 값을 꺼낸 뒤 (result.key, result.value)로 새 튜플을 만들어서 반환해야 한다. 또한 함수 시그니처를 정할 때 처음엔 (maxCount: Int, str: Character)처럼 개수를 앞에 뒀는데, key-value 쌍이라는 의미에 맞게 (str: Character, maxCount: Int)로 순서를 바꾸는 게 더 자연스럽다고 판단해서 순서를 정리했다.
Swifty 버전: reduce(into:)로 Dictionary 만들기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
static func mostPopularCharacterSwifty(text: String) -> (str: Character, maxCount: Int)? {
    let countChars = text
        .reduce(into: [:]) {
            $0[$1, default: 0] += 1
        }

    let result = countChars
        .max(by: {
            $0.value < $1.value ||
            ($0.value == $1.value && $0.key > $1.key)
        })

    if let result {
        return (result.key, result.value)
    } else {
        return nil
    }
}
for ch in text { countChars[ch, default: 0] += 1 }로 짠 루프를, text.reduce(into: [:]) { $0[$1, default: 0] += 1 } 한 줄로 대체했다. reduce(into:_:)는 일반 reduce(_:_:)와 달리, 매번 새 값을 반환하는 게 아니라 누적 대상($0)을 직접 변경(mutate)하는 방식이라 Dictionary처럼 참조가 아닌 값 타입 컬렉션을 누적할 때 특히 편리하다. max(by:) 이후 로직은 명령형 버전과 완전히 동일하다.
Unit Test로 검증하기
이번엔 UI보다 먼저 unit test를 작성했다. UI를 만들 에너지가 없더라도 최소한 로직이 맞는지는 테스트로 확인할 수 있어야 한다는 이유였다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
final class Part4Tests: XCTestCase {
    func testMostPopularCharacter() {
        // Setup 1
        var text = ""
        var expectedValue: (str: Character, maxCount: Int)? = nil

        // Test 1
        XCTAssertNil(part4Problems.mostPopularCharacter(text: text))

        // Setup 2
        text = "Hello World"
        expectedValue = ("l", 3)

        // Test 2
        XCTAssertEqual(expectedValue?.str, part4Problems.mostPopularCharacter(text: text)?.str)
        XCTAssertEqual(expectedValue?.maxCount, part4Problems.mostPopularCharacter(text: text)?.maxCount)

        // 이하 "gggcccbb", "bggbgcccbbb", "aaabbbdddtttccc" 케이스도 같은 패턴으로 반복
    }
}
몇 가지 짚을 부분이 있다.
- 빈 문자열 케이스는 결과 자체가
nil이어야 하므로XCTAssertNil을 쓴다. 이건XCTAssertEqual(result, nil)과 실질적으로 같지만, “이 값이nil이어야 한다”는 의도를 더 명확하게 드러낸다 - 튜플을 통째로 비교하는 대신,
.str과.maxCount를 각각 따로XCTAssertEqual로 비교한다. 튜플 자체는Equatable을 기본으로 만족하지 않기 때문에, 필드별로 나눠서 비교해야 한다 text,expectedValue를var로 선언해서, 매 케이스마다 새로운 상수를 또 선언하는 대신 값만 갱신하면서 재사용한다
이 테스트로 다섯 가지 예시(빈 문자열, 동점 없는 케이스, 동점 케이스 두 개, 좀 더 복잡한 케이스)를 전부 검증했고, 전부 통과했다.
Sparse Matrix 챌린지: Dictionary로 행렬 표현하기
이번엔 Dictionary 기반으로 sparse matrix(희소 행렬)를 표현하는 문제다. 먼저 행렬과 sparse matrix가 뭔지부터 이해할 필요가 있다.
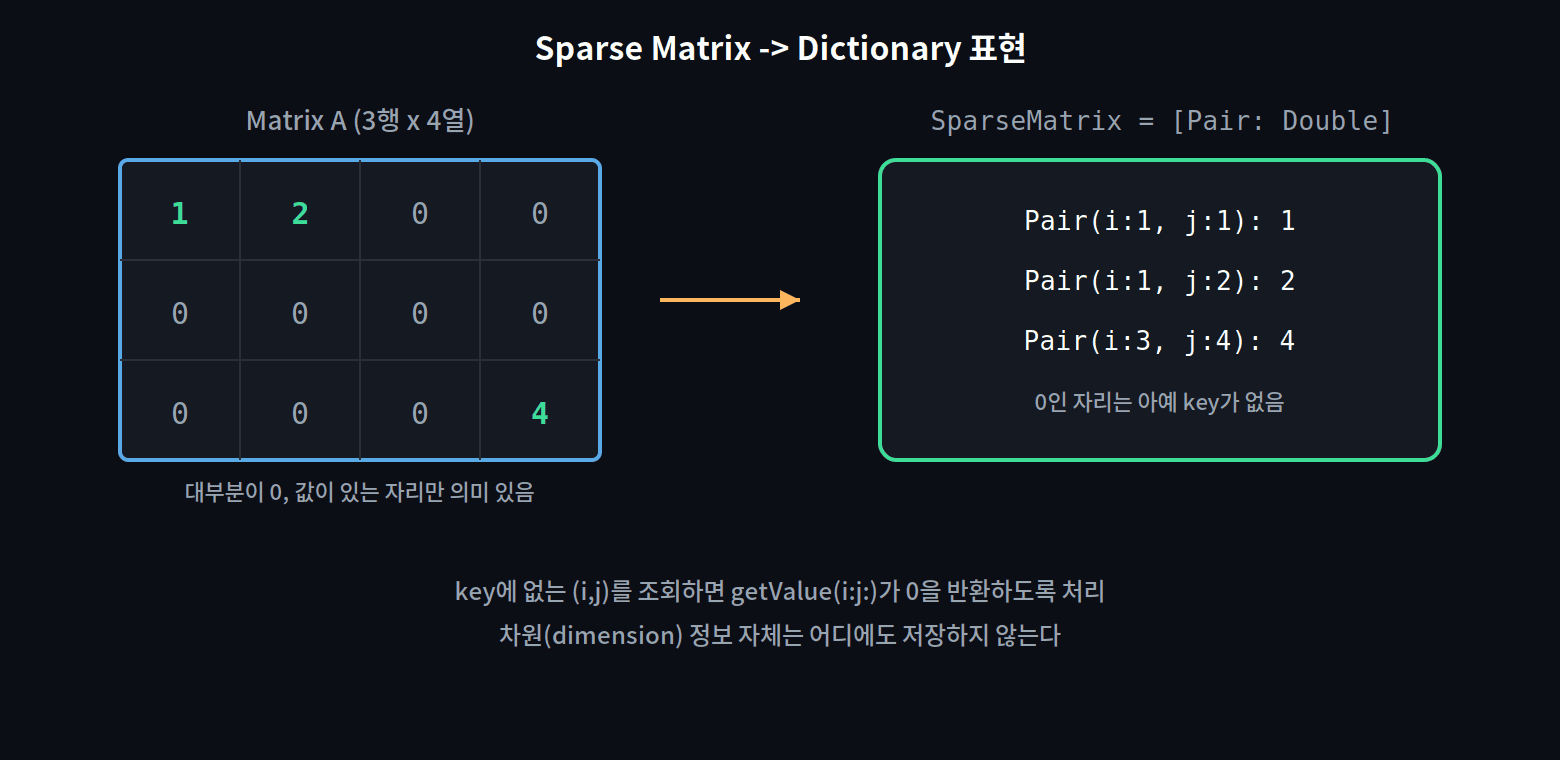
행렬은 숫자를 직사각형으로 배열한 것이다. 머신러닝, 컴퓨터 그래픽스, Google의 페이지랭크 알고리즘 등 다양한 분야에서 쓰이는 깊은 주제지만, 여기선 선형대수 자체를 다루진 않는다. A라는 행렬이 있을 때 Aij는 i번째 행(row), j번째 열(column)의 원소를 가리킨다.
sparse matrix는 대부분의 원소가 0인 행렬이다. 보통 1000×1000처럼 거대한 크기인데 실제 값이 있는 자리는 얼마 안 되는 경우를 말한다. 이런 행렬을 표현할 때, 값이 0인 자리까지 전부 저장하는 건 낭비다. 그래서 0이 아닌 원소만, (i, j) 위치를 key로 하는 Dictionary에 저장하는 방식을 쓴다.
Pair와 SparseMatrix 타입 정의하기
Dictionary의 key로 (Int, Int) 튜플을 바로 쓸 수도 있지만, 튜플은 기본적으로 Hashable을 만족하지 않아서 Dictionary key로 쓸 수 없다. 그래서 별도 struct를 만든다.
1
2
3
4
5
6
7
8
9
10
struct Pair: Hashable, CustomStringConvertible {
    let i: Int
    let j: Int

    var description: String {
        "(\(i), \(j))"
    }
}

typealias SparseMatrix = [Pair: Double]
Pair가 Hashable을 채택하면 Dictionary의 key로 쓸 수 있게 된다. CustomStringConvertible을 추가로 채택해서, print했을 때 "(1, 2)"처럼 보기 좋게 출력되도록 했다.
0이 아닌 자리를 조회할 땐 문제없지만, 0인 자리(Dictionary에 key가 아예 없는 자리)를 조회하면 값을 어떻게 가져올지도 정해야 한다. 이를 위해 SparseMatrix에 extension을 추가한다.
1
2
3
4
5
6
7
8
9
extension SparseMatrix {
    func getValue(i: Int, j: Int) -> Double {
        if let value = self[Pair(i: i, j: j)] {
            return value
        } else {
            return 0
        }
    }
}
key가 없으면(즉 그 자리는 0이므로 저장할 필요가 없었던 것이니) 0을 반환한다.
손으로 먼저 계산해보며 문제 이해하기
실제 구현에 들어가기 전에, 두 sparse matrix A, B의 차이를 손으로 계산해보면서 어떤 함정이 있을 수 있는지 미리 짚어봤다.
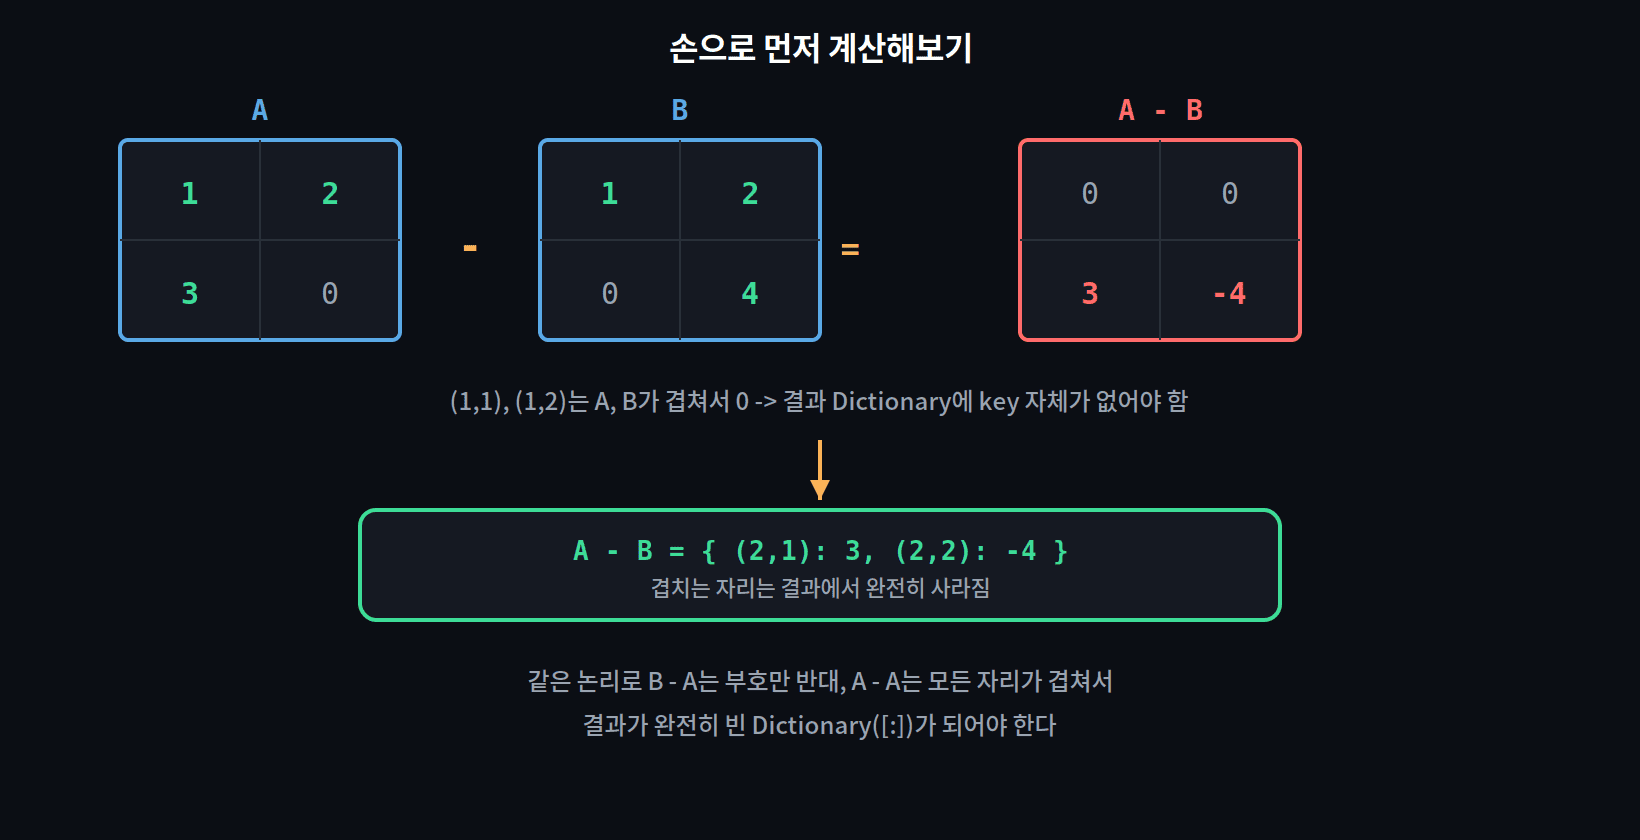
A - B와B - A는 부호만 반대인 관계다A - A는 모든 원소가0인 행렬이 되므로, 그 표현은 빈 Dictionary([:])여야 한다A와B가 같은 위치에 같은 값을 가진 원소가 있다면(예: 둘 다(1,1)에1), 그 자리는 빼면0이 되므로 결과 Dictionary에 아예 key로 남으면 안 된다
특히 세 번째 포인트가 나이브하게 구현하면 놓치기 쉬운 함정이다. “A와 B가 겹치는 자리가 있는” 케이스를 테스트에 반드시 포함시켜야, 결과에 불필요한 0 값이 남는 버그를 잡아낼 수 있다는 것.
differenceSparseMatrices 구현하기: Bp 트릭
A를 순회하면서 B의 값을 빼는 것까지는 자연스러운데, 문제는 A에는 없고 B에만 있는 자리를 어떻게 놓치지 않고 처리하느냐다. 여기서 쓴 방법이 B의 복사본(Bp)을 만들어서, A를 순회하는 동안 이미 처리한 자리를 Bp에서 지워나가는 트릭이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
static func differenceSparseMatrices(_ A: SparseMatrix, _ B: SparseMatrix) -> SparseMatrix {
    var M = SparseMatrix()
    var Bp = B   // B의 복사본

    for (pair1, value1) in A {
        Bp[pair1] = nil   // A에서 이미 다룬 자리는 Bp에서 제거

        let value2: Double = B[pair1, default: 0]
        let difference = value1 - value2
        if difference != 0 {
            M[pair1] = difference
        }
    }

    for (pair2, value2) in Bp {
        M[pair2] = -value2
    }

    return M
}
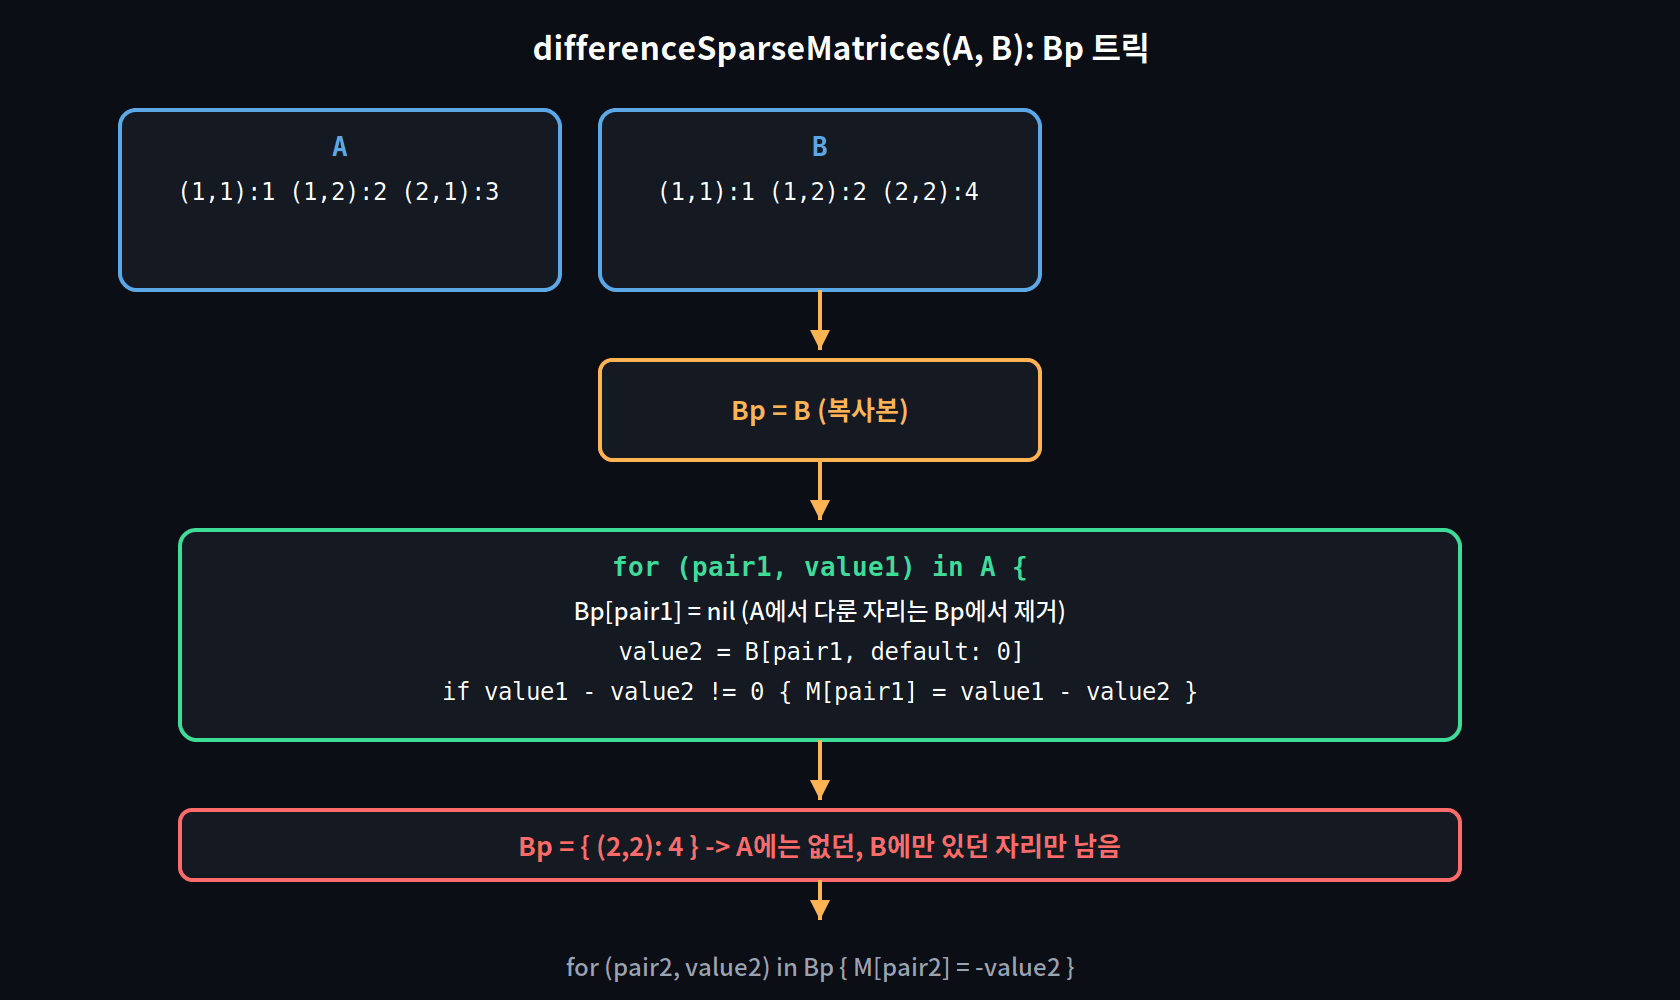
흐름을 정리하면 이렇다.
Bp는B를 통째로 복사한 것으로 시작한다A를 순회하면서, 각pair1에 대해Bp[pair1] = nil로 그 자리를Bp에서 지운다.A와B양쪽에 값이 있는 자리든,A에만 있고B에는 없는 자리든 상관없이,A를 순회하는 시점에 이미value1 - value2(B에 없으면default: 0으로0) 계산을 끝내기 때문에Bp에서 지워도 안전하다A를 다 순회하고 나면,Bp에는A에는 없고B에만 있던 자리만 남아있다- 이 남은
Bp를 순회하면서,0 - value2에 해당하는-value2를 결과M에 채워넣는다 difference != 0일 때만M에 저장하기 때문에,A와B가 겹치는 자리에서 값이 같으면(차이가0) 자동으로 결과에서 제외된다
이 마지막 조건(if difference != 0)을 빼고 테스트를 돌려보면 어디서 실패하는지 확인해봤는데, 정확히 A와 B가 같은 위치에 같은 값을 가진 케이스에서 실패가 났다. 미리 이 케이스를 테스트에 넣어뒀기 때문에 바로 잡아낼 수 있었던 것이고, 만약 그 테스트 케이스가 없었다면 이 버그를 놓쳤을 수 있다.
Unit Test로 검증하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
func testDifferenceSparseMatrixExample1() {
    let A: SparseMatrix = [
        Pair(i: 1, j: 1): 1,
        Pair(i: 1, j: 2): 2,
        Pair(i: 2, j: 1): 3,
    ]
    let B: SparseMatrix = [
        Pair(i: 1, j: 1): 1,
        Pair(i: 1, j: 2): 2,
        Pair(i: 2, j: 2): 4,
    ]

    let expectedAminusB: SparseMatrix = [
        Pair(i: 2, j: 1): 3,
        Pair(i: 2, j: 2): -4
    ]
    let expectedBminusA: SparseMatrix = [
        Pair(i: 2, j: 1): -3,
        Pair(i: 2, j: 2): 4
    ]
    let expectedAminusA: SparseMatrix = [:]

    XCTAssertEqual(Part4Problems.differenceSparseMatrices(A, B), expectedAminusB)
    XCTAssertEqual(Part4Problems.differenceSparseMatrices(B, A), expectedBminusA)
    XCTAssertEqual(Part4Problems.differenceSparseMatrices(A, A), expectedAminusA)
}
A와 B는 (1,1)과 (1,2)에서 값이 겹친다(둘 다 1, 2). 이 겹치는 자리가 결과에서 사라지는지, A - B와 B - A가 부호만 반대인지, A - A가 완전히 빈 Dictionary인지까지 한 번에 검증한다. SparseMatrix가 [Pair: Double]이라 Equatable을 자동으로 만족하므로, XCTAssertEqual로 Dictionary 전체를 그대로 비교할 수 있다.
세 assertion 모두 통과했다.
findSubstringLocations 챌린지: 부분 문자열의 등장 위치 모으기
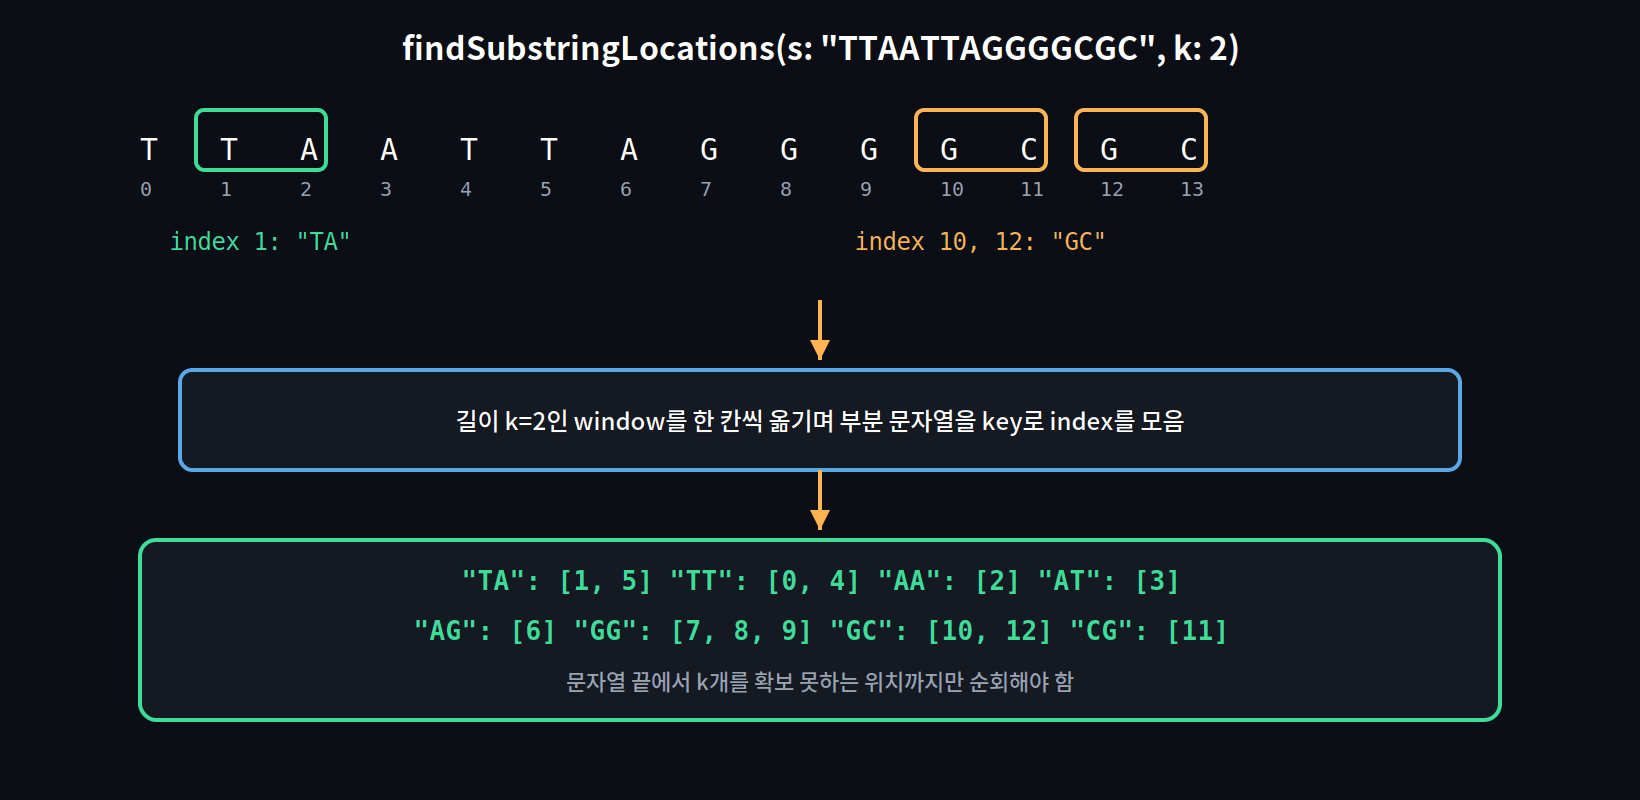
문자열 s와 정수 k가 주어졌을 때, s에 등장하는 길이 k짜리 모든 부분 문자열을 key로, 그 부분 문자열이 등장하는 위치(offset)들의 배열을 value로 갖는 Dictionary를 반환한다.
1
2
3
4
typealias Offsets = [Int]
// findSubstringLocations(s: "TTAATTAGGGGCGC", k: 2)
// -> ["TA": [1, 5], "GG": [7, 8, 9], "GC": [10, 12], "AT": [3],
//     "AG": [6], "TT": [0, 4], "AA": [2], "CG": [11]]
테스트부터 작성하기
구현에 들어가기 전에 unit test를 먼저 짰다. 함수가 아직 없으니 당연히 컴파일도 안 되는데, 이 시점에 오히려 함수 시그니처와 typealias Offsets = [Int]를 먼저 확정하게 된다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
func testFindSubstringLocations() {
    let s = "TTAATTAGGGGCGC"
    let k = 2

    let expectedValue = [
        "TA": [1, 5],
        "GG": [7, 8, 9],
        "GC": [10, 12],
        "AT": [3],
        "AG": [6],
        "TT": [0, 4],
        "AA": [2],
        "CG": [11]
    ]

    XCTAssertEqual(part4Problems.findSubstringLocations(s: s, k: k), expectedValue)
}
빈 문자열이거나 k가 s의 길이보다 큰 경우처럼 엣지 케이스도 나중에 추가로 검증해야 할 후보로 남겨뒀다. 일단 함수 본체는 빈 Dictionary를 반환하도록 임시로 채워서, 테스트가 실행되긴 하되 당연히 실패하는 상태로 만들어 시작했다.
첫 구현: 정수 인덱스로 순회하기
1
2
3
4
5
6
7
8
9
10
11
12
static func findSubstringLocations2(s: String, k: Int) -> [String: Offsets] {
    var result: [String: Offsets] = [:]

    for i in 0..<(s.count - k + 1) {
        let start = s.index(s.startIndex, offsetBy: i)
        let end = s.index(start, offsetBy: k)
        let subString: String = String(s[start..<end])
        result[subString, default: []].append(i)
    }

    return result
}
0..<s.count로 그냥 순회하면 문자열 끝부분에서 k개를 확보하지 못하는 시작 위치까지 포함되어 범위를 벗어나는 문제가 생긴다. s.count - k + 1로 순회 범위를 미리 제한해서, “그 위치에서 k개를 온전히 뽑을 수 있는 시작점”까지만 돈다. result[subString, default: []].append(i)로, 아직 없는 key라도 default: [](빈 배열)로 시작해서 바로 append할 수 있게 처리한다.
String.Index로 순회하는 버전, 그리고 반복되는 변환을 extension으로 뽑아내기
정수 인덱스 대신 String.Index(s.indices)로 직접 순회하는 버전도 시도했다.
1
2
3
4
5
6
7
8
9
10
11
12
13
static func findSubstringLocations(s: String, k: Int) -> [String: Offsets] {
    var result: [String: Offsets] = [:]

    for start in s.dropLast(k - 1).indices {
        let end = s.index(start, offsetBy: k)
        let subString: String = String(s[start..<end])
        let i = start.toInt(in: s)

        result[subString, default: []].append(i)
    }

    return result
}
s.dropLast(k - 1).indices로 순회 범위를 제한하는 방식이 s.count - k + 1을 직접 계산하는 것보다 off-by-one 실수의 여지가 적다. 다만 start가 String.Index이지 Int가 아니라서, Dictionary의 value(배열)에 넣으려면 다시 정수로 변환해야 한다.
이 변환(s.distance(from: s.startIndex, to: start))이 이전 문제들에서도 반복적으로 등장했던 패턴이라, 아예 String.Index의 extension으로 뽑아냈다.
1
2
3
4
5
extension String.Index {
    func toInt(in string: String) -> Int {
        string.distance(from: string.startIndex, to: self)
    }
}
이 extension을 별도 파일(Extensions.swift)에 정의해두면, start.toInt(in: s)처럼 훨씬 짧고 읽기 좋은 형태로 이 변환을 어디서든 재사용할 수 있다.
Swifty 버전: reduce(into:)
1
2
3
4
5
6
7
8
9
static func findSubstringLocationsSwifty(s: String, k: Int) -> [String: Offsets] {
    s.indices
        .dropLast(k - 1)
        .reduce(into: [:]) { result, index in
            let subString = String(s[index..<s.index(index, offsetBy: k)])
            result[subString, default: []]
                .append(index.toInt(in: s))
        }
}
s.indices.dropLast(k - 1)로 유효한 시작 인덱스만 남기고, reduce(into:)로 빈 Dictionary([:])에서 시작해서 각 인덱스를 처리하며 결과를 누적한다. 명령형 버전과 로직은 동일하지만, var result를 직접 선언하고 return하는 대신 reduce가 그 누적과 반환을 대신 처리해준다.
일부러 읽기 힘들게 만든 버전: 짧다고 좋은 게 아니다
1
2
3
4
5
6
7
8
static func findSubstringLocationsSwiftyUnreadable(s: String, k: Int) -> [String: Offsets] {
    s.indices
        .dropLast(k - 1)
        .reduce(into: [:]) {
            $0[String(s[$1..<s.index($1, offsetBy: k)]), default: []]
                .append($1.toInt(in: s))
        }
}
바로 위 버전과 기능적으로는 완전히 동일하다. 다만 클로저 파라미터 이름(result, index)을 $0, $1로 바꾸고, 중간 변수(subString)도 없애서 한 줄에 다 욱여넣었다. 이렇게 짧게 압축하는 게 기술적으로는 “더 우아해 보일” 수 있지만, 실제로 이 버전에 대해 “마음에 안 든다”는 평가가 직접 나왔다. 코드에서 정말 중요한 건 버그가 없어야 한다는 것과, 자신이든 다른 사람이든(몇 달 뒤의 자신을 포함해서) 그 코드를 읽고 이해할 수 있어야 한다는 것이기 때문이다. 짧은 코드가 항상 더 나은 코드는 아니라는 걸 의도적으로 보여준 사례다.
세 가지 버전(findSubstringLocations, findSubstringLocationsSwifty, findSubstringLocationsSwiftyUnreadable) 전부 같은 테스트를 통과시켜서, 스타일은 다르지만 동작은 동일함을 확인했다.
Part 4 Dictionaries UI: 기록할 만한 패턴만
MostPopularCharacterView, SubstringLocationsView, SparseMatrixDifferenceView를 만드는 과정은 대부분 지금까지 본 패턴(텍스트 필드 + 결과 표시, List로 Dictionary 항목 나열)의 반복이라 대부분 생략하고, 새롭게 기록해둘 만한 패턴 두 가지만 남긴다.
중첩 ForEach로 2차원 그리드 렌더링하기
지금까지는 전부 1차원 리스트를 보여주는 화면이었는데, sparse matrix는 2차원 그리드로 보여줘야 한다. ForEach를 중첩해서 이 문제를 푼다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
struct DisplaySparseMatrix: View {
    let A: SparseMatrix
    let m: Int
    let n: Int
    let color: Color

    var body: some View {
        VStack {
            ForEach(0..<m, id: \.self) { i in
                HStack {
                    ForEach(0..<n, id: \.self) { j in
                        let text = "\(Int(A.getValue(i: i, j: j)))"

                        Text(text)
                            .frame(maxWidth: .infinity)
                            .padding()
                            .background(color.opacity(0.7).clipShape(RoundedRectangle(cornerRadius: 5)))
                    }
                }
            }
        }
    }
}
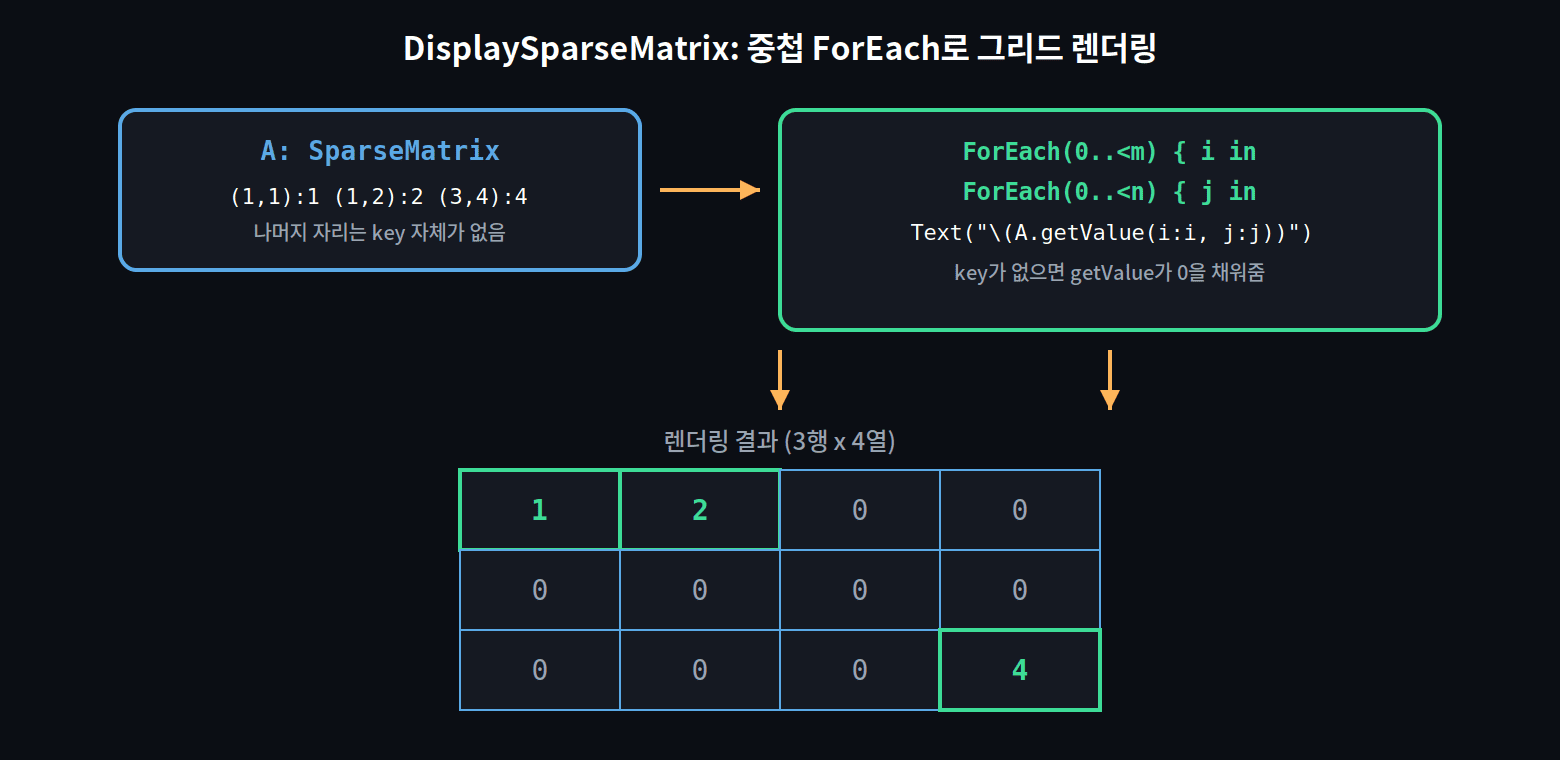
바깥쪽 VStack + ForEach(0..<m)가 행(row)을 만들고, 그 안의 HStack + ForEach(0..<n)이 각 행의 열(column)을 채운다. SparseMatrix가 대부분 값을 안 갖고 있는 Dictionary라는 점은, 앞서 만들어둔 A.getValue(i:j:) extension이 key가 없는 자리를 자동으로 0으로 채워주기 때문에 화면을 그리는 코드에서는 전혀 신경 쓸 필요가 없다. 데이터 구조가 “값이 없는 자리를 어떻게 다룰지”를 이미 책임지고 있어서, View는 그냥 getValue만 호출하면 되는 구조다.
2차원 인덱스로 Dictionary에 쓸 때 범위를 먼저 확인하기
SparseMatrixView는 사용자가 행(ai), 열(aj), 값(value)을 입력해서 행렬의 특정 자리를 직접 편집할 수 있게 해준다.
1
2
3
4
5
6
NiceTextField(value: $value, color: valueColor, text: "Value")
    .onChange(of: value) {
        if ai >= 1 && ai <= m && aj >= 1 && aj <= n {
            A[Pair(i: ai - 1, j: aj - 1)] = Double(value)
        }
    }
값이 바뀔 때마다, ai와 aj가 실제 행렬 범위(1...m, 1...n) 안에 있는지 먼저 확인한 다음에만 A(Dictionary)에 값을 써넣는다. 사용자가 행렬 크기를 벗어나는 행/열 번호를 입력해도, 그 값이 조용히 무시될 뿐 잘못된 위치에 데이터가 저장되거나 crash가 나지 않는다. 사용자 입력을 데이터 구조에 반영하기 전에 그 범위부터 검증한다는 원칙이, 여기서는 1차원 배열이 아니라 2차원 좌표(Pair) 형태로 적용된 사례다.