Swift Algorithms (4) - Loops and lsts
Part 2: firstDivisible 챌린지
part2Problems라는 새 struct에 함수들을 모은다.
문제: 양의 정수로 이루어진 배열 lst와 양의 정수 a가 주어졌을 때, lst에서 a로 나누어떨어지는 첫 번째 원소의 인덱스를 반환한다. 그런 원소가 없으면 nil을 반환한다. a는 항상 양수지만, lst는 빈 배열일 수도 있다.
첫 번째 함정: element를 반환하면 안 된다
1
2
3
4
5
6
7
8
static func firstDivisible(lst: [Int], a: Int) -> Int? {
    for element in lst {
        if element % a == 0 {
            return element  // 틀렸다
        }
    }
    return nil
}
문제를 처음 보면 이렇게 짜기 쉽다. 하지만 문제가 원하는 건 나누어떨어지는 값 자체가 아니라 그 값의 인덱스다. lst가 [5, 7, 12]이고 a가 3이면, 12가 3으로 나누어떨어지는 첫 번째 원소인데, 위 코드는 12(값)를 반환하지만 정답은 2(인덱스)여야 한다.
enumerated()로 인덱스와 값을 함께 순회하기
1
2
3
4
5
6
7
8
static func firstDivisible(lst: [Int], a: Int) -> Int? {
    for (i, element) in lst.enumerated() {
        if element % a == 0 {
            return i
        }
    }
    return nil
}
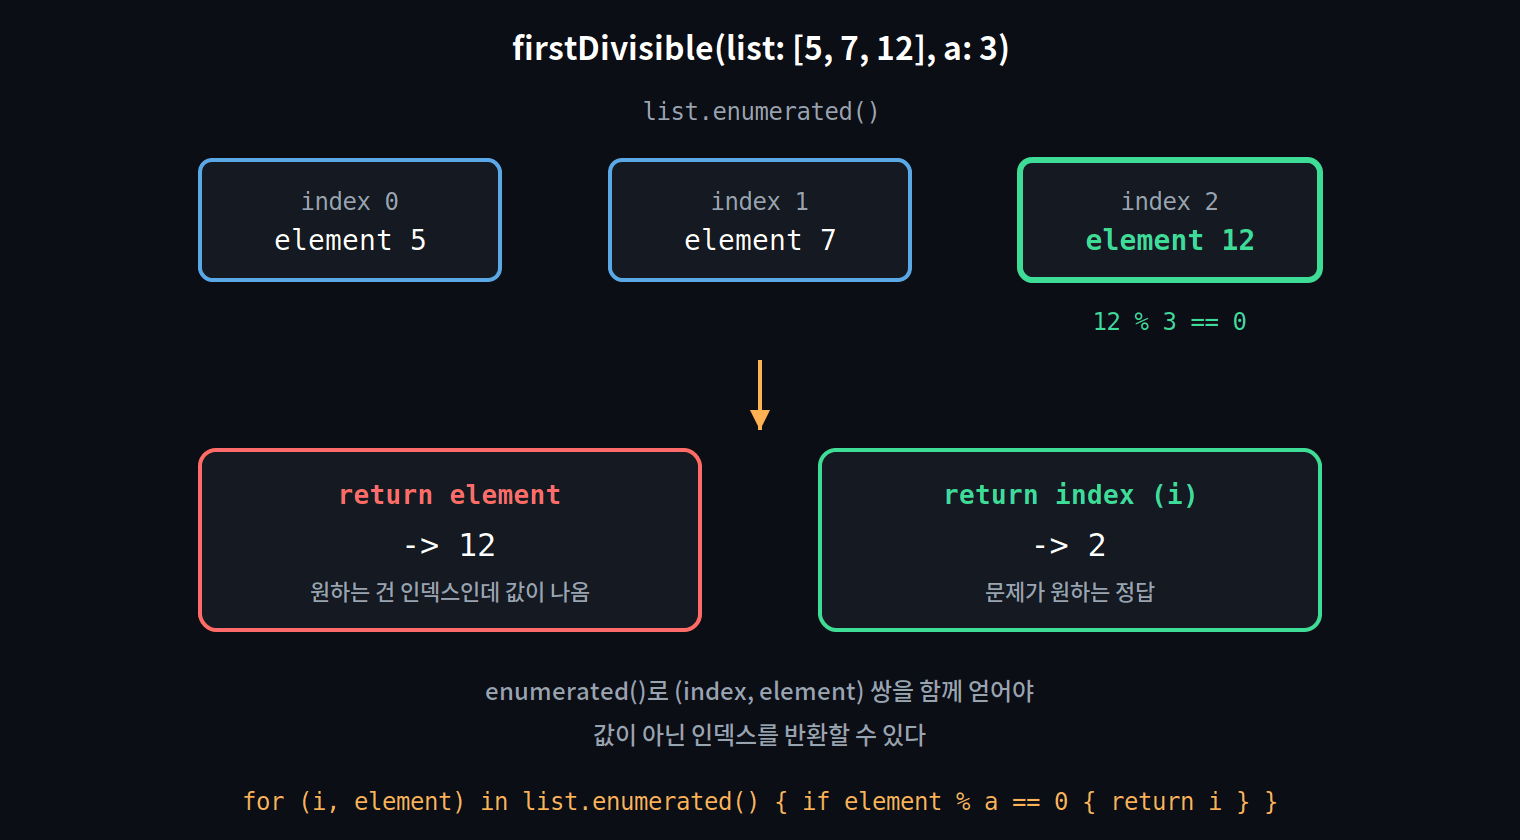
lst.enumerated()는 (index, element) 쌍을 순서대로 만들어준다. for (i, element) in lst.enumerated()로 이 쌍을 동시에 받으면, 조건을 만족했을 때 element 대신 i를 반환할 수 있다.
대안 구현: 인덱스 범위로 직접 순회하기
1
2
3
4
5
6
7
8
9
static func firstDivisible2(lst: [Int], a: Int) -> Int? {
    for i in 0..<lst.count {
        let element = lst[i]
        if element % a == 0 {
            return i
        }
    }
    return nil
}
0..<lst.count 범위로 인덱스를 직접 순회하면서, lst[i]로 그때그때 값을 꺼내는 방식이다. element라는 중간 변수 없이 lst[i] % a == 0으로 바로 조건을 검사해도 되지만, 가독성을 위해 element로 한 번 받아뒀다.
두 구현 모두 결과는 동일하다. enumerated() 버전이 조금 더 Swift다운(idiomatic) 스타일로 여겨지지만, 인덱스 범위로 직접 순회하는 두 번째 방식도 명확하고 이해하기 쉽다는 점에서 우열을 가리기 어렵다고 언급했다. 어느 쪽을 선호하든 상관없다는 것.
UI에서 기록할 만한 패턴
FirstDivisibleView를 만드는 과정은 대부분 슬라이더/버튼 배치 같은 반복적인 레이아웃 작업이라 대부분 생략하고, 재사용할 만한 패턴 하나만 남긴다.
“현재 순회 중인 항목이 정답 인덱스와 일치하는지”로 스타일을 조건부 적용하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
Section("lst of Ingegers") {
    ForEach(lst.indices, id: \.self) { i in
        let isSelected = firstDivisibleIndex == i
        let color: Color = isSelected ? .red : .black

        HStack {
            TextField("", value: $lst[i], format: .number)
                .foregroundStyle(color)
                .fontWeight(isSelected ? .bold : .regular)
                .textFieldStyle(RoundedBorderTextFieldStyle())
                .keyboardType(.numbersAndPunctuation)

            Spacer()
            Text("😎")
                .opacity(isSelected ? 1 : 0)
        }


    }
}
firstDivisibleIndex(계산된 정답 인덱스)와 현재 순회 중인 i를 비교해서 isSelected를 만들고, 이 값 하나로 색상·굵기·이모지 표시 여부까지 한꺼번에 결정한다. “리스트를 순회하면서 특정 조건(여기서는 ‘정답 인덱스와 일치’)을 만족하는 항목만 강조 표시”하는 상황에서 재사용할 만한 구조다.
리스트 값 자체도 Text 대신 TextField("", value:format:)로 편집 가능하게 만들었는데, 이렇게 value와 format을 쓰는 이니셜라이저는 문자열이 아니라 숫자(Int, Double 등) 바인딩을 직접 받아서, TextField(text:) + 수동 타입 변환 없이도 숫자 입력 필드를 만들 수 있게 해준다.
firstDivisible을 제네릭으로 만들기
firstDivisible을 Int 전용에서, Int32나 Int64 같은 다른 정수 타입도 받을 수 있는 제네릭 함수로 바꾼다. String이나 Double은 여기 해당하지 않는다. Double에는 “나누어떨어진다”는 개념 자체가 성립하지 않기 때문이다. 그래서 아무 타입이나 받는 순수 제네릭 T가 아니라, 정수 계열 타입을 나타내는 BinaryInteger 프로토콜로 제약을 건 T를 쓴다.
나이브하게 접근하면 실패하는 이유
Int를 전부 T로 바꾸면 될 것 같지만, 실제로 해보면 두 가지 문제에 부딪힌다.
1
2
3
4
5
6
7
8
static func firstDivisibleGeneric<T>(lst: [T], a: T) -> T? {
    for (i, element) in lst.enumerated() {
        if element % a == 0 {
            return i
        }
    }
    return nil
}
- 반환 타입을
T?로 그대로 바꿔버리면 안 된다.i(인덱스)는 실제로Int인데, 함수가T?를 반환하기로 되어있으니 타입이 맞지 않는다 element % a에서 컴파일 에러가 난다.T에 아무 제약이 없어서 “binary operator ‘%’ cannot be applied to two ‘T’ operands”라는 에러가 뜬다.%연산 자체가 모든 타입에 정의되어 있는 게 아니기 때문이다
올바른 구현: 일반화할 부분과 유지할 부분을 구분하기
1
2
3
4
5
6
7
8
static func firstDivisibleGeneric<T: BinaryInteger>(lst: [T], a: T) -> Int? {
    for (i, element) in lst.enumerated() {
        if element % a == 0 {
            return i
        }
    }
    return nil
}
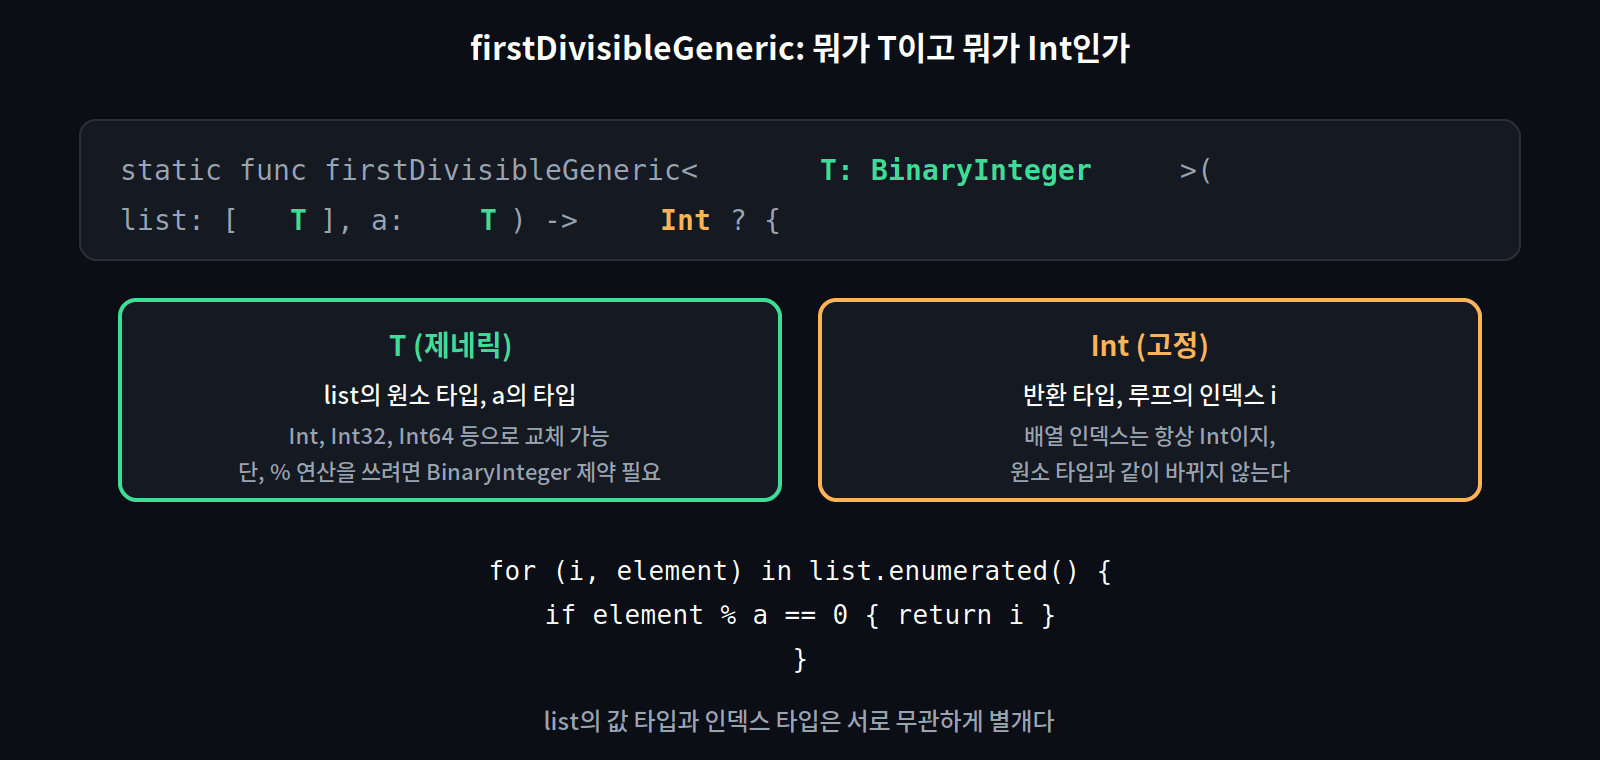
핵심은 무엇이 T로 바뀌어야 하고, 무엇이 Int로 그대로 남아야 하는지 구분하는 것이다.
T로 바뀌는 것:lst의 원소 타입,a의 타입. 이 값들이 실제로Int,Int32,Int64등 다양한 정수 타입일 수 있다는 게 이 함수를 제네릭으로 만드는 목적이다Int로 남는 것: 반환 타입과 루프 안의 인덱스i. 배열의 인덱스는 원소 타입이 뭐든 상관없이 항상Int다.String배열이든Int32배열이든, 그 배열의 인덱스는 여전히Int인 것과 같은 이치다
리스트의 값과 그 값의 인덱스는 서로 다른 종류의 정보이기 때문에, 하나를 제네릭으로 바꾼다고 다른 하나까지 같이 바꿀 필요는 없다는 것. 이 구분을 놓치면 “일단 눈에 보이는 Int를 전부 T로 바꾸는” 실수를 하기 쉽다.
이제 실무에서 Int32나 Int64 같은 다른 정수 타입을 굳이 쓸 일이 흔하지는 않지만, 메모리를 아끼기 위해 정밀도가 낮은 정수 타입을 선택해야 하는 상황이라면 이 제네릭 버전이 그대로 활용될 수 있다.
numberOfStringsAboveAverage 챌린지
새로운 문제다. 문자열로 이루어진 lst가 주어졌을 때, 평균 길이보다 엄격하게 더 긴 문자열의 개수와, 그 평균 길이 자체를 함께 반환한다. print 대신 값을 반환하는 형태로, (Int, Double) 쌍을 돌려주기로 했다. 이 문제는 for 루프와 while 루프 두 가지 방식으로 각각 구현해본다.
예시로 감 잡기
["hummus", "apple", "banana"]로 생각해보면 이렇다.
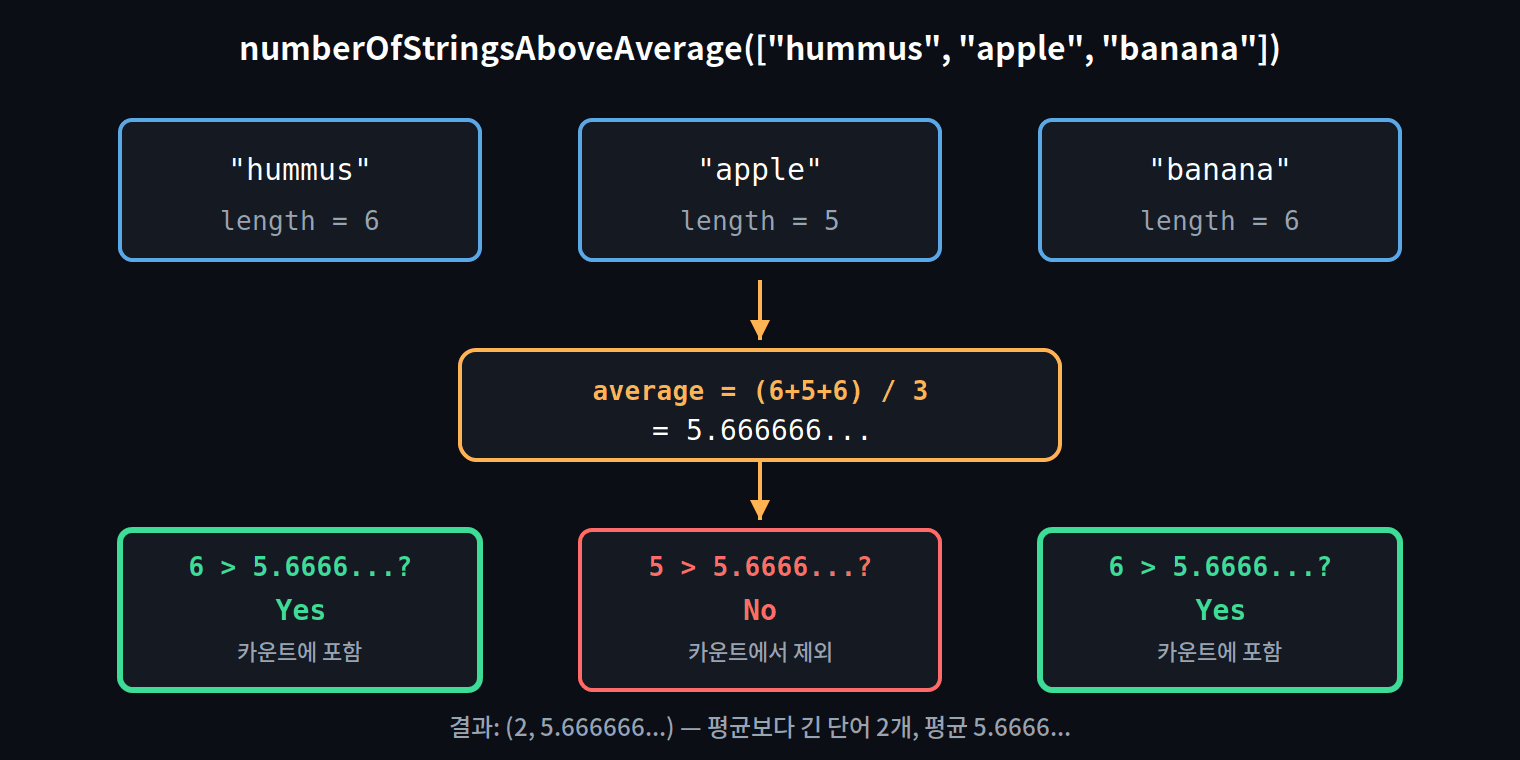
각 단어 길이는 6, 5, 6이고 평균은 5.666...이다. hummus(6)와 banana(6)는 평균보다 엄격하게 크지만, apple(5)은 평균보다 작다. 그래서 결과는 (2, 5.666...)이다.
만약 세 단어가 전부 길이 6으로 같다면(["hummus", "hummus", "banana"] 같은 식으로 길이가 모두 6이라면), 평균도 6이 되고 “평균보다 엄격하게 큰” 단어는 하나도 없으니 개수는 0이 된다.
엣지 케이스: 빈 리스트일 때
lst가 빈 배열이면 평균 자체가 정의되지 않는다. 이때 선택지가 두 가지 있었다.
- 평균을
0으로, 개수도0으로 처리한다 - 평균을
nil로 처리한다
lst가 비어있지 않다고 가정해버리는 방법도 있었지만, 그러지 않기로 했다. 대신 결과 타입에서 평균 부분만 optional로 만들기로 했다. 빈 리스트라도 “평균보다 큰 원소의 개수는 0개”라고 말하는 건 여전히 의미가 있다고 판단했기 때문이다. 그래서 최종적으로 반환 타입은 (Int, Double?)가 되고, 빈 리스트일 때는 (0, nil)을 반환한다.
for 루프로 구현하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
static func numberOfStringsAboveAverageFor(lst: [String]) -> (num: Int, average: Double?) {

    // Is lst empty?
    if lst.isEmpty {
        return (0, nil)
    }

    // Find average
    var sum: Int = 0
    for str in lst {
        sum += str.count
    }
    let average: Double = Double(sum) / Double(lst.count)

    // Find numberOfStringsAboveAverage
    var numberOfStringAboveAverage = 0
    for str in lst {
        if Double(str.count) > average {
            numberOfStringAboveAverage += 1
        }
    }

    return (numberOfStringAboveAverage, average)
}
먼저 빈 리스트인지 확인해서 조기 반환하고, 그다음 전체 문자열 길이의 합(sum)을 구해서 평균을 계산한다. sum은 Int, lst.count도 Int인데 평균은 Double이어야 하니, 나눗셈 전에 Double(...)로 타입 변환을 해준다. 이후 각 문자열의 길이가 평균보다 큰지 다시 한 번 순회하며 세는데, 이때도 string.count(Int)와 average(Double)를 직접 비교할 수 없어서 Double(string.count)로 변환해야 한다.
while 루프로 다시 구현하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
static func numberOfStringsAboveAverageWhile(lst: [String]) -> (Int, Double?) {

    // Is lst empty?
    if lst.isEmpty {
        return (0, nil)
    }

    // Find average
    var sum = 0
    var index = 0
    while index < lst.count {
        let str = lst[index]
        sum += str.count

        index += 1
    }
    let average = Double(sum) / Double(lst.count)

    // Find numberOfStringsAboveAverage
    var numberOfStringsAboveAverage = 0
    index = 0
    while index < lst.count {
        let str = lst[index]
        if Double(str.count) > average {
            numberOfStringsAboveAverage += 1
        }

        index += 1
    }

    return (numberOfStringsAboveAverage, average)
}
for string in lst 대신 index를 직접 관리하면서 lst[index]로 값을 꺼내는 방식이다. for 버전보다 확실히 코드가 길어지고 손이 더 간다.
두 번째 while 루프를 작성하면서 흔한 실수 하나를 직접 겪었다. index를 0으로 초기화하고 루프를 돌렸는데, index += 1을 빼먹었다. 이러면 index가 영원히 0에 머물러서 무한 루프에 빠진다. while 루프를 쓸 때는 다음 세 가지를 항상 챙겨야 한다는 걸 재확인했다.
- 루프에 들어가기 전에 상태(여기선
index)를 초기화한다 - 루프 조건이 언젠가는 반드시
false가 될 수 있어야 한다 - 그 조건을
false로 만드는 변화(여기선index += 1)를 루프 안에서 빠짐없이 적용한다
이 세 가지 중 하나라도 빠지면 무한 루프나 잘못된 결과로 이어진다. for 루프는 이 관리를 언어가 대신 해주기 때문에 실수할 여지가 훨씬 적다.
UI에서 기록할 만한 패턴
NumberOfStringsAboveAverageView를 만드는 과정 대부분은 반복적인 레이아웃 작업이라 생략하고, 재사용할 만한 패턴 하나만 남긴다.
리스트 편집 UI를 제네릭 컴포넌트로 뽑아내기
이전에 FirstDivisibleView에서 만들었던 “+/− 버튼으로 항목을 추가/삭제하는” UI를, 특정 타입(Int)에 묶이지 않는 제네릭 컴포넌트로 분리했다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
struct RandomlyUpdatelstView<Element>: View {
    @Binding var lst: [Element]
    let collection: [Element]
    let someElement: Element

    var body: some View {
        HStack {
            Button("−") {
                if !lst.isEmpty {
                    lst.removeLast()
                }
            }
            Button("+") {
                lst.append(collection.randomElement() ?? someElement)
            }
        }
    }
}
핵심은 세 가지다.
Element라는 제네릭 타입 파라미터를 두어서,Int리스트든String리스트든 상관없이 같은 컴포넌트를 재사용할 수 있게 했다collection.randomElement()는 컬렉션이 비어있을 수 있어서Element?를 반환한다. 강제 언래핑 대신, 혹시 모를 빈 컬렉션 상황을 대비해someElement라는 “그냥 존재만 하면 되는” 기본값을 파라미터로 받아서?? someElement로 nil-coalescing 처리했다. 실제로 이 기본값이 쓰일 일은 거의 없지만, 강제 언래핑을 쓰지 않겠다는 원칙을 지키기 위한 절충안이다- 호출하는 쪽에서
RandomCollections.sampleFruits같은 실제 데이터를collection으로 넘기면, 같은 컴포넌트가 과일 리스트든 동물 리스트든 그대로 동작한다
이렇게 만들어두면 나중에 다른 문제(예: 문자열 리스트를 다루는 화면)에서도 이 컴포넌트를 그대로 가져다 쓸 수 있다. 앞서 NavLink/ViewWithHelp를 재사용 가능한 컴포넌트로 뽑아냈던 것과 같은 맥락인데, 이번엔 특정 타입에 종속되지 않도록 제네릭까지 적용했다는 점이 다르다.
sumOfProducts 챌린지
새로운 문제다. 정수로 이루어진 lst가 주어졌을 때, 연속된 두 숫자씩 짝지어 곱한 값들의 합을 구한다. [1, 3, 2]라면 1×3 + 3×2 = 9를 반환한다. 리스트가 비어있으면 0, 원소가 하나뿐이면 그 값 자체를 반환한다. 추가로, 실제로 어떤 계산이 이뤄졌는지를 문자열로도 함께 반환해야 한다("1⋅3 + 3⋅2"처럼). 음수가 섞여 있으면 [1, -3, 2] → "1⋅(-3) + (-3)⋅2 = -9"처럼 음수를 괄호로 감싸서 표현해야 한다.
시그니처와 기본 골격
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
static func sumOfProducts(lst: [Int]) -> (result: Int, stringRepresentation: String) {
    let len = lst.count
    var result = 0
    var stringRep = ""
    let plusSign = " + "
    let times = "⋅"

    if len == 1 {
        result = lst[0]
        stringRep = String(result)
    } else if len > 1 {

    }

    return (result, stringRep)
}
result와 stringRep을 처음부터 0과 ""로 선언해두면, 빈 리스트(len == 0) 케이스는 별도로 처리할 필요가 없다. 이미 초기값 자체가 정답이기 때문이다. len == 1이면 그 하나의 원소가 곧 결과이자 문자열 표현이 된다. lst.first(optional)로 안전하게 꺼내는 방법도 있었지만, 이미 len == 1임을 알고 있는 상태라 lst[0]으로 바로 접근해도 안전하다고 판단해서 그쪽을 택했다.
겪었던 버그: 범위를 벗어난 인덱스
처음엔 이렇게 짰다.
1
2
3
for i in 0..<len {
    result += lst[i] * lst[i+1]  // 크래시
}
i가 len - 1에 도달하는 순간, lst[i+1]은 lst[len]이 되어버린다. 배열의 유효한 인덱스는 0부터 len - 1까지인데, len 자체는 범위를 벗어난 값이라 여기서 크래시가 난다. i는 len - 1까지만 순회해야 한다는 걸 실제로 겪고 나서야 확실히 알게 됐다.
1
2
3
for i in 0..<len-1 {
    result += lst[i] * lst[i+1]
}
문자열 표현 만들기: trailing plus sign 제거하기
각 쌍을 곱할 때마다 "lst[i]⋅lst[i+1] + " 형태로 이어붙이면, 마지막 쌍을 처리한 뒤에도 " + "가 끝에 그대로 남는다.
1
2
3
4
5
6
7
8
for i in 0..<len-1 {
    result += lst[i] * lst[i+1]
    let str1 = lst[i] < 0 ? "(\(lst[i]))" : "\(lst[i])"
    let str2 = lst[i+1] < 0 ? "(\(lst[i+1]))" : "\(lst[i+1])"

    stringRep += "\(str1)\(times)\(str2)\(plusSign)"
}
stringRep = String(stringRep.dropLast(plusSign.count))
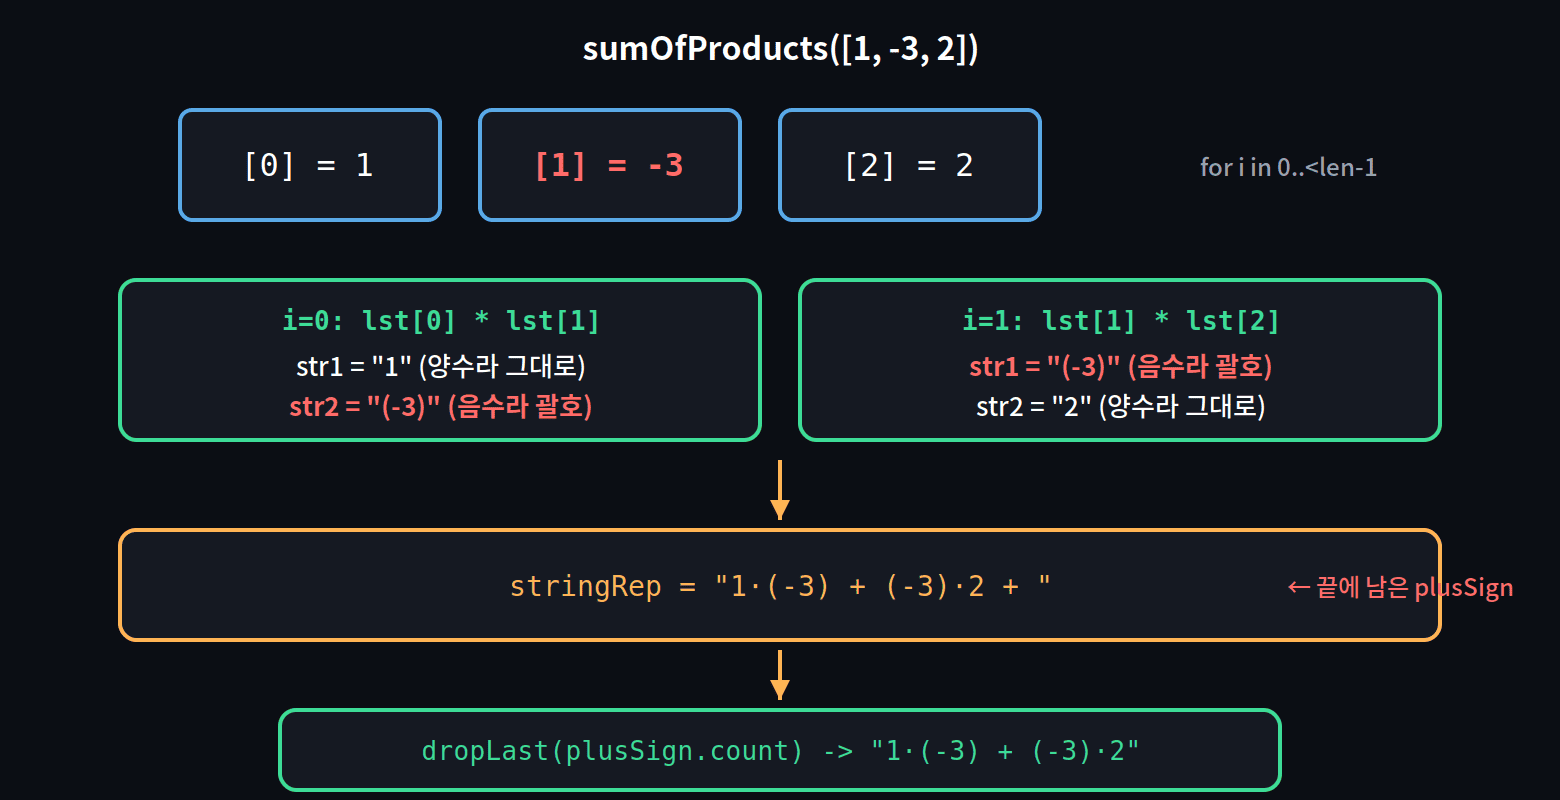
dropLast(_:)에 넘기는 값을 처음엔 1이나 3처럼 숫자를 직접 하드코딩하려고 했는데, 그러면 나중에 plusSign을 " + "에서 "," 같은 다른 구분자로 바꿀 때마다 이 숫자도 같이 손봐야 하는 문제가 생긴다. 그래서 plusSign.count로 동적으로 계산해서, plusSign이 몇 글자든 항상 정확히 그만큼만 잘라내도록 했다. dropLast는 Substring을 반환하므로, 다시 String(...)으로 감싸서 타입을 맞춘다.
최종 코드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
static func sumOfProducts( lst: [Int]) -> ( result: Int, stringRepresentation: String) {
    let len = lst.count
    var result = 0
    var stringRep = ""
    let plusSign = " + "
    let times = "⋅"

    if len == 1 {
        result = lst[0]
        stringRep = String(result)
    } else if len > 1 {
        for i in 0..<len-1 {
            result += lst[i] * lst[i+1]
            let str1 = lst[i] < 0 ? "(\(lst[i]))" : "\(lst[i])"
            let str2 = lst[i+1] < 0 ? "(\(lst[i+1]))" : "\(lst[i+1])"

            stringRep += "\(str1)\(times)\(str2)\(plusSign)"
        }
        stringRep = String(stringRep.dropLast(plusSign.count))
    }

    return (result, stringRep)
}
음수 처리: 괄호로 감싸기
str1, str2를 만들 때 삼항 연산자로 음수 여부를 확인해서, 음수면 괄호로 감싸고 아니면 그대로 문자열 보간한다.
1
2
let str1 = lst[i] < 0 ? "(\(lst[i]))" : "\(lst[i])"
let str2 = lst[i+1] < 0 ? "(\(lst[i+1]))" : "\(lst[i+1])"
이렇게 만든 str1, str2를 곱셈 기호(times, 유니코드 ⋅ 문자)로 이어붙이면 [1, -3, 2]에 대해 "1⋅(-3) + (-3)⋅2"가 만들어진다.
UI에서 기록할 만한 것
SumOfProductsView를 만드는 과정은 대부분 이전에 만든 RandomlyUpdateListView(제네릭 +/− 버튼 컴포넌트)를 그대로 재사용하는 작업이라 대부분 생략한다. 다만 한 가지는 짚어둘 만하다.
제네릭 컴포넌트가 실제로 다른 문제에서도 그대로 재사용됨
1
2
3
4
RandomlyUpdateListView(
    lst: $lst.animation(),
    collection: Array(1...max),
    someElement: 1)
FirstDivisibleView에서 만들었던 RandomlyUpdateListView<Element>를 이번엔 Int 리스트에 그대로 가져다 썼다. collection으로 Array(1...max)(1부터 100까지의 정수 배열)를 넘기기만 하면, 별도 수정 없이 “값 추가/삭제” UI가 그대로 동작한다. 제네릭으로 미리 뽑아둔 컴포넌트가 실제로 다른 화면에서 재사용되는 걸 확인한 사례다.
growingDifferences 챌린지
양의 정수로 이루어진 lst(원소가 최소 2개)가 주어졌을 때, lst의 순서를 유지하면서 일부 원소를 건너뛴 새 리스트를 반환한다. 이 새 리스트는 연속된 두 원소 사이의 절대 차이(absolute difference)가, 그 직전 연속 쌍의 절대 차이보다 엄격하게 더 커야 한다는 조건을 만족해야 한다.
문제 자체를 이해하는 게 생각보다 까다롭다. [7, 3, 6, 4]로 예를 들면, 7과 3의 절대 차이는 4, 3과 6의 절대 차이는 3이다. 3이 4보다 크지 않으니 6은 새 리스트에서 제외된다. 이런 식으로 “직전에 확정된 차이”보다 커지는 원소만 골라 담는 것.
문제를 다시 풀어보기
핵심을 정리하면 이렇다.
- 새 리스트(
newList)는 항상lst의 첫 두 원소로 시작한다 lst를 순서대로 순회하면서, 각 원소를 “새 리스트의 마지막 원소와의 차이”가 “새 리스트 안에서 직전에 확정된 차이”보다 큰지 확인한다- 조건을 만족하면 새 리스트에 추가하고, 아니면 건너뛴다
초기 리스트 만들기
1
2
3
4
5
6
7
static func growingDifferences(lst: [Int]) -> [Int] {
    if lst.count < 2 {
        return []
    }
    var newList: [Int] = Array(lst[0..<2])
    // ...
}
lst.count < 2면 문제 조건 자체가 성립하지 않으니 빈 배열을 반환한다. lst[0..<2]로 처음 두 원소를 슬라이싱하면 ArraySlice<Int> 타입이 나오는데, 이건 Array<Int>(=[Int])와 다른 타입이라 Array(...)로 감싸서 명시적으로 변환해야 한다.
previousDelta와 newDelta 구하기
1
2
3
4
5
6
7
8
9
10
11
for listItem in lst {
    let last: Int = newList.last ?? 0
    let nextToLast: Int = newList.dropLast().last ?? 0

    let previousDelta = abs(last - nextToLast)
    let newDelta = abs(last - listItem)

    if newDelta > previousDelta {
        newList.append(listItem)
    }
}
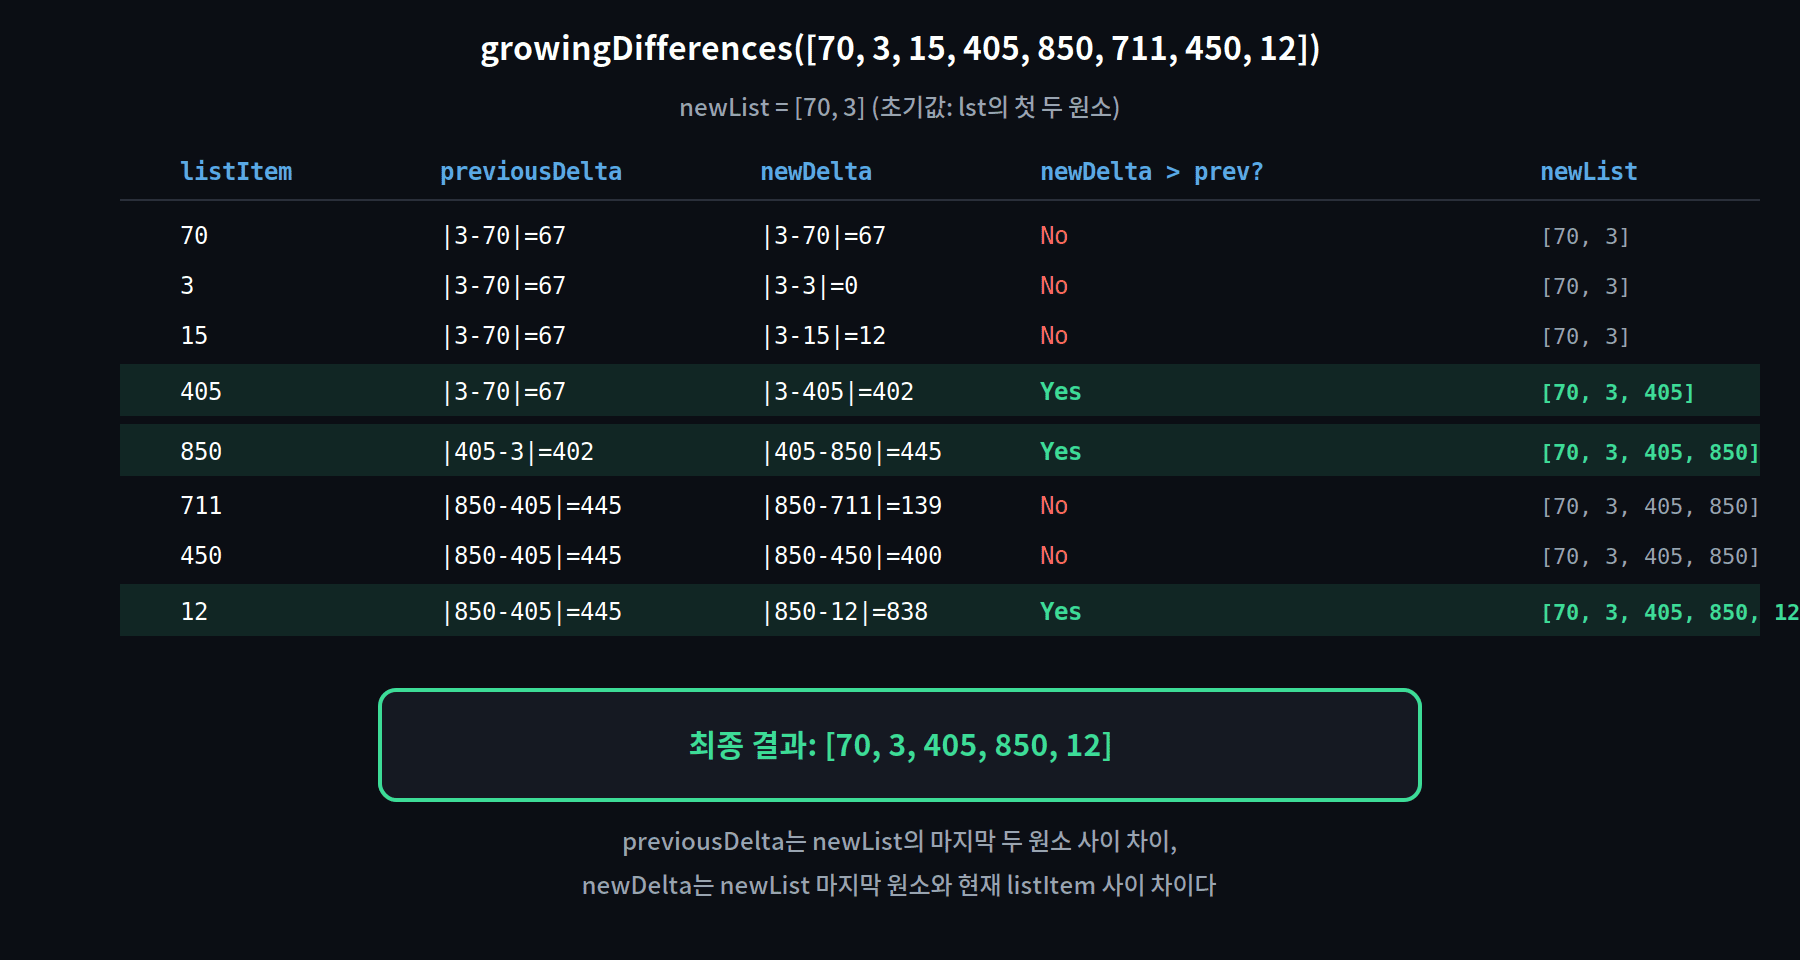
몇 가지 짚을 부분이 있다.
newList.last는Int?(optional)를 반환한다.newList가 이미 최소 2개 원소를 갖고 있다는 걸 알고 있으니 강제 언래핑도 가능하지만, 그건 원칙적으로 지양하고 싶어서?? 0으로 nil-coalescing 처리했다. 타입을let last: Int로 명시적으로 선언해두면, 혹시라도??를 빼먹었을 때 컴파일러가 타입 불일치로 바로 알려준다nextToLast는newList.dropLast().last로 구한다.dropLast()로 마지막 원소를 제외한 나머지를 얻고, 그중에서 다시.last를 꺼내는 방식이다previousDelta는newList의 마지막 두 원소 사이의 차이,newDelta는newList의 마지막 원소와 지금 순회 중인listItem사이의 차이다. 이 둘을 비교해서newDelta가previousDelta보다 크면listItem을newList에 추가한다
여기서 헷갈리기 쉬운 부분은, lst를 순회하면서도 비교 기준(previousDelta, nextToLast)은 계속 newList(원본이 아니라 지금까지 골라낸 결과)를 기준으로 갱신된다는 점이다. 이 점을 놓치면 로직이 꼬이기 쉽다.
최종 코드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
static func growingDifferences(lst: [Int]) -> [Int] {
    if lst.count < 2 {
        return []
    }
    var newList: [Int] = Array(lst[0..<2])

    for listItem in lst {
        let last: Int = newList.last ?? 0
        let nextToLast: Int = newList.dropLast().last ?? 0

        let previousDelta = abs(last - nextToLast)
        let newDelta = abs(last - listItem)
        if newDelta > previousDelta {
            newList.append(listItem)
        }
    }

    return newList
}
UI에서 기록할 만한 것
GrowingDifferencesView는 SumOfProductsView의 구조를 거의 그대로 복사해서 만들었다. part2Problems.growingDifferences(lst:)를 호출하는 computed property, RandomlyUpdateListView로 리스트를 편집하는 부분까지 패턴이 동일해서, 새롭게 기록해둘 만한 내용은 딱히 없다. 다만 결과 리스트를 문자열로 출력할 때 "\(newList)"처럼 직접 보간하지 않고 newList.description을 명시적으로 쓴 것 정도가 눈에 띄는데, 배열의 description은 CustomStringConvertible을 통해 "[70, 3, 405, 850, 12]" 형태로 변환해주는 표준 방식이라 결과적으로는 동일하게 동작한다.
repeatedSubstring 챌린지
문자열 myString과 양의 정수 k가 주어졌을 때, 길이 k인 부분 문자열 중 모든 문자가 동일한 첫 번째 부분 문자열을 찾아 반환한다. 대소문자는 다른 문자로 취급한다. 그런 부분 문자열이 없으면(빈 문자열인 경우 포함) nil을 반환한다. 추가로, 찾은 부분 문자열이 시작하는 인덱스도 함께 반환한다.
예를 들어 "aabbbc"에서 k=2면 ("aa", 0), k=3이면 ("bbb", 2)가 정답이다.
기본 구조
1
2
3
4
5
6
7
8
9
10
11
12
static func repeatedSubstring(myString: String, k: Int) -> (repeatString: String, index: Int)? {
    if k <= 0 {
        return nil
    }

    for (index, ch) in myString.enumerated() {
        let repeatString = String(repeating: ch, count: k)
        // ...
    }

    return nil
}
myString을 순회하면서, 각 문자를 k번 반복한 문자열(repeatString)을 만들고, 그게 실제로 myString의 해당 위치에서 나타나는지 비교하는 접근이다.
범위 비교로 완성하기
1
2
3
4
5
6
7
8
9
for (index, ch) in myString.enumerated() {
    let repeatString = String(repeating: ch, count: k)
    let start = myString.index(myString.startIndex, offsetBy: index)
    let end = myString.index(start, offsetBy: k)

    if repeatString == myString[start..<end] {
        return (repeatString, index)
    }
}
String은 정수로 바로 subscript 접근이 안 되기 때문에, String.Index를 직접 계산해야 한다. start는 myString의 시작 인덱스에서 현재 index만큼 offset을 준 위치, end는 거기서 다시 k만큼 offset을 준 위치다. 이 start..<end 범위와 repeatString을 비교해서 일치하면 그 자리가 정답이다.
겪었던 버그: 순회 범위 자체가 잘못됨
이 상태로 myString = "aabbbc", k = 5처럼 k가 문자열 길이에 가까운 경우를 생각해보면 문제가 생긴다. 순회 인덱스가 문자열 끝 근처까지 가면, start에서 k만큼 offset을 준 end가 문자열의 범위를 넘어서게 된다. myString의 유효한 시작 위치는 “그 자리부터 k개를 확보할 수 있는 위치”까지여야 하므로, 순회 대상 자체를 myString.dropLast(k-1)로 미리 줄여야 한다.
1
2
3
for (index, ch) in myString.dropLast(k - 1).enumerated() {
    // ...
}
여기서 실제로 off-by-one 버그를 만났다. 처음엔 dropLast(k)로 썼는데, myString = "ccc", k = 3으로 테스트하니 분명 "ccc" 전체가 정답이어야 하는데 nil이 반환됐다.
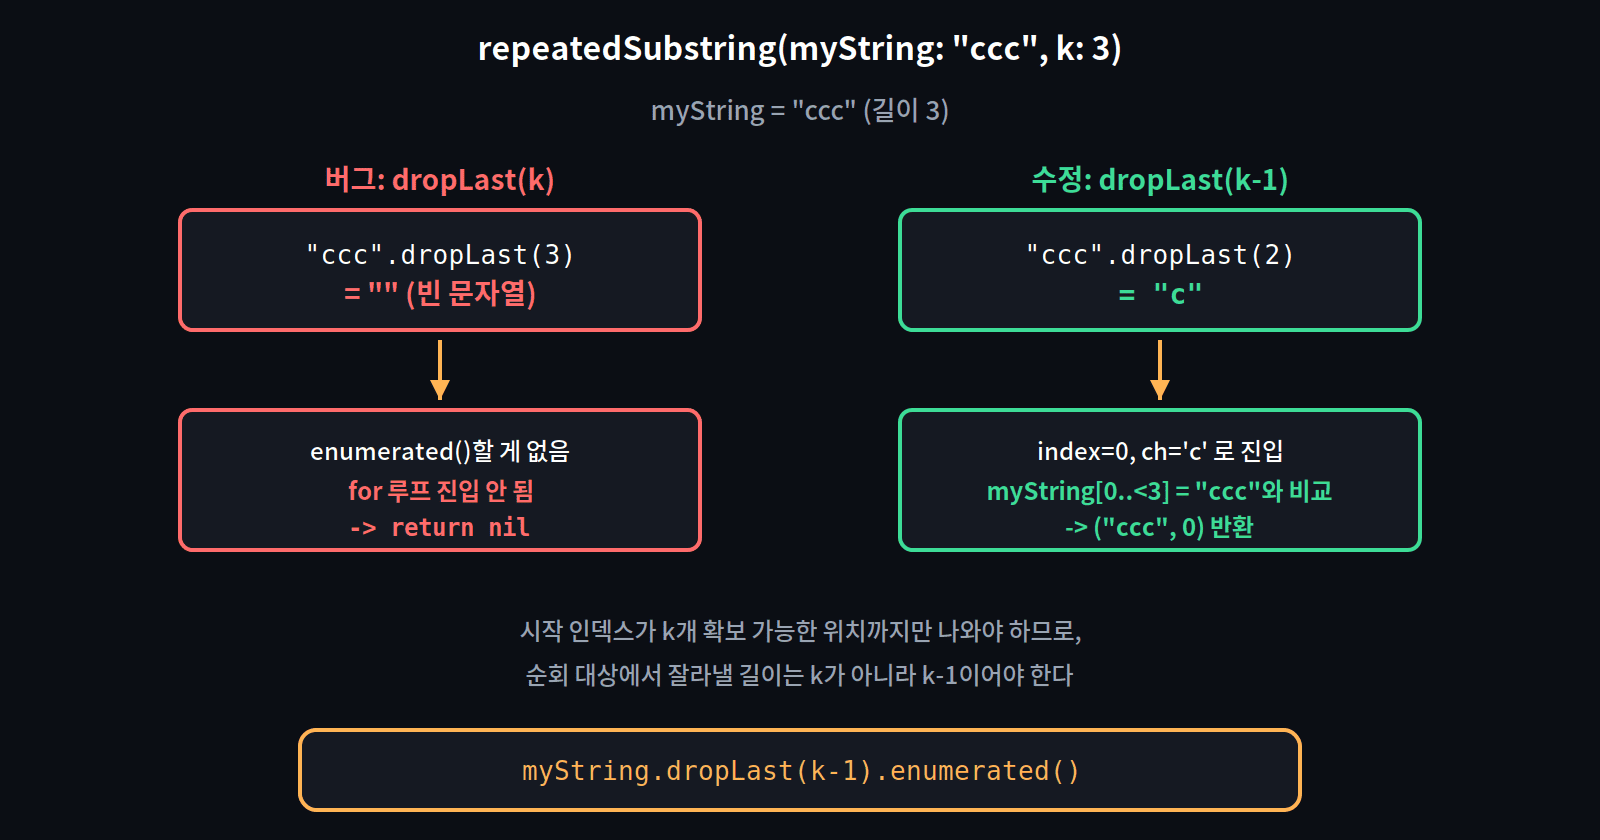
원인은 "ccc".dropLast(3)이 빈 문자열이 되어버려서, enumerated()로 순회할 대상 자체가 아예 없어졌기 때문이었다. for 루프에 브레이크포인트를 찍어봐도 한 번도 진입하지 않고 바로 return nil로 빠져나갔다. k개를 드롭하면 한 글자도 안 남는데, k-1개만 드롭하면 "c" 한 글자가 남아서 index=0, ch='c'로 루프에 정상 진입하고, myString[0..<3]("ccc")과 비교해서 올바르게 ("ccc", 0)을 반환한다.
최종 코드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
static func repeatedSubstring(
    myString: String,
    k: Int) -> (repeatString: String, index: Int)? {
        if k <= 0 {
            return nil
        }

        for (index, ch) in myString.dropLast(k - 1).enumerated() {
            let repeatString = String(repeating: ch, count: k)
            let start = myString
                .index(myString.startIndex, offsetBy: index)
            let end = myString
                .index(start, offsetBy: k)

            if repeatString == myString[start..<end] {
                return (repeatString, index)
            }
        }

        return nil
    }
UI에서 기록할 만한 것
RepeatedSubstringView에서 결과 문자열을 세 부분(찾은 지점 이전 / 반복 부분 / 이후)으로 나눠서 색을 다르게 입히는 부분이 눈에 띈다.
1
2
3
4
5
6
7
8
HStack {
    Text(text.prefix(data.index))
    +
    Text(data.repeatString)
        .foregroundColor(.blue)
    +
    Text(text.dropFirst(data.index + multiplesInt))
}
Text 뷰는 + 연산자로 여러 개를 이어붙일 수 있는데, 이때 각 Text에 개별적으로 스타일(.foregroundColor 등)을 적용한 뒤 합치면, 한 문장 안에서 부분적으로 다른 스타일을 가진 텍스트를 만들 수 있다. text.prefix(data.index)로 매치 이전 구간을, data.repeatString으로 매치된 구간(파란색으로 강조)을, text.dropFirst(data.index + multiplesInt)로 매치 이후 구간을 각각 잘라서 이어붙이는 방식이다. 문자열 안의 특정 부분만 하이라이트해야 하는 상황에서 재사용할 만한 패턴이다.
Part 2 Unit Testing: 헬퍼 함수로 반복 줄이기, 그리고 겪은 문제들
Part 2에서 만든 함수들에 대한 unit test를 작성한다. firstDivisible부터 시작해서, 테스트를 작성하다가 실제로 겪은 두 가지 문제(Xcode 테스트가 멈추는 현상, 0으로 나누기 crash)도 함께 다룬다.
처음엔 각 케이스를 XCTAssertEqual로 직접 나열
1
2
3
4
5
6
7
8
9
10
11
func testFirstDivisible() {
    XCTAssertEqual(
        part2Problems.firstDivisible(lst: [16, 12, 36], a: 6),
        1)

    XCTAssertEqual(
        part2Problems.firstDivisible(lst: [16, 12, 36], a: 8),
        0)

    // ... 케이스가 늘어날수록 계속 반복
}
케이스마다 part2Problems.firstDivisible(lst:a:)를 호출하고 XCTAssertEqual로 비교하는 코드가 계속 반복된다.
private 헬퍼 함수로 리팩토링하기
반복을 줄이기 위해, 입력값과 기대값만 받아서 내부적으로 호출과 비교를 처리하는 헬퍼 함수를 만든다.
1
2
3
4
private func firstDivisibleSampleTest(lst: [Int], a: Int, expectedValue: Int?) {
    XCTAssertEqual(
        part2Problems.firstDivisible(lst: lst, a: a), expectedValue)
}
이제 testFirstDivisible()은 이 헬퍼를 여러 번 호출하는 것으로 단순해진다.
1
2
3
4
5
6
7
8
func testFirstDivisible() {
    firstDivisibleSampleTest(lst: [16, 12, 36], a: 6, expectedValue: 1)
    firstDivisibleSampleTest(lst: [16, 12, 36], a: 8, expectedValue: 0)
    firstDivisibleSampleTest(lst: [16, 12, 36], a: 18, expectedValue: 2)
    firstDivisibleSampleTest(lst: [16, 12, 36], a: 17, expectedValue: nil)
    firstDivisibleSampleTest(lst: [], a: 1, expectedValue: nil)
    firstDivisibleSampleTest(lst: [12, 15], a: 0, expectedValue: nil)
}
firstDivisibleSampleTest는 private으로 선언했는데, 이 파일 밖에서 호출할 일이 없기 때문이다. 이름이 test로 시작하지 않아서 Xcode의 테스트 러너가 이 함수 자체를 개별 테스트로 인식하지 않는다는 점도 중요하다. 즉 testFirstDivisible() 옆에만 실행 다이아몬드가 뜨고, firstDivisibleSampleTest는 그 안에서 호출되는 일반 헬퍼로만 동작한다.
일부러 기대값을 틀리게 넣어서(0 대신 다른 값) 테스트가 실제로 실패하는지도 확인했다. 실패 메시지가 “Optional(1) is not Optional(0)”처럼 정확히 어떤 값이 기대와 달랐는지 알려주는 걸 확인하고, 다시 올바른 값으로 되돌렸다.
겪었던 문제 1: 강의에서 겪은 Xcode 테스트 멈춤 현상
1
2
3
4
5
6
7
8
9
10
11
12
13
final class Part_2_Tests: XCTestCase {
    func testFirstDivisible() {
        // set up
        let lst1: [Int] = [16, 12, 36]
        let a1: Int = 6

        // Expected values
        let expectedValue1: Int? = 1

        // Run tests
        XCTAssertEqual(Part2Problems.firstDivisible(lst: lst1, a: a1), expectedValue1)
    }
}
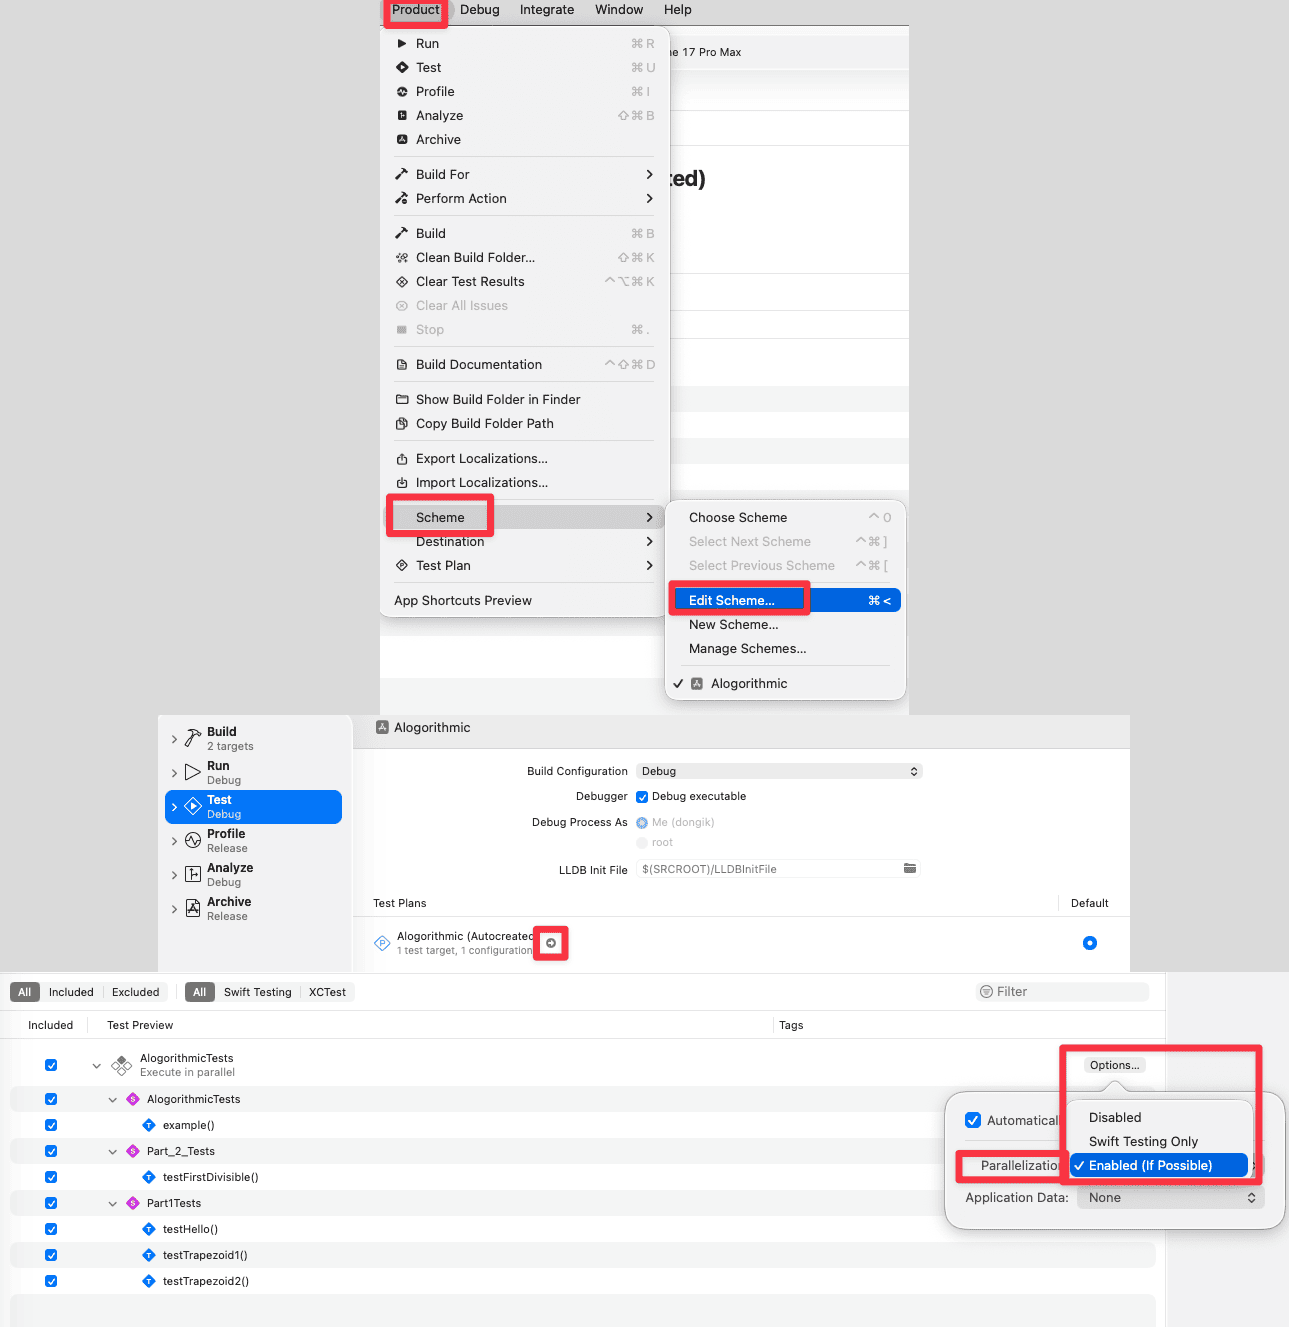
강의에서는 테스트를 실행했는데 “Build Succeeded” 이후로 테스트 자체가 계속 멈춘 상태로 진행되지 않는 문제를 겪었다고 한다. Clean Build Folder와 테스트 결과 클리어로도 해결이 안 됐다고 한다.
강사가 찾은 해결 방법은 Xcode 메뉴에서 Product → Scheme → Edit Scheme으로 들어가서, Test 항목을 선택하고 Options 탭에서 “Execute in parallel” 체크를 해제하는 것이었다. 이 옵션을 끄니 테스트가 정상적으로 실행됐다고 하는데, 병렬 실행 옵션이 왜 테스트 러너를 멈추게 만들었는지 정확한 원인까지는 본인도 확신하지 못했다.
겪었던 문제 2: 의도적으로 가정을 깨뜨려서 crash 유발하기
firstDivisible은 a가 양수라고 가정하고 만든 함수였다. 이 가정을 실제로 깨뜨려서 어떻게 되는지 확인해봤다.
1
2
3
4
5
6
7
8
9
10
11
func testFirstDivisible() {
    // set up
    let lst1: [Int] = [12, 15]
    let a1: Int = 0

    // Expected values
    let expectedValue1: Int? = nil

    // Run tests
    XCTAssertEqual(Part2Problems.firstDivisible(lst: lst1, a: a1), expectedValue1)
}
a를 0으로 넣으니 실제로 앱이 crash했다. 내부적으로 element % a를 계산하다가 0으로 나누기가 발생한 것이다. Xcode가 crash 지점을 바로 가리켜줘서, 문제의 근원을 즉시 찾을 수 있었다.
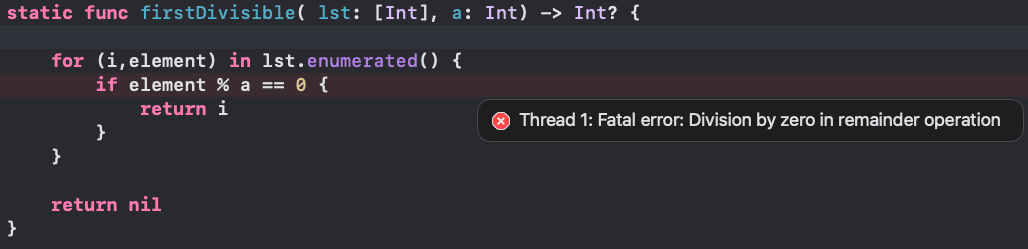
이 발견을 반영해서, firstDivisible 함수 자체에 방어 코드를 추가했다.
1
2
3
if a == 0 {
    return nil
}
원래 문제 조건에서는 “a는 양수”라고 가정했으니 이런 방어가 “규칙을 어기는” 셈이지만, 실제로 unit test를 작성하는 과정에서 유효하지 않은 입력을 넣어보게 됐고, 그 결과 함수를 더 견고하게 만들 수 있었다. 참고로 음수 a는 이 함수에서 별문제 없이 정상 동작한다.
numberOfStringsAboveAverage: 세 가지 구현을 한 번에 검증하기
numberOfStringsAboveAverage는 for 버전, while 버전, 그리고 이후 Part 3(함수형 스타일)에서 만들 Swifty 버전까지 총 세 가지 구현이 있다. 이 세 버전이 전부 같은 결과를 내는지 한 테스트 함수 안에서 함께 검증한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
func testNumberOfStringsAboveAverage() {
    // Setup
    let ex1: [String] = ["Hummus", "Apple", "Banana"]
    let ex2: [String] = ["Hummus", "Hummus", "Banana"]
    let ex3: [String] = []

    // Expected values
    let v1: (num: Int, average: Double?) = (2, 5.6666666)
    let v2: (num: Int, average: Double?) = (0, 6)
    let v3: (num: Int, average: Double?) = (0, nil)

    let accuracy = 0.000001

    // *** For version tests ***
    XCTAssertEqual(part2Problems.numberOfStringsAboveAverageFor(lst: ex1).num, v1.num)
    XCTAssertEqual(part2Problems.numberOfStringsAboveAverageFor(lst: ex2).num, v2.num)
    XCTAssertEqual(part2Problems.numberOfStringsAboveAverageFor(lst: ex3).num, v3.num)

    XCTAssertEqual(part2Problems.numberOfStringsAboveAverageFor(lst: ex1).average!, v1.average!, accuracy: accuracy)
    XCTAssertEqual(part2Problems.numberOfStringsAboveAverageFor(lst: ex2).average!, v2.average!, accuracy: accuracy)

    // Testing for nil
    XCTAssertEqual(part2Problems.numberOfStringsAboveAverageFor(lst: ex3).average, v3.average)

    // *** While version tests *** (for와 동일한 패턴 반복)
    // *** Functional version tests *** (part3Problems.numberOfStringsAboveAverageSwifty, 동일 패턴 반복)
}
여기서 눈여겨볼 부분이 있다.
average는Double?(optional)이라accuracy를 쓰는XCTAssertEqual(_:_:accuracy:)에 그대로 넣을 수 없다. 이 오버로드는Double(non-optional)을 요구하기 때문이다. 그래서nil이 아님을 이미 알고 있는 케이스(ex1,ex2)에 한해average!,v1.average!처럼 강제 언래핑해서 넘긴다- 반면
ex3(빈 리스트)처럼 결과가nil이어야 하는 케이스는accuracy비교가 아예 필요 없다.average값 자체(Double?)를 그대로XCTAssertEqual(_:_:)로 비교해서 “둘 다nil인지”만 확인한다 num(정수)은 애초에Double오차 문제가 없으니accuracy없이 일반XCTAssertEqual로 비교한다
같은 패턴을 for, while, Swifty 세 구현에 대해 반복하면서, 세 가지 구현 방식이 전부 동일한 결과를 낸다는 걸 한 테스트 함수 안에서 확인한다.
남은 연습: 나머지 함수들 테스트 작성
이 시점부터는 반복적인 작업이라, 나머지 함수들(sumOfProducts, growingDifferences, repeatedSubstring)에 대한 테스트는 직접 작성해보는 연습으로 남겨뒀다. 특히 repeatedSubstring은 k가 양의 정수라고 가정하고 만든 함수라서, k가 0이거나 음수인 경우까지 테스트할지는 선택의 문제라고 짚었다. 이미 repeatedSubstring에는 k <= 0이면 nil을 반환하는 방어 코드가 들어가 있는데(그렇지 않으면 dropLast(k-1)에서 k-1이 -1이 되어 문제가 생길 수 있다), 이런 방어를 어디까지 넣을지는 “함수가 가정을 어디까지 스스로 지켜야 하는가”에 대한 설계 판단의 문제다.