Swift Algorithms (3) - UnitTest
첫 번째 Unit Test 작성하기: XCTest 시작하기
이제 지금까지 만든 part1Problems의 함수들을 실제로 테스트해본다. hello 함수부터 시작한다.
Unit Test 파일 만들기
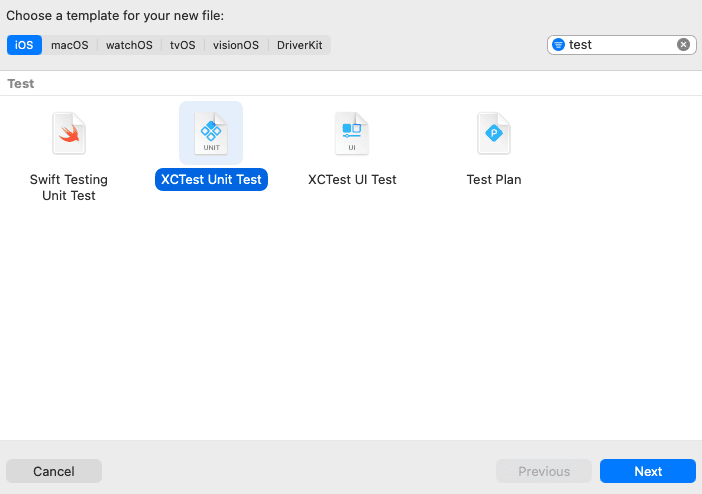
Xcode에서 File → New로 새 파일을 만들 때 “test”로 검색하면 여러 템플릿이 뜨는데, UI Test가 아니라 Unit Test를 선택해야 한다. 이름은 Part_1_Tests로 짓는다.
그리고 만약 No Such Module 에러가 뜬다면
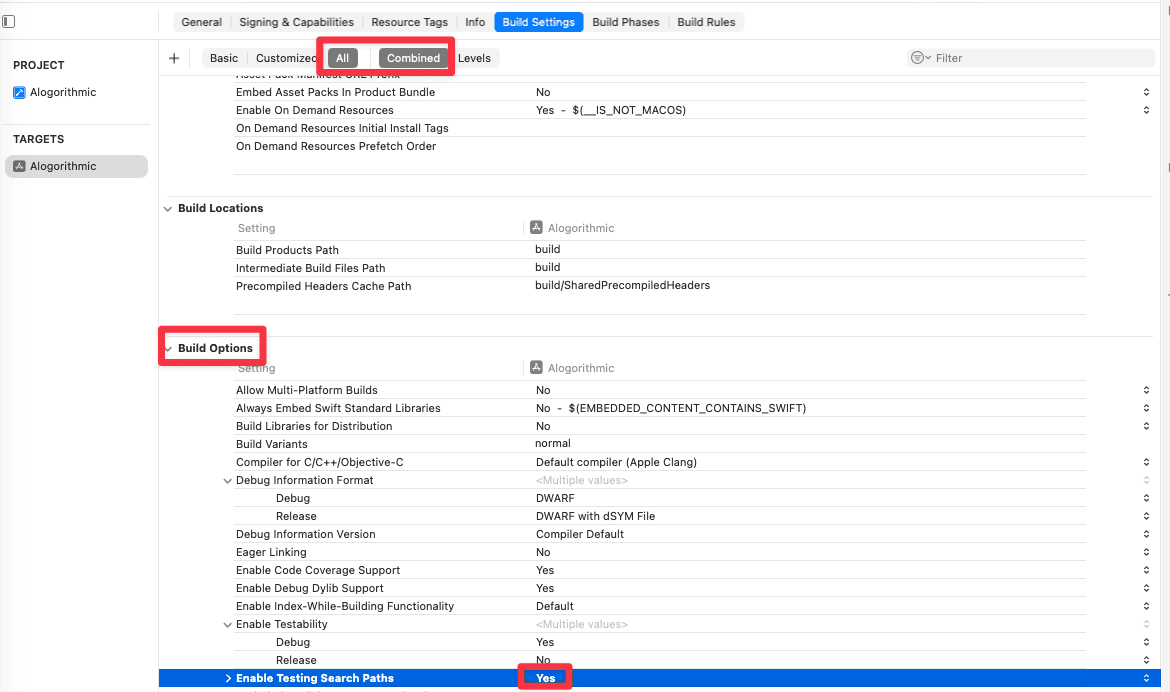
이렇게 Yes로 변경해주고 빌드를 다시하면된다.
1
2
3
4
5
6
import XCTest
@testable import Alogorithmic

final class Part_1_Tests: XCTestCase {

}
@testable import로 프로젝트를 가져오는 게 핵심이다. (이때 import 뒤에는 프로젝트 이름을 그대로 가져오면 된다.)
일반 import와 다르게, @testable을 붙이면 internal 접근 수준으로 선언된 타입과 함수까지 테스트 코드에서 접근할 수 있다. 보통 앱 코드에서는 굳이 public으로 열어두지 않는 내부 로직도, 테스트에서는 이렇게 접근해서 검증할 수 있어야 하기 때문이다.
하지만 아래와 같이 경고가 뜬다.

이건 테스트 파일이 잘못된 타겟에 추가된 게 문제이다. @testable import Alogorithmic은 별도의 테스트 타겟에 있는 파일에서 써야 하기때문.
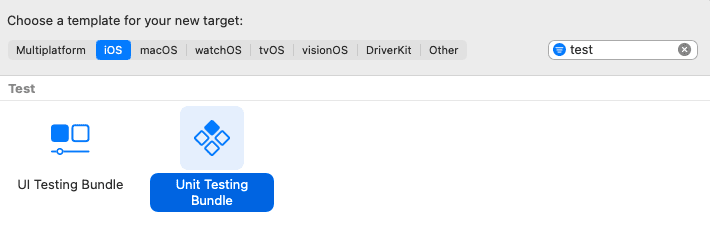
이렇게 테스트 타겟을 추가해주고 타겟을 바꿔준다. 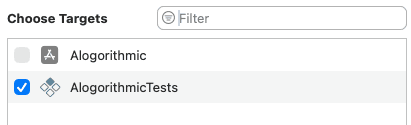
testHello() 작성하기: Set up → Apply → Test 3단계
테스트 함수는 test로 시작하는 이름을 가져야 XCTest가 인식해서 실행해준다. hello 함수가 가장 간단하니 여기서부터 시작한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
func testHello() {
    // Set up data
    let name1 = "rON"
    let name2 = ""
    let name3 = "hello wORLD"

    // Apply function
    let hello1 = Part1Problems.hello(name: name1)
    let hello2 = Part1Problems.hello(name: name2)
    let hello3 = Part1Problems.hello(name: name3)

    // Test it
    XCTAssertEqual(hello1, "Hello Ron!")
    XCTAssertEqual(hello2, nil)
    XCTAssertEqual(hello3, "Hello Hello World!")
}
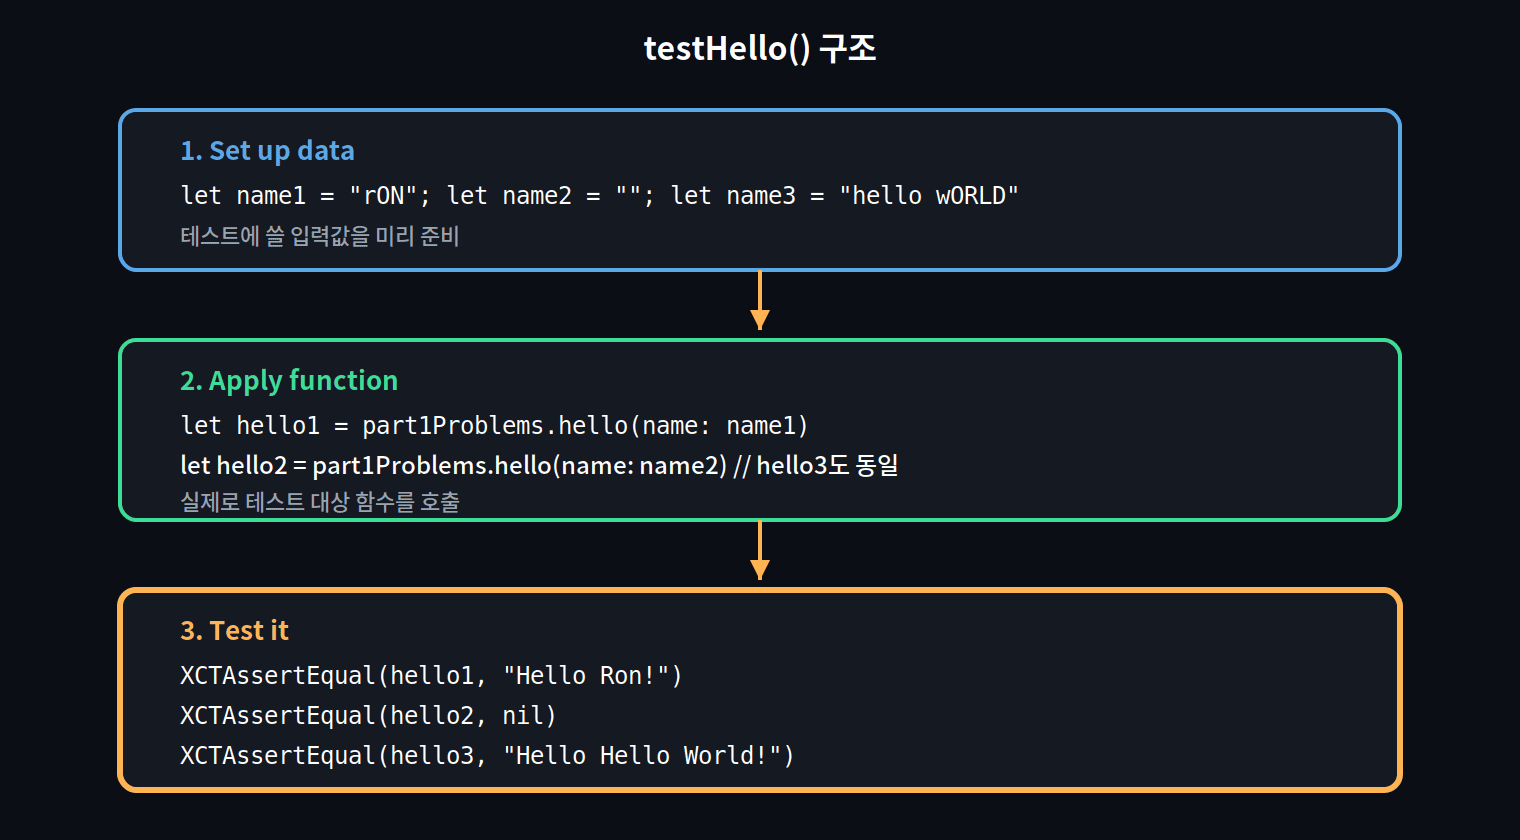
하나의 테스트 함수를 이 세 단계로 나눠서 작성하는 습관을 들이면 읽기가 훨씬 쉬워진다.
- Set up data: 테스트에 쓸 입력값을 미리 준비한다. 대소문자가 섞인 이름(
"rON"), 빈 문자열(""), 여러 단어로 된 이름("hello wORLD")처럼 일반적인 케이스와 경계 케이스를 함께 챙긴다 - Apply function: 실제로 테스트 대상 함수(
part1Problems.hello(name:))를 호출해서 결과를 변수에 담는다 - Test it:
XCTAssertEqual(_:_:)로 실제 결과와 기대값이 일치하는지 검증한다
XCTAssertEqual은 첫 번째 인자(실제 값)와 두 번째 인자(기대값)를 비교해서, 다르면 테스트를 실패로 표시한다. 세 번째 인자로 실패 시 보여줄 메시지를 추가할 수도 있다.
왜 뻔해 보이는 결과도 테스트하는가
hello 함수는 이미 결과가 뭐가 나올지 뻔히 아는 함수인데도 굳이 테스트를 작성하는 이유가 있다. 지금 당장은 확실히 동작하지만, 나중에 코드를 리팩토링하거나 기능을 추가하는 과정에서 실수로 hello 로직이 깨질 수 있다. 이럴 때 테스트가 있으면 그 순간 바로 알아챌 수 있다. 또한 같은 강의를 듣는 다른 사람이 직접 구현한 버전과 결과가 일치하는지 확인하는 용도로도 쓸 수 있다.
일부러 틀린 기대값을 넣어서 실패 확인해보기
테스트가 실제로 실패를 감지하는지 확인하기 위해, 의도적으로 잘못된 기대값을 넣어봤다.
1
2
3
4
5
6
7
8
XCTAssertEqual(hello3, "Hello Hello Word!")  // 의도적으로 'World'를 'Word'로 오타

Test Suite 'Part1Tests' started at 2026-09-14 19:18:00.179.
Test Case '-[AlogorithmicTests.Part1Tests testHello]' started.
/Users/dongik/Documents/Workspace/Alogorithmic/AlogorithmicTests/Part1Tests.swift:27: error: -[AlogorithmicTests.Part1Tests testHello] : XCTAssertEqual failed: ("Optional("Hello Hello World!")") is not equal to ("Optional("Hello Hello Word!")")
Test Case '-[AlogorithmicTests.Part1Tests testHello]' failed (0.330 seconds).
Test Suite 'Part1Tests' failed at 2026-09-14 19:18:00.510.
	 Executed 1 test, with 1 failure (0 unexpected) in 0.330 (0.331) seconds
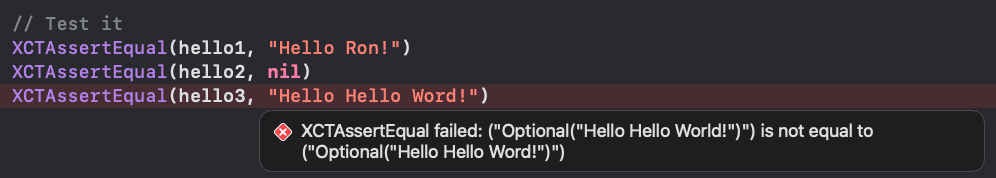
실행해보니 예상대로 테스트가 빨간색으로 실패했고, XCTest가 어떤 값과 어떤 값이 달랐는지(“Hello Hello World!” vs “Hello Hello Word!”) 정확히 알려줬다. 오타를 고쳐서 "Hello Hello World!"로 되돌리니 다시 초록색으로 통과했다.
이 과정에서 한 가지 흥미로운 포인트도 짚었다. "hello wORLD"를 hello 함수에 넣으면 "Hello Hello World!"가 나온다. 함수 자체가 “Hello”라는 인사말 뒤에 이름을 붙이는 구조라, 입력값 자체에 이미 “hello”라는 단어가 들어있어도 그건 그냥 이름의 일부로 취급되어 그대로 대문자로 정규화되어 붙는다. 우연히도 “Hello Hello World!”처럼 “Hello”가 두 번 나오는 자연스러운 결과가 만들어진 것.
Trapezoid 함수 테스트하기: Double 비교의 함정
이번엔 trapezoid 함수를 테스트하면서, Double 값을 비교할 때 마주치는 문제를 직접 겪어본다. 테스트 데이터는 omnicalculator.com의 사다리꼴 넓이 계산기로 미리 계산해서 준비했다.
첫 번째 테스트: 정사각형으로 단순하게 시작하기
가장 간단한 경우부터 시작한다. 네 변의 길이가 모두 같은 정사각형이면 계산이 단순해서 검증하기 쉽다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
func testTrapezoid1() {
    // Set up data
    let someConst = 0.9999999989
    let AB = someConst
    let BC = someConst
    let DC = someConst
    let AD = someConst
    let area = someConst * someConst

    // Apply function
    let trapezoid = part1Problems
        .trapezoid(AB: AB, BC: BC, DC: DC, AD: AD, area: area)

    // Test it
    XCTAssertEqual(trapezoid.circumference, 4 * someConst)
    XCTAssertEqual(trapezoid.height, someConst)
    XCTAssertEqual(trapezoid.midSegment, someConst)
}
네 변이 전부 someConst로 같으니 둘레는 4 * someConst, 높이와 mid-segment는 둘 다 someConst 그대로여야 한다. someConst를 0.9999999989처럼 애매하게 잡아서 반올림 문제가 생기길 기대했는데, 이 케이스에서는 문제없이 통과했다.
XCTAssertEqual(::accuracy:)로 오차 허용하기
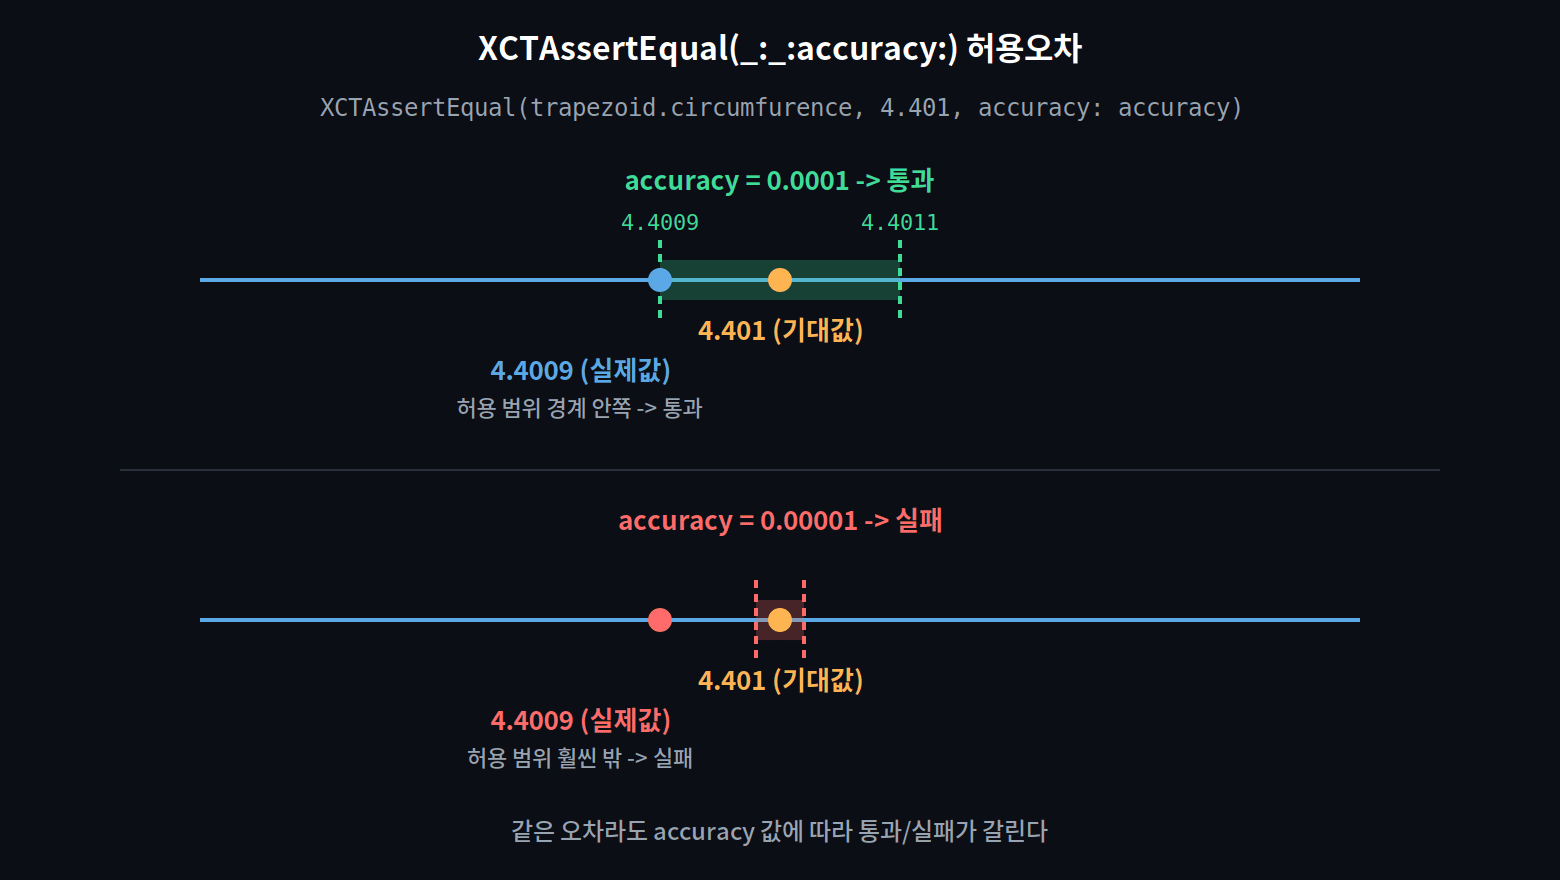
애초에 XCTAssertEqual(_:_:)을 Double끼리 그대로 비교하지 않고, 처음부터 accuracy 파라미터가 있는 오버로드를 썼다. Double 연산은 부동소수점 특성상 수학적으로 같아야 할 값도 미세한 오차가 생길 수 있어서, 정확히 ==로 비교하는 대신 “기대값과의 차이가 accuracy 이내인가”를 확인하는 방식을 쓴다.
두 번째 테스트: 실제로 오차 문제를 만나다
이번엔 정사각형이 아니라 실제 계산기에서 뽑아낸 복잡한 숫자로 테스트한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
func testTrapezoid2() {
    // Set up data
    let AB = 1.23
    let BC = 3.3
    let DC = 0.1
    let AD = 3.2
    let area = 1.2635

    // Apply function
    let trapezoid = part1Problems
        .trapezoid(AB: AB, BC: BC, DC: DC, AD: AD, area: area)

    // Test it
    let accuracy = 0.0001
    XCTAssertEqual(trapezoid.circumfurence, 7.83, accuracy: accuracy)
    XCTAssertEqual(trapezoid.height, 1.9, accuracy: accuracy)
    XCTAssertEqual(trapezoid.midSegment, 0.665, accuracy: accuracy)
}
처음 실행했을 때 실패가 났다. 실제 계산된 둘레가 7.829999999...처럼 나왔는데, 기대값으로 넣은 7.83과 정확히 일치하지 않았던 것. 이게 바로 Double 비교가 까다로운 이유를 직접 보여주는 사례다. 수학적으로는 두 값이 같아야 하는데, 컴퓨터의 부동소수점 표현 방식 때문에 아주 작은 오차가 생긴 것이다. accuracy 파라미터를 적절한 값(0.0001)으로 설정해두니 이 정도 오차는 허용 범위 안에 들어와서 테스트가 통과했다.
세 번째 테스트: 입력 실수와 오차 허용 범위 조절하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
func testTrapezoid3() {
    // Set up data
    let AB = 0.1
    let BC = 2.0
    let DC = 0.3
    let AD = 2.0009
    let area = 0.38

    // Apply function
    let trapezoid = part1Problems
        .trapezoid(AB: AB, BC: BC, DC: DC, AD: AD, area: area)

    // Test it
    let accuracy = 0.0001
    XCTAssertEqual(trapezoid.circumfurence, 4.401, accuracy: accuracy)
    XCTAssertEqual(trapezoid.height, 1.9, accuracy: accuracy)
    XCTAssertEqual(trapezoid.midSegment, 0.2, accuracy: accuracy)
}
이번엔 accuracy를 아예 빼고(정확히 ==로 비교) 테스트해봤는데, 예상대로 실패했다. 둘레 계산 결과 4.4009...가 기대값 4.401과 정확히 일치하지 않았기 때문이다. 그런데 실패 중 하나는 진짜 버그가 아니라 테스트 작성 실수였다. mid-segment의 기대값을 2.0으로 넣었는데, 실제로 계산기에서 뽑은 정확한 값은 0.2였던 것. 기대값 자체를 잘못 입력한 케이스였다.
이 지점에서 accuracy 값 자체를 얼마로 잡아야 하는지도 실험해봤다.
accuracy = 0.0001로 설정하면4.4009와4.401의 차이(0.0001)가 허용 범위 경계 안에 들어와서 통과한다accuracy를0.00001처럼 더 작게 줄이면, 같은 두 값의 차이가 이제는 허용 범위를 벗어나서 실패한다
즉 같은 오차라도 accuracy를 얼마나 타이트하게 잡느냐에 따라 테스트가 통과할 수도, 실패할 수도 있다. accuracy를 너무 크게 잡으면 진짜 버그도 통과시켜버리고, 너무 작게 잡으면 정상적인 부동소수점 오차까지 실패로 잡아버린다. 그래서 상수 하나(let accuracy = 0.0001)로 빼서 모든 assertion에 일관되게 적용하는 방식을 택했다.
한계: trapezoid 함수 자체가 입력을 검증하지 않는다
한 가지 더 짚어볼 점이 있다. 지금 trapezoid 함수는 AB, BC, DC, AD, area 다섯 개의 숫자를 그냥 독립적으로 받는다. 이 다섯 개의 값이 실제로 기하학적으로 성립 가능한 사다리꼴을 이루는 조합인지는 함수가 검증하지 않는다. 예를 들어 (omnicalculator.com의 계산기가 실제로 하듯) 네 변의 길이만으로 사다리꼴이 존재 가능한지 확인하는 로직까지 직접 구현해보는 것도 흥미로운 연습이 될 수 있다고 언급했다.
numberDivisibleByNOptional 테스트하기: 테이블 기반 테스트와 TDD
이번엔 numberDivisibleByNOptional(number:n:)를 테스트한다. 이전 테스트들과 달리, 케이스마다 함수를 따로 두지 않고 배열 하나에 데이터를 모아서 반복문으로 돌리는 방식을 쓴다. 그리고 그 과정에서 테스트를 먼저 작성하고 나서 실제 함수 로직을 거기 맞춰 고치는, TDD에 가까운 흐름도 경험하게 된다.
배열 하나로 여러 케이스를 관리하기
Trapezoid를 테스트할 때는 케이스마다 별도의 testTrapezoid1, testTrapezoid2, testTrapezoid3 함수를 만들었는데, 이번엔 다른 방식을 쓴다. 입력 데이터와 기대값을 각각 배열로 만들고, 반복문으로 하나씩 돌려가며 검증하는 테이블 기반(table-driven) 테스트다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
// ( number: String, n: Int) -> Bool?
func testNumberDivisibleByNOptional() {
    // Set up data
    let data: [(number: String, n: Int)] = [
        ("24 Hummus", 3),
        ("24", 3),
        ("   \t24 \n\n\t ", 3),
        ("24", 5),
    ]

    // Expected values
    let expectedValues: [Bool?] = [
        nil,
        true,
        true,
        false
    ]

    // Run the tests
    for i in 0..<data.count {
        let value1 = part1Problems
            .numberDivisibleByNOptional(
                number: data[i].number,
                n: data[i].n)
        let value2 = expectedValues[i]

        XCTAssertEqual(value1, value2, "\n\n!!! Issue at data item \(i) when comparing \(String(describing: value1)) and \(String(describing: value2)) !!!\n\n")
    }
}
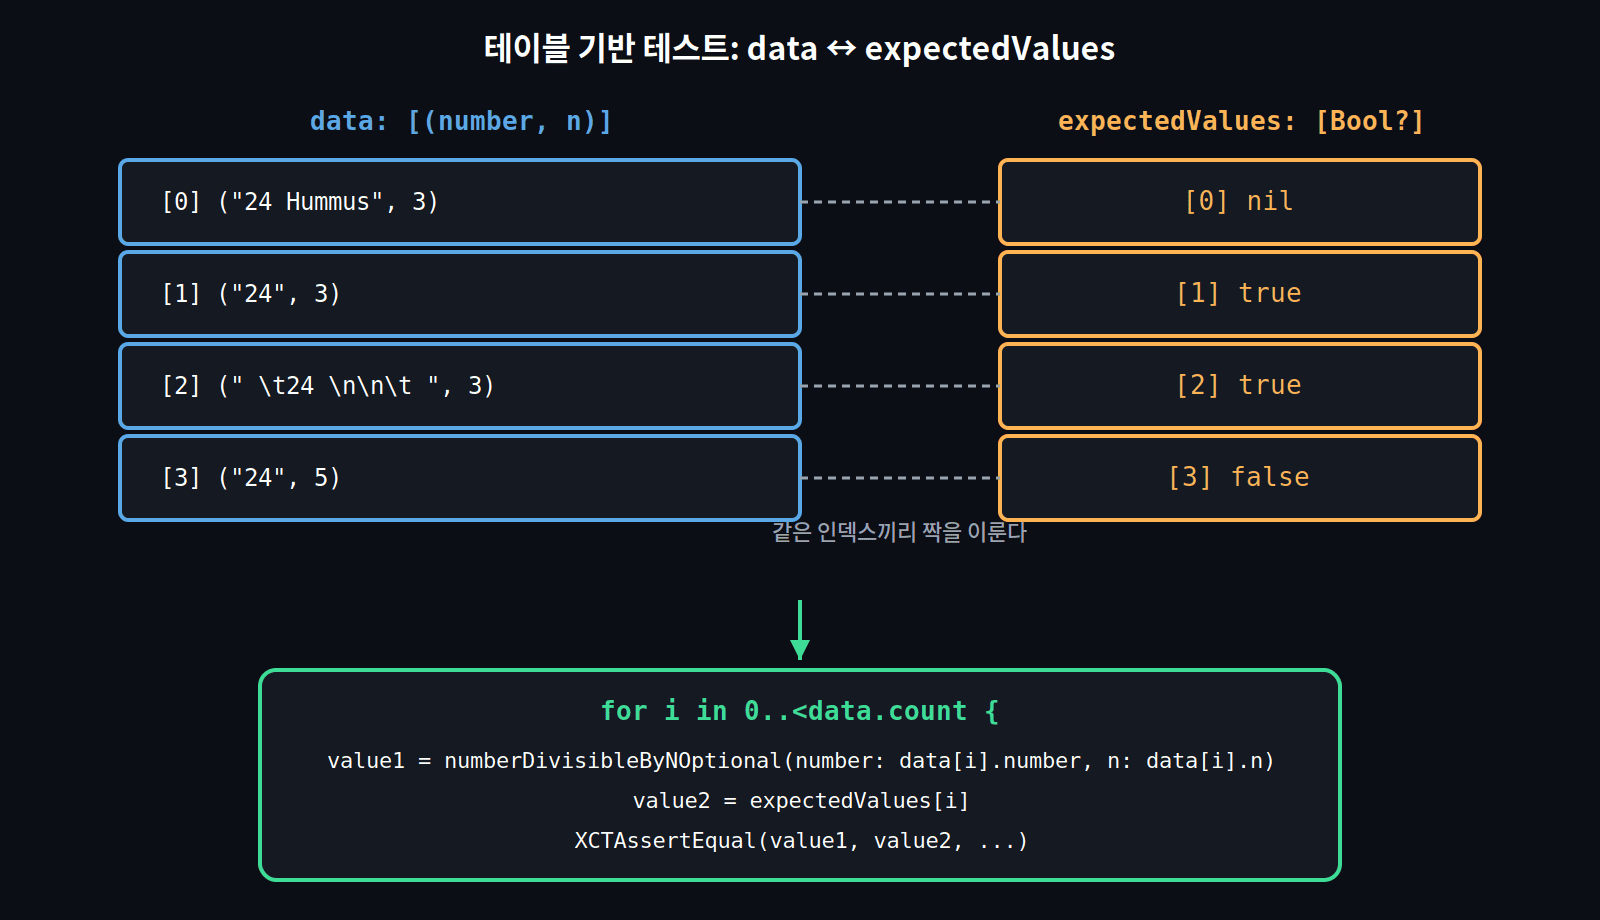
몇 가지 짚을 부분이 있다.
- 함수 주석으로 테스트 대상 함수의 시그니처(
(number: String, n: Int) -> Bool?)를 먼저 적어뒀다. 테스트 코드만 보고도 “이 함수가 뭘 받고 뭘 반환하는지” 바로 알 수 있게 하기 위해서다 data를 named tuple 배열로 선언했다.(String, Int)처럼 이름 없는 튜플이었다면data[i].0,data[i].1처럼 인덱스로 접근해야 하는데,number와n으로 이름을 붙여두면data[i].number,data[i].n으로 훨씬 읽기 쉽게 접근할 수 있다expectedValues는[Bool?]로,data와 같은 인덱스 위치에 있는 항목이 서로 쌍을 이룬다. 그래서data.count와expectedValues.count가 반드시 일치해야 한다는 전제가 깔려 있다(이 부분은 코드가 강제하진 않으니, 배열을 수정할 때 항상 조심해야 한다)XCTAssertEqual의 세 번째 인자로 실패 메시지를 넣었다.\(String(describing: value1))처럼String(describing:)으로 감싼 이유는,value1이Bool?(optional)이라 그냥 문자열 보간에 넣으면 컴파일러가 경고를 준다.String(describing:)을 쓰면 이 경고 없이 optional 값을 안전하게 문자열로 표현할 수 있다(예:nil이면"nil", 값이 있으면"Optional(true)"같은 식으로 출력)
케이스 설계: 일부러 애매한 입력 섞어넣기
네 가지 테스트 케이스를 의도를 갖고 설계했다.
("24 Hummus", 3)→ 숫자가 아닌 문자열이 섞여있으니nil을 기대("24", 3)→ 깔끔한 입력,3이24를 나누니true를 기대(" \t24 \n\n\t ", 3)→ 공백, 탭, 줄바꿈이 잔뜩 섞인"24". 이게true로 처리되어야 하는지nil로 처리되어야 하는지는 사실 실행하기 전엔 확신이 없었다고 한다("24", 5)→5는24를 나누지 못하니false를 기대
세 번째 케이스가 이 섹션의 핵심이다. 처음엔 이 케이스의 기대값을 true로 적어놓고 테스트를 돌렸는데 실패했다. 실패 메시지를 보니 nil과 true를 비교하다 났다는 걸 확인했고, 이건 함수가 공백이 섞인 문자열을 숫자로 변환하지 못해서 nil을 반환하고 있었기 때문이었다.
테스트 결과에 맞춰 실제 함수를 고치기
여기서 선택지가 두 가지 있었다. 기대값을 nil로 바꿔서 테스트를 통과시키거나, 아니면 “공백이 섞여도 숫자로 인식해야 한다”고 판단하고 함수 자체를 고치는 것. 후자를 택했다.
1
2
3
4
5
6
7
8
9
10
11
12
13
func numberDivisibleByNOptional(number: String, n: Int) -> Bool? {
    let trimmedNumber = number.trimmingCharacters(in: .whitespacesAndNewlines)

    guard let num = Int(trimmedNumber) else {
        return nil
    }

    guard n != 0 else {
        return nil
    }

    return num % n == 0
}
number.trimmingCharacters(in: .whitespacesAndNewlines)로 문자열 앞뒤의 공백, 탭, 줄바꿈을 전부 제거한 trimmedNumber를 만들고, 이후 로직에서는 원본 number 대신 이 값을 사용한다. 이렇게 고치고 세 번째 테스트 케이스의 기대값을 true로 되돌려서 다시 돌려보니 통과했다.
이 흐름 자체가 TDD적인 사고방식을 보여준다. “이 입력이 들어오면 어떤 결과가 나와야 하는가”를 테스트로 먼저 명시해두고, 실제 구현이 그 기대에 못 미치면 구현 쪽을 고쳐서 맞춘다. 반대로 테스트 쪽 기대값이 잘못됐다고 판단되면 테스트를 고친다. 둘 중 어느 쪽을 고칠지는 “함수의 책임이 어디까지인가”(공백 제거를 함수가 해야 하는지, 호출하는 쪽에서 이미 정제된 값을 넘겨야 하는지)에 대한 판단이 필요하다.
일관성 유지: numberDivisibleByN도 함께 수정
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
static func numberDivisibleByN(number: String, n: Int) -> Bool {

    let trimmedNumber = number.trimmingCharacters(in: .whitespacesAndNewlines)

    if n == 0 {
        return false
    }

    guard let num = Int(trimmedNumber) else {
        return false
    }

    return num % n == 0
}

static func numberDivisibleByNOptional(number: String, n: Int) -> Bool? {
    let trimmedNumber = number.trimmingCharacters(in: .whitespacesAndNewlines)

    guard let num = Int(trimmedNumber) else {
        return nil
    }

    // check if num is divisible by n and check that n != 0
    return n != 0 && num % n == 0
}
numberDivisibleByNOptional에 trim 로직을 추가했으니, 같은 문제를 겪을 수 있는 numberDivisibleByN (optional이 아닌 버전) 함수에도 동일한 trimmingCharacters(in:) 처리를 추가해서 두 함수의 동작을 일관되게 맞췄다. 한쪽 함수만 고치고 비슷한 역할을 하는 다른 함수를 그대로 두면, 나중에 어느 쪽을 썼는지에 따라 동작이 달라지는 혼란스러운 상황이 생길 수 있기 때문이다.
strangeRepeat / reverseSplit 테스트하기: 테스트 실패와 런타임 crash의 차이
Part 1의 마지막 두 함수, strangeRepeat과 reverseSplit을 테스트한다. 앞서 쓴 테이블 기반 패턴을 그대로 재사용하는데, 이번엔 테스트 도중 단순한 assertion 실패가 아니라 앱 자체가 죽는 진짜 crash를 만나게 된다.
testStrangeRepeat 작성하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
// strangeRepeat( text: String, copies: Int) -> String
func testStrangeRepeat() {
    // Set up data
    let data: [(text: String, copies: Int)] = [
        ("Hummus", 0),
        ("Hummus", 1),
        ("Hummus", 2),
        ("Hummus", 3),
        ("Hummus", -1),
    ]

    // Expected Values
    let expectedValues: [String] = [
        "",
        "umsHmu",
        "umsHmuumsHmu",
        "umsHmuumsHmuumsHmu",
        ""
    ]

    // Run the tests
    for i in 0..<data.count {
        let value1 = part1Problems
            .strangeRepeat(
                text: data[i].text,
                copies: data[i].copies)
        let value2 = expectedValues[i]

        XCTAssertEqual(value1, value2, "\n\n!!! Issue at data item \(i) when comparing \(String(describing: value1)) and \(String(describing: value2)) !!!\n\n")
    }
}
이전 섹션의 테이블 패턴 그대로, 함수 시그니처((text: String, copies: Int) -> String)를 주석으로 남기고, data와 expectedValues를 같은 인덱스로 짝지어 반복 검증한다. copies가 0일 때는 빈 문자열, 1~3일 때는 결합된 문자열이 그만큼 반복된다.
겪었던 문제: 테스트 실패가 아니라 진짜 crash
마지막 케이스로 copies가 음수(-1)인 경우를 넣어봤다. 이 케이스의 결과가 어떻게 나올지 확신이 없는 상태로 실행했는데, 테스트가 “실패”하는 게 아니라 테스트 프로세스 자체가 죽어버렸다.
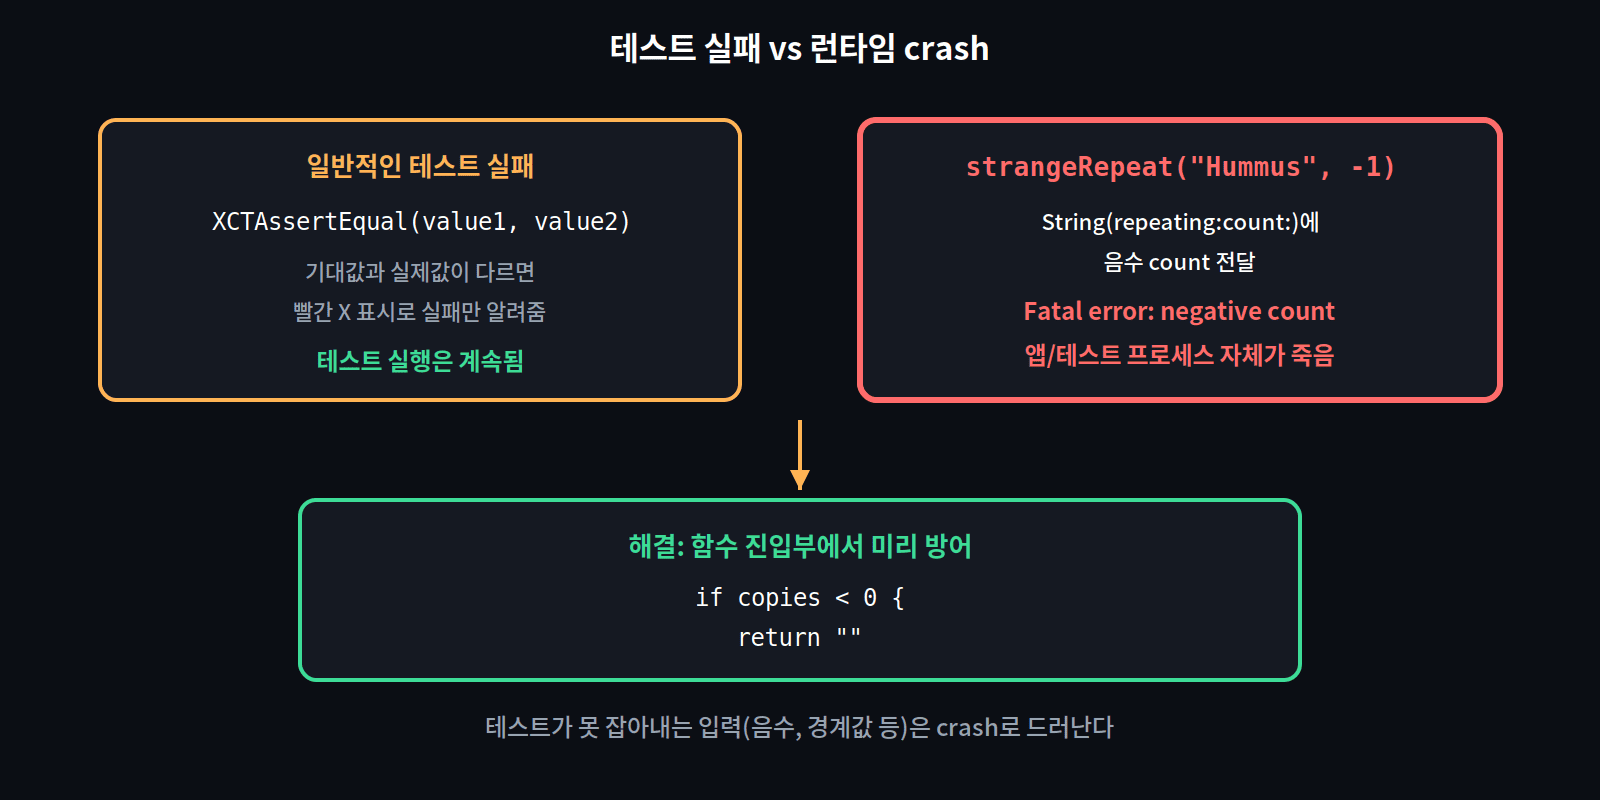
strangeRepeat 내부에서 쓰는 String(repeating:count:)가 음수 count를 받으면 “negative count”라는 fatal error를 던지면서 그 자리에서 프로세스를 종료시켜버린 것이다. 이건 일반적인 XCTAssertEqual 실패(빨간 X 표시로 알려주고 나머지 테스트는 계속 진행되는)와는 차원이 다른 문제다. XCTAssertEqual이 틀렸다고 알려주는 건 “값이 기대와 다르다”는 신호지만, fatal error로 인한 crash는 그 지점에서 프로그램 실행 자체가 멈춰버리는 훨씬 심각한 상황이다.
함수를 고쳐서 방어하기
copies가 음수일 수 있다는 걸 함수가 전혀 고려하지 않고 있었다는 뜻이다. 두 가지 선택지가 있었다.
strangeRepeat의 반환 타입을String?(optional)로 바꿔서, 음수인 경우nil을 반환하게 만들기- 반환 타입은 그대로 두고, 음수인 경우 그냥 빈 문자열을 반환하도록 함수 초반에 방어 코드를 추가하기
기존에 이미 여러 View에서 strangeRepeat을 String(non-optional) 반환으로 가정하고 쓰고 있었기 때문에, 지금 와서 optional로 바꾸면 그 View들도 전부 손봐야 한다. 그래서 당장은 더 간단한 두 번째 방법을 택했다.
1
2
3
4
5
6
7
func strangeRepeat(text: String, copies: Int) -> String {
    if copies < 0 {
        return ""
    }

    // ... 기존 로직
}
함수 진입부에서 copies < 0을 바로 확인해서 ""를 반환하고 종료한다. 이게 최선의 설계라고 확신하지는 못하지만(“optional로 만드는 게 더 나은 선택일 수도 있다”고 직접 언급했다), 일단 crash는 막아야 하니 실용적인 선택을 한 것이다. 이 수정 후 다시 테스트를 돌려보니 통과했다.
이 경험은 unit test의 진짜 가치를 보여주는 사례이기도 하다. 미리 생각하지 못했던 입력값(음수 copies)을 테스트 케이스로 일부러 넣어보지 않았다면, 이 crash는 실제 사용자가 슬라이더를 조작하다가 우연히 마주쳤을 수도 있다.
testReverseSplit 작성하기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
// reverseSplit( name: String, q: Int) -> String?
func testReverseSplit() {
    // Setup data
    let data: [(name: String, q: Int)] = [
        ("Hummus", -1),
        ("Hummus", "Hummus".count),
        ("Hummus", 5),
        ("Hummus", 4),
        ("Hummus", 3),
        ("Hummus", 2),
        ("Hummus", -15),
    ]

    // Expected values
    let expectedValues: [String?] = [
        nil,
        nil,
        "ummuH s",
        "mmuH su",
        "muH sum",
        "uH summ",
        nil,
    ]

    // Run tests
    for i in 0..<data.count {
        let value1 = part1Problems
            .reverseSplit(name: data[i].name, q: data[i].q)
        let value2 = expectedValues[i]
        XCTAssertEqual(value1, value2, "!!!!! Issue at test \(i) comparing \(String(describing: value1)) and \(String(describing: value2)) !!!!!")
    }
}
여기서 눈여겨볼 부분은 두 번째 케이스다. q값을 매직 넘버로 하드코딩하는 대신 "Hummus".count로 직접 계산해서 넣었다. reverseSplit의 스펙상 q는 name의 길이보다 반드시 작아야 하니, q == name.count인 경계값은 유효하지 않은 입력이라 nil이 기대값이다. 이렇게 매직 넘버 대신 실제 계산식을 쓰면, 나중에 테스트용 문자열("Hummus")을 바꾸더라도 q 값을 손으로 다시 계산할 필요 없이 자동으로 맞춰진다.
q가 -1이거나 -15처럼 큰 음수여도 결과는 똑같이 nil이어야 한다는 것도 함께 확인한다. reverseSplit은 애초에 q < 0이면 nil을 반환하도록 구현되어 있었으니, 이 케이스들은 새로운 버그를 찾기 위한 것이라기보다는 기존 유효성 검사 로직이 여러 음수 값에 대해 일관되게 동작하는지 재확인하는 차원이다.
reverseSplit은 앞서 UI(ReverseSplitView)에서도 슬라이더 범위 crash를 겪었던 함수인데, 여기서는 함수 자체의 로직은 이미 견고하게 구현되어 있어서 별도의 fatal error 없이 테스트가 바로 통과했다.
XCTest를 하는 이유
위와같이 여러 과정을 통해 XCTest를 진행해보았다. 그렇다면 왜 시뮬레이터에서 해도 되는부분을 XCTest를 통해서 별도로 진행하는걸까??
시뮬레이터에서 앱을 직접 눌러보는 것과 XCTest로 검증하는 것, 둘 다 결국 “로직이 맞게 동작하는지 확인한다”는 목적은 같다. 하지만 이 둘은 세 가지 축에서 근본적으로 다르다.
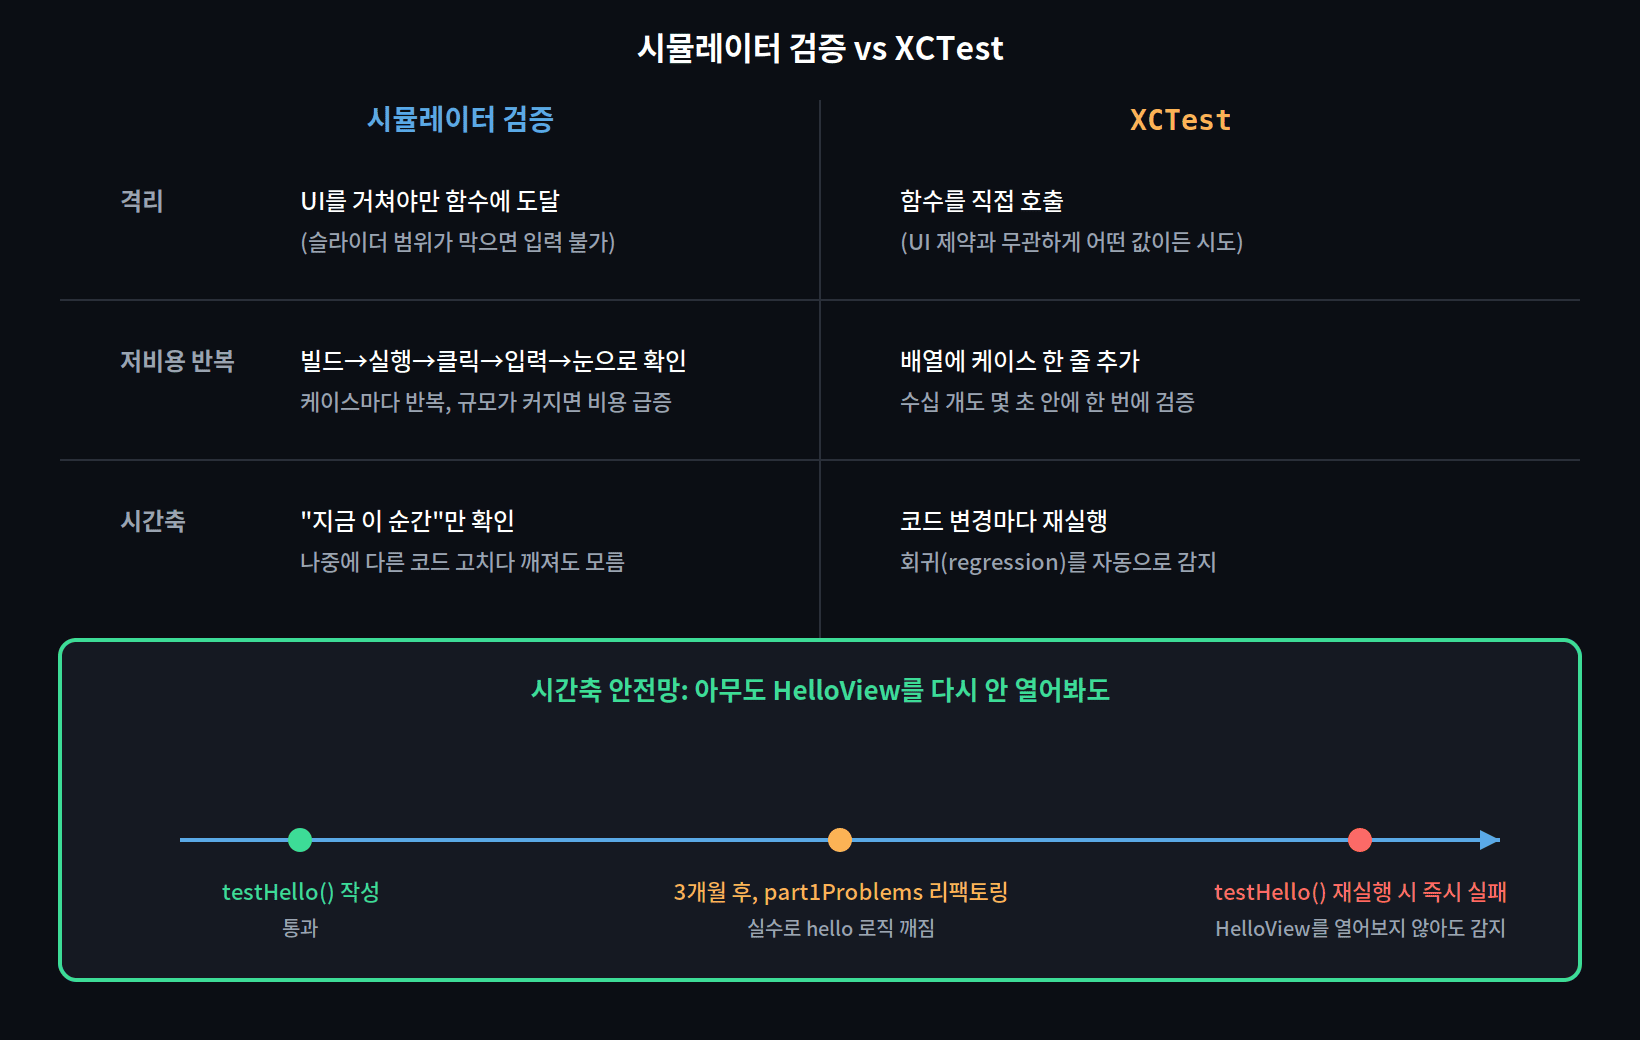
1. 격리: UI를 거치지 않고 함수에 직접 접근
시뮬레이터로 함수를 검증하려면 반드시 UI를 경유해야 한다. 그런데 UI 자체가 입력을 미리 제한해두면(예: StrangeRepeatView의 슬라이더가 1...maxCopies 범위로 막혀있던 것처럼), 그 범위를 벗어나는 값은 UI로는 애초에 시도해볼 방법이 없다. 실제로 strangeRepeat(text:copies:)가 음수 copies에 crash하는 버그는, 슬라이더가 음수를 절대 내보내지 않는 구조라 시뮬레이터로는 발견이 불가능했다.
XCTest는 part1Problems.strangeRepeat(text: "Hummus", copies: -1)처럼 UI를 완전히 건너뛰고 함수를 직접 호출한다. UI가 어떤 제약을 걸어뒀든 상관없이, 함수 자체가 어떤 입력에도 안전한지를 따로 검증할 수 있다.
2. 저비용 반복: 케이스를 늘리는 데 드는 비용
시뮬레이터로 케이스 하나를 확인하려면 빌드 → 실행 → 화면 클릭 → 값 입력 → 눈으로 결과 확인, 이 과정을 케이스마다 반복해야 한다. 앱 규모가 커질수록, 그리고 검증해야 할 화면이 많아질수록 이 비용은 선형이 아니라 훨씬 가파르게 늘어난다.
XCTest는 data 배열에 한 줄 추가하는 것만으로 케이스가 늘어난다. testNumberDivisibleByNOptional()에서처럼 케이스 4개를 배열 하나에 몰아넣고 반복문으로 한 번에 검증하는 식이라, 수십 개의 케이스를 추가해도 실행 시간은 여전히 몇 초 안팎이다. 앱 규모가 작을 때는 시뮬레이터로도 충분히 검증 가능하지만, 볼륨이 큰 앱에서 새로 추가한 로직 하나를 검증할 때는 그 로직만 모듈처럼 떼어내서 빠르게 확인할 수 있다는 게 XCTest의 실질적인 이점이다.
3. 시간축: 회귀(regression)를 자동으로 감지하는 안전망
시뮬레이터 검증은 “지금 이 순간” 눈으로 확인하는 작업이다. 오늘 HelloView가 정상 동작하는 걸 확인했다고 해도, 3개월 뒤에 part1Problems를 리팩토링하다가 실수로 hello 로직이 깨지면 그 사실을 알아챌 방법이 없다. 그날 작업 중인 게 TrapezoidView나 ReverseSplitView라면, HelloView를 다시 열어볼 이유 자체가 없기 때문이다.
testHello()가 있으면 다르다. 코드를 고칠 때마다 테스트를 재실행하기만 하면, 아무도 HelloView를 직접 열어보지 않아도 hello 함수가 예전과 같은 방식으로 동작하는지 자동으로 재확인된다. 이게 바로 unit test가 “지금 맞는지 확인”을 넘어 “앞으로도 계속 맞는지 감시”하는 안전망 역할을 하는 지점이다.
정리
XCTest가 버그를 마법처럼 찾아주는 도구는 아니다. copies가 -1일 수 있다는 걸 떠올리고 그 값을 테스트 데이터에 적어넣은 건 결국 사람이다. XCTest의 진짜 가치는, 사람이 떠올린 의심스러운 케이스를 UI 제약 없이, 낮은 비용으로, 코드가 바뀔 때마다 반복해서 검증할 수 있게 해준다는 데 있다. 즉 “로직을 UI 없이 격리해서 교차검증”하는 도구이면서, 동시에 “한 번 작성해두면 이후 변경 사항이 기존 동작을 깨뜨리지 않았는지 자동으로 재확인해주는” 시간축 위의 안전망이다.